注: 以下の翻訳の正確性は検証されていません。AIPを利用して英語版の原文から機械的に翻訳されたものです。
評価
_評価_は、特定のモデルバージョンが所定のテストデータに対してどのような性能を発揮するかを示す、メトリクス、画像、プロット、テーブルをまとめたものです。開発者は評価ロジックを定義して、これらの結果をモデルに関連付けられた評価セットに書き込むことができます。結果はモデルページで可視化して比較できます。
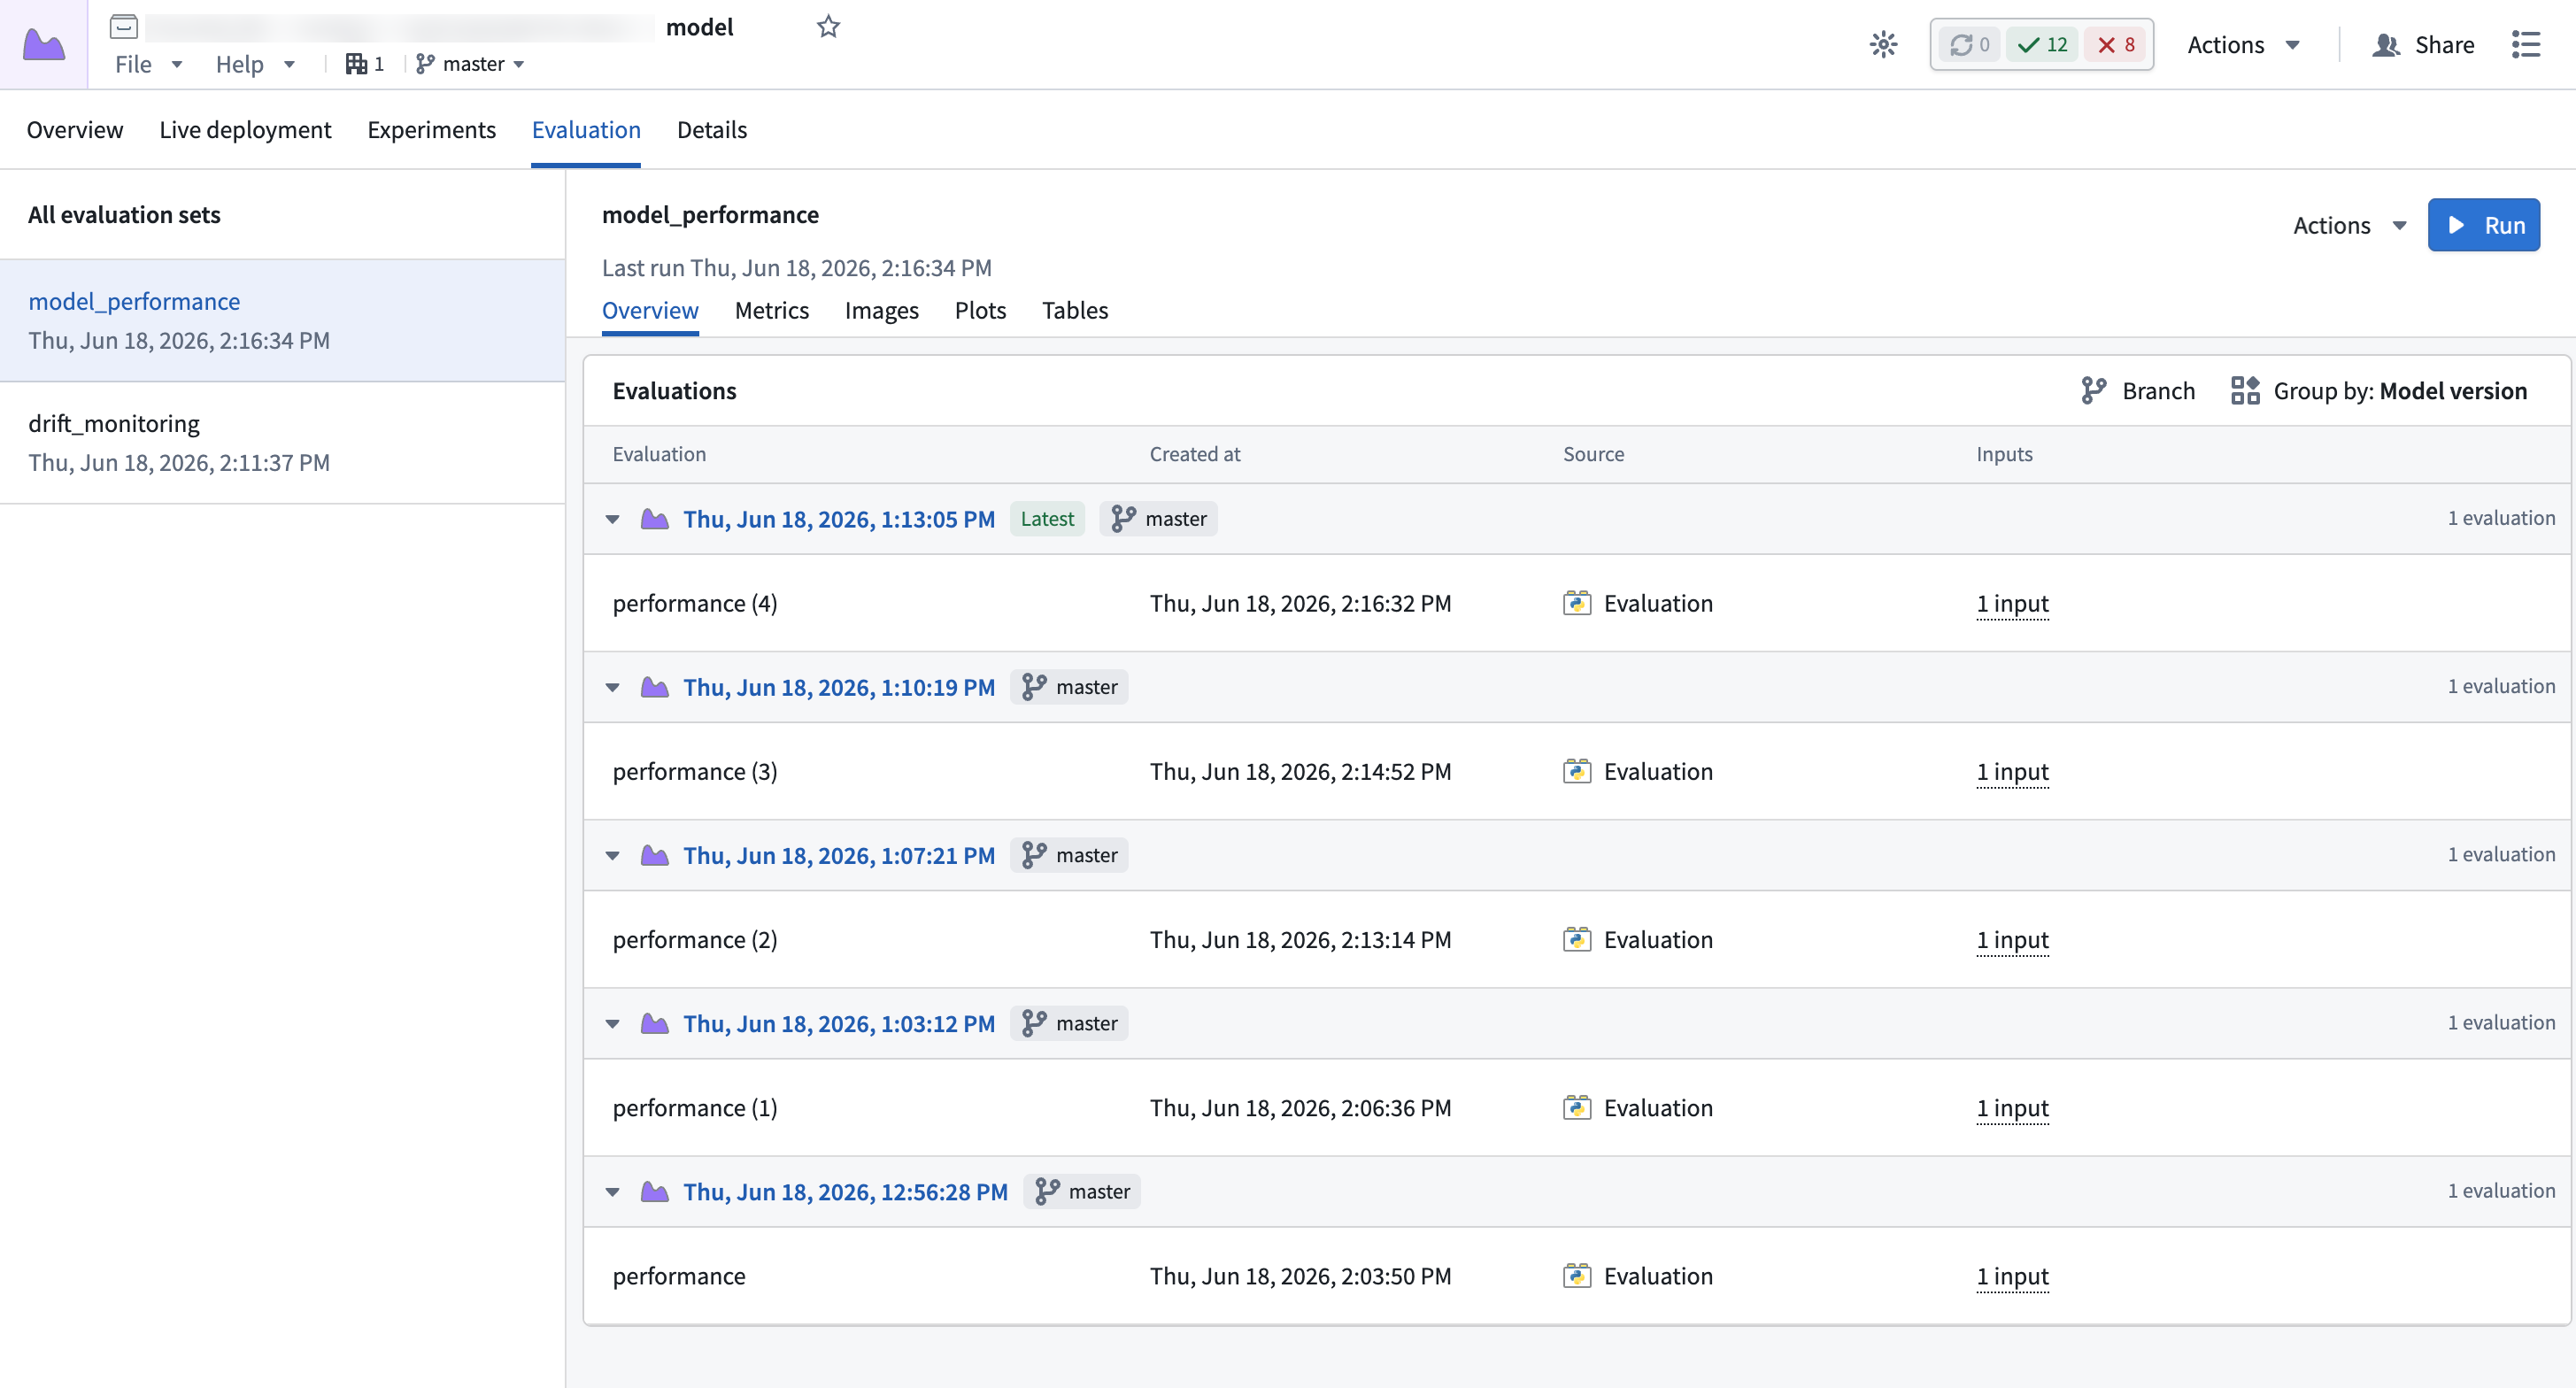
すべての評価が単一のモデルバージョンに関連付けられているため、評価セットを使うと、モデルの再学習に伴ってメトリクスがバージョン間でどのように変化するかを追跡できます。
評価セット
_評価セット_は、同じ手法を共有する評価を論理的にグループ化したものです。すべての評価は常に評価セットに関連付けられます。評価セットには、その手法によって生成されたすべてのモデルバージョンの評価が保持されるため、モデルの再学習に伴って同じ分析を比較できます。モデルには最大100個の評価セットを設定できます。
Code Repositories では、@pm.transforms.evaluation デコレーターによって、このグループ化が適用されます。セット名がトランスフォーム定義で固定されているため、そのトランスフォームを実行するたびに、比較可能な新しい評価が同じセットに書き込まれます。別の方法でモデルを評価するには、異なるセット名を持つ別のトランスフォームを定義します。
たとえば、住宅価格を予測する回帰モデルには、次の2つの異なる評価セットを設定できます。
- 全国の誤差分析: すべての予測にわたって集計した誤差メトリクス(平均絶対誤差、R²)を評価します。
- 価格帯別分析: 価格帯(低価格、中価格、高価格)別に誤差メトリクスを評価します。各価格帯の残差分布プロットも含めることで、モデルが特定の価格帯で系統的に過大予測または過小予測しているかどうかを明らかにします。
評価を作成する
Code Repositories でモデルのインポートと使用に使う ModelInput クラスには、評価を作成するためのフックが用意されています。評価ロジックを書く前に、コードリポジトリをアップグレードし、palantir_models ライブラリを >= 0.2384.0 にアップグレードしてください。
Copied!1 2 3 4 5 6 7 8 9 10 11 12 13from transforms.api import transform, Input import palantir_models as pm from palantir_models.transforms import ModelInput # 評価を作成するには、このデコレーターを適用する必要があります。 # このデコレーターは、モデル入力で書き込み先となる評価セットを示します。 @pm.transforms.evaluation("error_analysis") @transform.using( input_data=Input("..."), model_input=ModelInput("..."), ) def compute(input_data, model_input): evaluation = model_input.create_evaluation(name="my-evaluation")
評価名は一意である必要はありません。再使用された名前は自動的に一意になるため、評価の名前を変更せずに同じコードを複数回実行できます。名前を指定しない場合は、評価セット名が使用されます。
評価は既存の Python トランスフォームの基盤上に構築されているため、ビルドに成功すると、モデル入力の評価セットに評価が自動的にコミットされます。ビルドに失敗した場合、評価は中止され、結果は公開されません。
評価ロジックを記述するコードリポジトリは、評価対象のモデルと同じプロジェクト内にある必要があります。評価対象のモデルバージョンを制御する方法を含む完全な例については、評価を作成して実行するを参照してください。ロジックを自分で記述せずに、回帰モデルおよび機密情報区分モデルの標準的なメトリクスを記録するには、組み込みの評価ツールを参照してください。また、評価ビューの アクションドロップダウンメニューを使って、評価ロジックをスケジュールに従って実行するように設定することもできます。
ログ記録
評価では、メトリクス、画像、プロット、テーブルの4種類のログをサポートしています。
サブセット
サブセットを使うと、prefix/name という命名規則で、関連するメトリクス、画像、プロット、テーブルをまとめてグループ化できます。このパターンに従うログは、UI で prefix または value によってグループ化できるため、異なるセグメントや条件間で同じメトリクスを簡単に比較できます。
Copied!1 2 3 4 5 6 7 8 9 10 11 12 13 14 15# これらの3個のメトリクスは自動的に「nationwide」の下にグループ化されます。 evaluation.log_metrics({ "nationwide/mae": 14250.0, "nationwide/r2": 0.91, }) # これらはそれぞれのリージョンの接頭辞の下にグループ化されます。 evaluation.log_metrics({ "northeast/mae": 12100.0, "northeast/r2": 0.93, "southeast/mae": 13800.0, "southeast/r2": 0.90, "west/mae": 16500.0, "west/r2": 0.88, })
同じパターンが画像、プロット、テーブルにも適用されます。
Copied!1 2 3 4# 価格帯でグループ化された残差プロット evaluation.log_plot("affordable/residuals", affordable_fig) evaluation.log_plot("mid_range/residuals", mid_range_fig) evaluation.log_plot("luxury/residuals", luxury_fig)
接頭辞は任意です。システムは最初の / より前の部分全体を使ってグループ化します。データをサブセットに分割するロジックは、完全に自由に定義できます。
メトリクスを記録する
メトリクスは、Evaluation.log_metric 関数と Evaluation.log_metrics 関数を使って記録できます。メトリクスの値は数値(int または float)である必要があります。
Copied!1 2 3 4 5evaluation.log_metric("mae", 14250.0) evaluation.log_metrics({ "mae": 14250.0, "r2": 0.91, })
画像を記録する
画像は、Evaluation.log_image を使って記録できます。画像は PNG 形式または Pillow ↗ の画像である必要があります。それ以外の画像形式は拒否されます。
Copied!1 2 3 4 5 6 7evaluation.log_image("residual_distribution", pillow_image) evaluation.log_image("predicted_vs_actual", image_bytes_arr) evaluation.log_image( "error_heatmap", "path/to/image.png", caption="Geographic error heatmap", )
画像のログ記録は、カスタムチャートを記録する方法としても利用できます。
Copied!1 2 3 4 5 6 7import matplotlib.pyplot as plt plt.scatter(predicted_prices, residuals) plt.xlabel("Predicted Price") plt.ylabel("Residual") plt.savefig("path/to/residuals.png") evaluation.log_image("residual_scatter", "path/to/residuals.png")
プロットを記録する
プロットは、Evaluation.log_plot を使って記録できます。プロットは Plotly ↗ の plotly.graph_objects.Figure として指定する必要があります。それ以外の種類のプロットは拒否されます。
Copied!1 2 3 4 5 6 7 8 9import plotly.express as px fig = px.box(df, x="price_tier", y="residual", title="Residuals by Price Tier") evaluation.log_plot("residuals_by_tier", fig) evaluation.log_plot( "predicted_vs_actual", fig, description="Predicted vs. actual prices across all tiers", )
テーブルを記録する
テーブルは、Evaluation.log_table を使って記録できます。指定するテーブルは、pandas ↗ または Polars ↗ の DataFrame である必要があります。それ以外のデータ型は拒否されます。
Copied!1 2 3 4 5 6 7 8 9import pandas as pd error_by_tier = pd.DataFrame({ "price_tier": ["affordable", "mid_range", "luxury"], "mae": [8200.0, 15400.0, 42300.0], "r2": [0.94, 0.91, 0.87], }) evaluation.log_table("error_by_price_tier", error_by_tier)
制限
次のテーブルに、Foundry の評価に関する制限を示します。
| 説明 | 制限 |
|---|---|
| メトリクス名の最大文字数 | 100文字 |
| 画像、プロット、テーブルの名前の最大文字数 | 100文字 |
| 画像キャプションの最大文字数 | 200文字 |
| 画像、プロット、テーブルあたりの最大アップロードサイズ | 5 MB |
| テーブルあたりの最大行数 | 100,000 |
| モデルあたりの最大評価セット数 | 100 |
これらの上限を引き上げるには、Palantir サポートにお問い合わせください。
詳細については、モデル評価の Python API リファレンスを参照してください。