注: 以下の翻訳の正確性は検証されていません。AIPを利用して英語版の原文から機械的に翻訳されたものです。
ライブデプロイのコンピュート使用量
Foundry Machine Learning のライブデプロイは、モデルリリースを対象とする永続的でスケーラブルなデプロイであり、API エンドポイントを介して操作できます。ライブデプロイは、受信トラフィックに迅速に応答できるよう、専用のコンピュートリソースを継続的に予約します。そのため、ライブデプロイをホストすると、デプロイがアクティブな間は Foundry のコンピュート秒を使用します。
以下のドキュメントでは、Modeling Objective を元にしたライブデプロイのみを説明します。JavaScript の関数ベースのデプロイも、直接デプロイも、ここでは説明しません。直接デプロイは Compute Modules を元にしているため、対応する原則に従います。ただし、コンテナベースのモデルではデプロイとモデルの両方のリソースが必要であるという注意点は、引き続き適用されます。
ライブで実行している場合、Foundry Machine Learning のコンピュート使用量は Modeling Objective 自体に帰属し、その Modeling Objective を含むプロジェクトのレベルで集計されます。Foundry におけるコンピュート秒の定義や、使用量の計算に用いる数式の根拠について詳しくは、使用量の種類のドキュメントをご覧ください。
コンピュート秒を測定する
Foundry Machine Learning のライブデプロイは、Foundry のポッドベースの計算クラスターで実行される専用の「レプリカ」上にインフラストラクチャをホストします。各レプリカには、vCPU 数と RAM の GiB 数で測定される計算リソースが割り当てられます。各レプリカはモデルをローカルにホストし、計算リソースを使用して受信リクエストを処理します。
コンテナベースのモデルの場合、各レプリカには、コンテナのモデルバージョンのランタイム設定で指定された専用の GPU または vCPU リソースを持つコンテナが付属します。
Modeling Objective にインポートされた Foundry Machine Learning のライブデプロイは、受信するリクエスト数に関係なく、アクティブな間はコンピュート秒を使用します。デプロイは開始されると「アクティブ」とみなされ、グラフィカルインターフェースまたは API を介してシャットダウンされるまで「アクティブ」のままです。ライブデプロイに関連付けられている Modeling Objective がプラットフォームのゴミ箱に移動されると、ライブデプロイはシャットダウンされます。一方、Modeling Objective ではなくモデルリソースから開始された直接デプロイは、リクエスト量に基づいて自動スケーリングし、使用されていないときの最小レプリカ数を0に設定できます。Modeling Objective からのライブデプロイと直接デプロイの違い、および直接デプロイの自動スケーリング動作について詳しくはこちらをご覧ください。
ライブデプロイが使用するコンピュート秒数は、主に次の3つの要因に依存します。
- レプリカあたりの vCPU 数
- ライブデプロイでは、vCPU はミリコア単位で測定されます。1ミリコアは vCPU の1/1000です
- レプリカあたりの RAM の GiB 数
- レプリカあたりの GPU 数
- レプリカ数
- デプロイ内の各レプリカは、同じ vCPU 数と RAM の GiB 数を持ちます
Foundry の使用量に対して支払う場合、デフォルトの使用量レートは次のとおりです。
Palantir とエンタープライズ契約を結んでいる場合、使用量レートの倍率は、以下に記載されているデフォルトのレートと異なる場合があります。コンピュート使用量の計算を進める前に、Palantir の担当者にお問い合わせください。
| vCPU / GPU | 使用量レート |
|---|---|
| vCPU | 0.2 |
| T4 GPU | 1.2 |
| A100 GPU | 1.3 |
| L4 GPU | 2.1 |
| A10G GPU | 1.5 |
| V100 GPU | 3 |
| H100 GPU | 4.7 |
| H200 GPU | 4.7 |
| B200 GPU | 5.7 |
| B300 GPU | 7.1 |
| RTX PRO 6000 GPU | 3.5 |
これらは、Foundry の並列コンピュートフレームワークにおいて、ライブモデルがプロファイルに基づいてコンピュートを使用するレートです。
次の数式で vCPU のコンピュート秒を測定します。
live_deployment_vcpu_compute_seconds = max(vCPUs_per_replica, GiB_RAM_per_replica / 7.5) * num_replicas * live_model_vcpu_usage_rate * time_active_in_seconds
次の数式で GPU のコンピュート秒を測定します。
live_deployment_gpu_compute_seconds = GPUs_per_replica * num_replicas * live_model_gpu_usage_rate * time_active_in_seconds
Modeling Objective の使用量を調査する
プラットフォーム内のすべてのコンピュート秒の使用量は、Resource Management アプリケーションで確認できます。
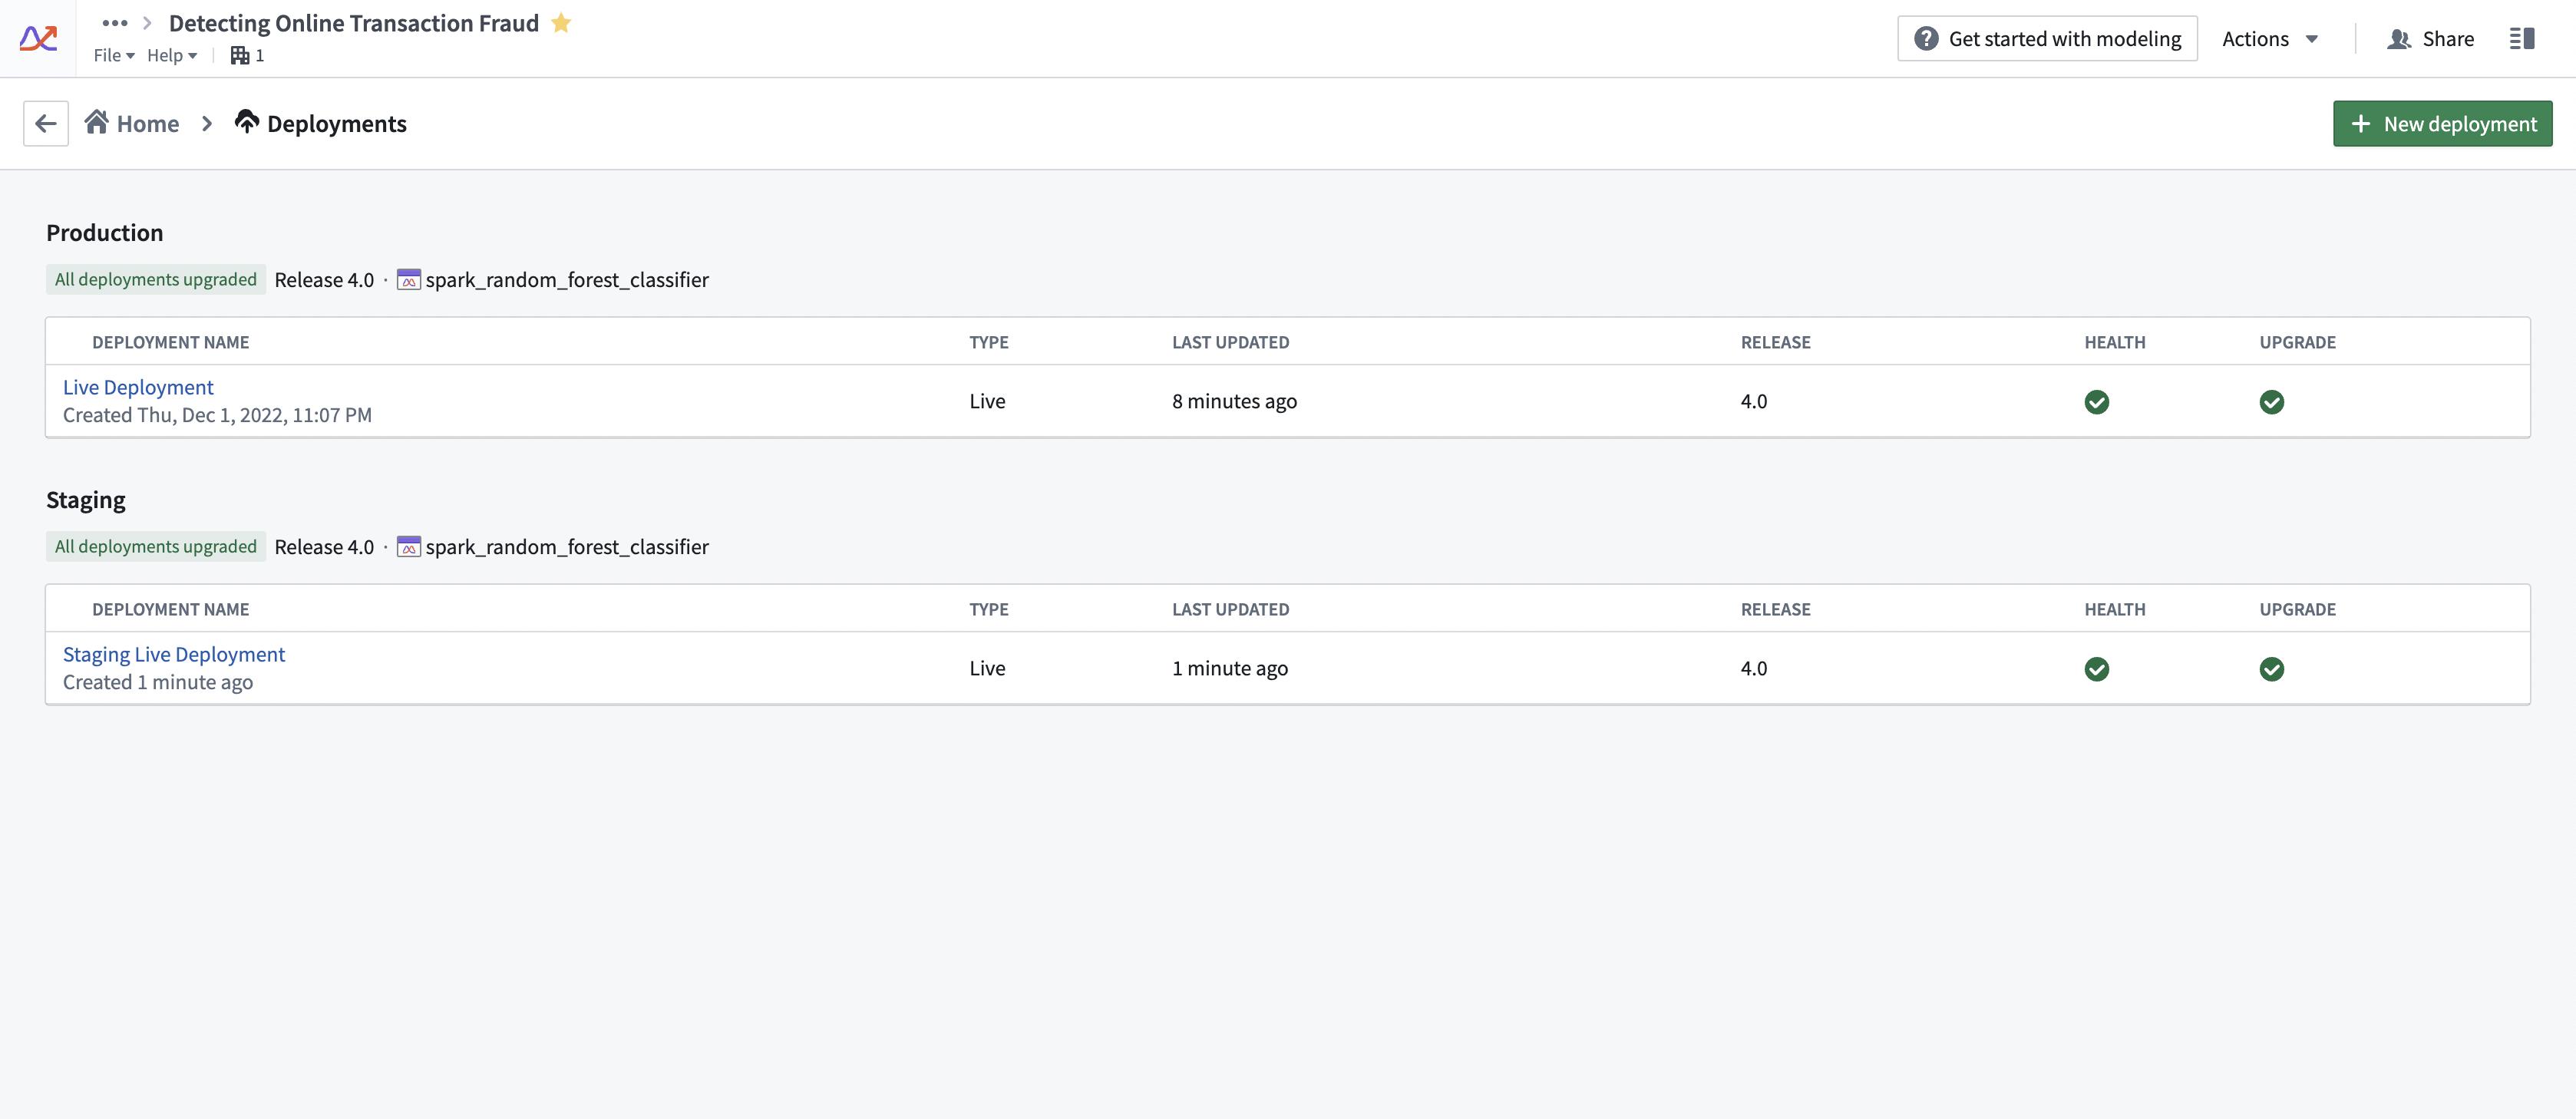
デプロイのコンピュート使用量は、そのデプロイ元の Modeling Objective に関連付けられます。任意のオブジェクティブで、複数のライブデプロイをアクティブにできます。Modeling Objective のライブデプロイは、デプロイセクションで確認できます。例として、以下のスクリーンショットをご覧ください。
使用量が増減する要因
ライブデプロイは、アクティブな間はコンピュート秒を使用します。次の方策は、デプロイ全体の使用量を制御するのに役立ちます。
- 想定するリクエスト負荷に合わせて、デプロイが適切に調整されていることを確認してください。デプロイは、想定される同時リクエスト数のピークに合わせて調整する必要があります。デプロイのリソースが不足していると、リクエストに対して失敗のレスポンスを返すようになります。ただし、デプロイに過剰なリソースを割り当てると、必要以上のコンピュート秒を使用する可能性があります。
- ライブデプロイの管理者は、運用上重要な環境にモデルをデプロイする前に、ライブデプロイのエンドポイントに対してストレステストを実施し、適切なリソース設定を特定することを推奨します。
- ライブデプロイは、明示的に停止またはキャンセルされるまで実行されます。不要になったデプロイが誤って実行されたままにならないよう、ライブデプロイの使用量を監視することが重要です。このような状況は、ステージング環境のデプロイでよく発生します。
- プロファイルを変更せずにデプロイへの API 負荷を増減させても、コンピュート使用量には影響しません。ライブデプロイは、使用するコンピュート秒数を変えることなく、リソースが許容する限りのリクエストを処理します。
使用量を設定する
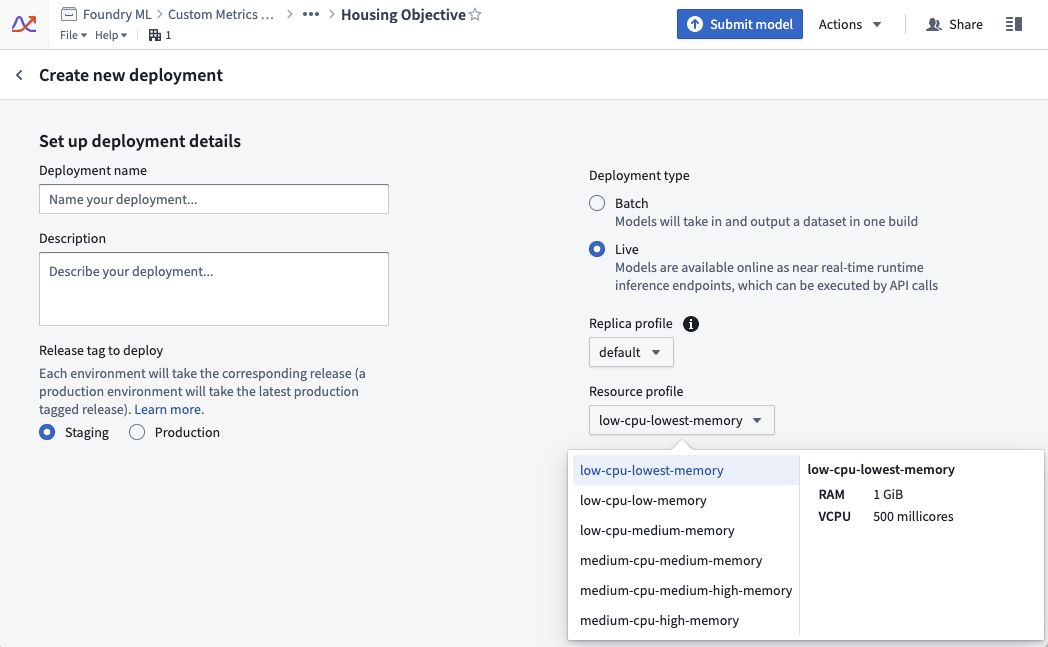
ライブデプロイのリソース使用量は、そのプロファイルによって定義されます。プロファイルはライブデプロイの作成時に設定できます。デプロイがアクティブな間でも、プロファイルを変更できます。デプロイには、ダウンタイムなしで更新されたプロファイルが自動的に適用されます。
使用量を管理する
リソースキューを通じてコンピュートを管理するエンロールメントでは、Resource Management の管理者は、以下のステップで特定のキュー内で現在実行されているライブデプロイを確認できます。
- Resource Management アプリケーションを開きます。
- リソースキューを選択します。
- 左側のサイドバーからキューを選択します。
- ページ中央の連続計算タブを選択します。
- 右端のフィルターアイコンを選択し、ライブデプロイで絞り込みます。
使用量の計算例
例1:vCPU コンピュート
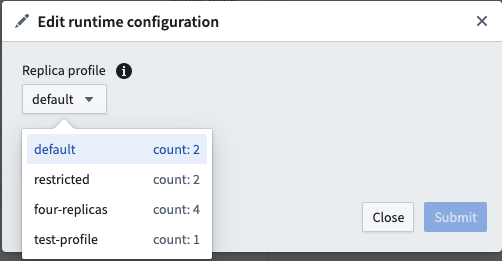
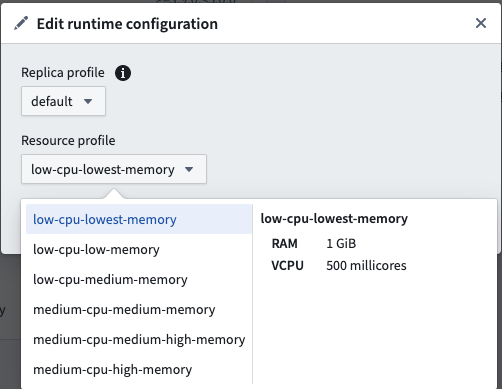
次の例は、2個のレプリカからなるデフォルトのレプリカプロファイルを持ち、「low-cpu-lowest-memory」プロファイルで20秒間アクティブなライブデプロイを示しています。
resource_config:
    num_replicas: 2
    vcpu_per_replica: 0.5 vCPU
    GiB_RAM_per_replica: 1 GiB
seconds_active: 20 seconds
live_model_vcpu_usage_rate: 0.2

compute seconds = max(vcpu_per_replica, GiB_RAM_per_replica / 7.5) * num_replicas * live_model_vcpu_usage_rate * time_active_in_seconds
                = max(0.5vCPU, 1GiB / 7.5) * 2replicas * 0.2 * 20sec
                = 0.5 * 2 * 0.2 * 20
                = 4 compute-seconds
例2:GPU コンピュート
次の例は、ライブデプロイの使用量レートを示しています。このライブデプロイは、2個のレプリカからなるデフォルトのレプリカプロファイルを持ち、GPU V100 プロファイルで20秒間アクティブです。
resource_config:
    num_replicas: 2
    gpu_per_replica: 1 V100 GPU
seconds_active: 20 seconds
live_model_gpu_usage_rate: 3

compute seconds = gpu_per_replica * num_replicas * live_model_gpu_usage_rate * time_active_in_seconds
                = 1 * 2replicas * 3 * 20sec
                = 1 * 2 * 3 * 20
                = 120 compute-seconds
例3:コンテナベースのモデルのコンピュート
Deployment resource_config:
    num_replicas: 2
    vcpu_per_replica: 0.5 vCPU
    GiB_RAM_per_replica: 1 GiB

Model image resource_config:
    CPU: 4 cores
    Memory: 30 GiB

seconds_active: 20 seconds
live_model_vpcu_usage_rate: 0.2

total compute seconds = (compute seconds deployment resource) + (compute seconds model resource)

compute seconds deployment resource = max(vcpu_per_replica, GiB_RAM_per_replica / 7.5) * num_replicas * live_model_vcpu_usage_rate * time_active_in_seconds
                = 0.5 * 2replicas * 0.2 * 20sec
                = 0.5 * 2replicas * 0.2 * 20sec
                = 4 compute seconds

compute seconds model resources = max(cores, Memory / 7.5) * num_replicas * live_model_vcpu_usage_rate * time_active_in_seconds
compute seconds model resources = 30 / 7.5 * 2 * 0.2 * 20
compute seconds model resources = 32 compute seconds

total compute seconds = 36 compute seconds