注: 以下の翻訳の正確性は検証されていません。AIPを利用して英語版の原文から機械的に翻訳されたものです。
3. チュートリアル - Modeling Objectives アプリケーションでモデルを評価する
このチュートリアルを開始する前に、モデリングプロジェクトのセットアップを完了し、Jupyter® ノートブックまたは Code Repositories でモデルをトレーニングしておく必要があります。この時点で、モデリング目標に1つ以上のモデルがあるはずです。
チュートリアルのこのステップでは、モデルの性能を評価し、モデリング目標でそのモデルをリリースします。このステップの実施を推奨しますが、このチュートリアルの後続のステップには影響しないため、後で戻って実施することもできます。ここでは、次の内容を扱います。
3.1 モデリング目標とは
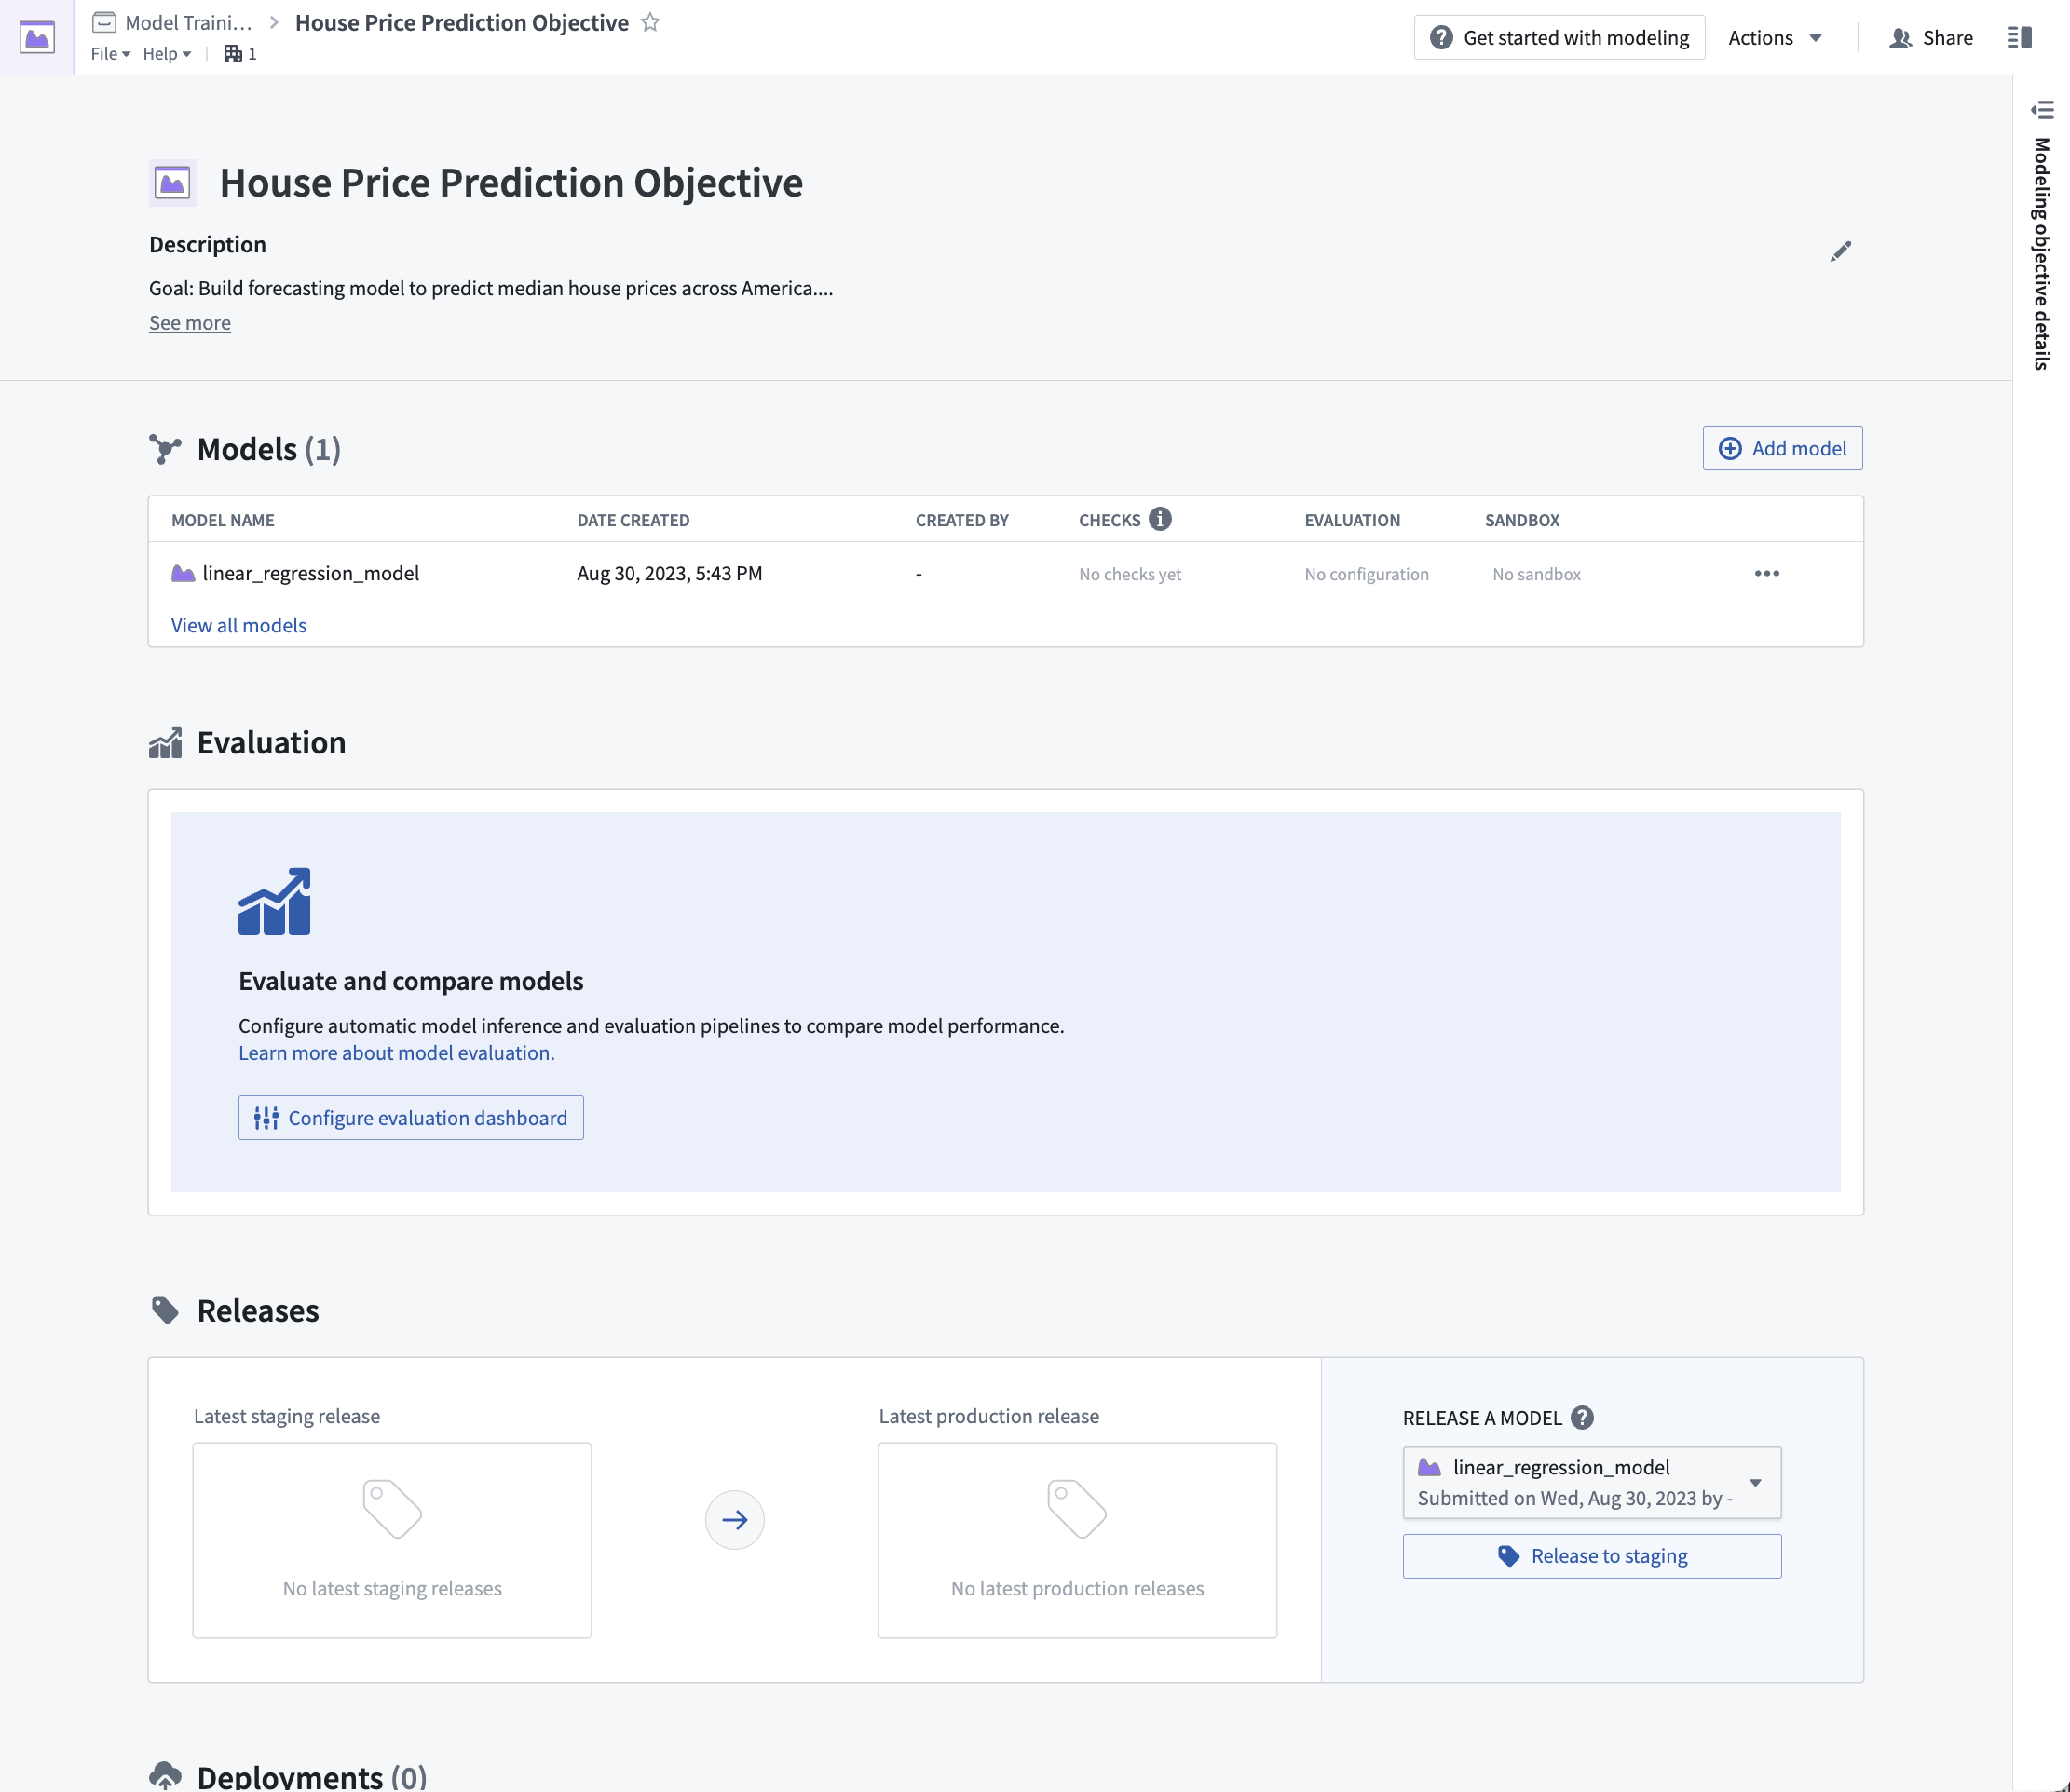
モデリング目標は、本番環境での利用に適した候補モデルバージョンのカタログと考えることができます。モデリング目標にモデルを登録すると、そのカタログにモデルが追加され、特定のモデリング課題や目標のコンテキストで評価やレビューを行えるようになります。登録されたモデルは、最終的に本番環境に導入されるかどうかにかかわらず、モデリングプロジェクトの進行状況を把握するのに役立ち、プロジェクト領域での実験や学習の履歴を保持します。
チュートリアルのこのステップで必須の操作はありません。
3.2 自動モデル評価を設定する方法
モデリング目標にモデル候補が追加されたので、このモデリング目標内でモデルのパフォーマンスメトリクスを生成し、モデルの性能を評価できます。パフォーマンスメトリクスは、モデルの性能や、モデルがそのように動作する理由を理解するための重要なツールです。
このチュートリアルの目的は数値(米国の国勢調査区における平均住宅価格)を推定することなので、このモデリングの問題は回帰モデリングの問題に分類できます。回帰モデリングの問題では、平均絶対誤差や二乗平均平方根誤差などの評価メトリクスを確認するのが一般的です。これらを含むメトリクスは Foundry のデフォルトの回帰評価ツールに含まれているため、このライブラリを使用して送信したモデルの性能を評価します。
アクション: モデリング目標から、評価ダッシュボードの設定を選択します。


モデル評価を設定する
自動モデル評価は、標準化された方法でモデルを評価するために役立ちます。標準化によって一貫したモデル比較ができるため、本番環境で使用するのに最適なモデルを自信を持って選択できます。
評価パイプライン管理が有効になっている場合、Foundry はモデル送信と評価用データセットの組み合わせごとに、推論データセットを1個自動生成します。推論データセットは、評価用データセットに対してモデルの推論(予測の生成)を実行した結果です。評価用データセットは、モデルの標準化されたテストセットとしてユーザーが定義するもので、特徴量(予測の生成に使用)とラベル(モデルの推論と正解ラベルの比較に使用)の両方が必要です。
アクション: パイプライン管理を設定するには、編集を選択し、次の2つのオプションを両方選択します。推論とメトリクスのパイプラインを生成とモデル送信時に推論とメトリクスを自動的に実行です。次に、保存してパイプライン管理の設定を確定します。

アクション: 評価用データセットを設定するには、評価用データセットを追加を選択し、モデルのトレーニングのチュートリアルで作成した housing_test_data データセットを評価用データセットとして選択します。推論の宛先とメトリクスの宛先として data フォルダーを選択します。データセットとフォルダーを選択を選択して確定します。

評価ライブラリを設定する
評価ライブラリは、パラメーターを設定できる Foundry ライブラリです。推論データセットを受け取り、モデリング目標の評価ダッシュボードに追加する評価メトリクスを生成できます。Foundry には、回帰と二値分類用のデフォルトの評価ライブラリが用意されていますが、特定のモデリングの問題に合わせてカスタム評価ライブラリを作成することもできます。
このモデリング目標に追加されたすべてのモデルを評価するには、送信するすべてのモデルで一貫した方法で評価スコアを生成する必要があります。このモデリング目標では、すべてのモデルが prediction という名前の float 型の推論列を生成することを前提とします。
アクション: 評価ライブラリを選択を選択し、次に回帰のデフォルトライブラリを選択します。inference_field を float 型の prediction に、actual_field(推定対象のプロパティ)を median_house_value に設定し、histogram_bins は空のままにします。保存して評価ライブラリの設定を保存します。

評価サブセットを設定する
評価サブセットの設定は、モデル評価における任意のステップです。評価データの特定の部分について、メトリクスを個別に生成できます。これらのメトリクスは、すべて評価ダッシュボードで個別に分析できます。
次の場合は、評価サブセットを有効にすると役立ちます。
- データの中に、ほかのセグメントよりもモデルの性能が高いセグメントがあるかどうかを把握したい場合です。これにより、本番環境でこのモデルを使用すべき範囲を判断できます。
- モデルの性能が低い領域があるかどうかを把握し、今後の開発で重点的に取り組む領域を絞りたい場合です。
- 評価データ内の保護対象グループに対してモデルにバイアスがないことを確認したい場合です。
ここでは、住宅の平均築年数が5年未満または30年超の場合に、モデルがどのような性能を示すかを調べます。
アクション: 評価サブセットを追加を選択し、次に housing_median_age フィールドを選択します。これは数値フィールドなので、使用する定量的なバケット分割方法を定義できます。この例では、範囲の削減を使用し、バケットを 5 と 30 に設定します。
アクション: サブセットの設定を保存します。

このサブセット設定では、評価用データセットごとに4つの異なるデータセットでモデルを評価します。
Overall:評価用データセット全体です。housing_median_age (<5):housing_median_ageが5より小さいデータに絞り込んだ評価用データセットです。housing_median_age (>= 5, < 30):housing_median_ageが5以上、30より小さいデータに絞り込んだ評価用データセットです。housing_median_age (>= 30):housing_median_ageが30以上のデータに絞り込んだ評価用データセットです。
これにより、housing_median_age が異なるレコードで、モデルが同様に動作しているかどうかを判断できます。
アクション: ページの右上にある設定の保存を選択して保存し、評価ダッシュボードに戻ります。以降、この目標に送信するモデルは、モデルの評価に使用できる推論データセットとメトリクスデータセットを自動的に生成してビルドします。

3.3 メトリクスパイプラインをビルドする方法
メトリクスパイプラインを設定すると、このモデリング目標にモデルを送信するたびに、推論データセットとメトリクスデータセットが作成され、開始されます。そのように設定されている場合、Foundry はこれらのデータセットの実行も自動的に行い、モデリング目標の評価ダッシュボードにメトリクスを追加します。
今回は、この目標にモデルをすでに追加していたため、これらのデータセットのビルドを手動で開始する必要があります。
評価パイプラインの作成には数分かかることがあるため、Build アクションがアクティブになるまで待つ必要がある場合があります。
アクション: 評価ダッシュボードの右上にある評価を構築を選択し、評価ダッシュボードとして housing_test_data を、評価するモデルとして linear_regression_model を選択します。次に、Build を選択して推論とメトリクスのビルドを開始します。

ビルドが開始されると、評価ダッシュボードの右上にある最近のビルドのドロップダウンから、ビルドの進行状況を確認できます。Foundry インスタンスの負荷によっては、評価パイプラインの実行に数分かかる場合があります。

3.4 評価ダッシュボードでモデルを評価する方法
このチュートリアルを先に進める前に、先ほど作成した推論データセットとメトリクスデータセットのビルドが、評価ダッシュボードで正常に完了していることを確認してください。メトリクスの計算が完了すると、このモデリング目標に追加したすべてのモデルのメトリクスを表示して比較できます。これにより、モデリングプロジェクトの性能に関する情報を一元的に確認できるようになります。
回帰評価ライブラリでは、評価ダッシュボードで利用可能なさまざまなメトリクスを生成しました。これらのメトリクスにより、未見のテストデータに対して、モデルがラベル(国勢調査地区の住宅価格の中央値)をどの程度正確に予測できるかを把握できます。
どのメトリクスを使用するか、どの程度の性能を十分とみなすかは、プロジェクトによって異なります。通常、この判断には関係者との話し合いが必要ですが、この架空の例では、このモデルの性能は十分であるとします。この場合、二乗平均平方根誤差が82639.10であることは、未見のテストデータにおいて、モデルの予測値とラベルの差が平均で $82,639.10 であることを意味します。
アクション:ページを再読み込みし、左サイドバーのデータセットセレクターで housing_test_dataset データセットを選択してから、モデルセレクターで linear_regression_model を選択します。

評価ダッシュボードでは、先ほど定義したサブセットごとのモデル性能も表示されます。評価ダッシュボードのタブには、メトリクスを確認できる利用可能なサブセットグループが表示されます。この場合、住宅築年数の中央値が5年から30年の範囲にあるときに、モデルの性能が最も高いことがわかります。
アクション:評価ダッシュボードの上部にある housing_median_age タブを選択します。

次のステップ
機械学習モデルの評価が完了したので、このモデルを本番アプリケーションに統合できます。モデルを本番環境に導入する方法のチュートリアルを確認してください。