注: 以下の翻訳の正確性は検証されていません。AIPを利用して英語版の原文から機械的に翻訳されたものです。
実験
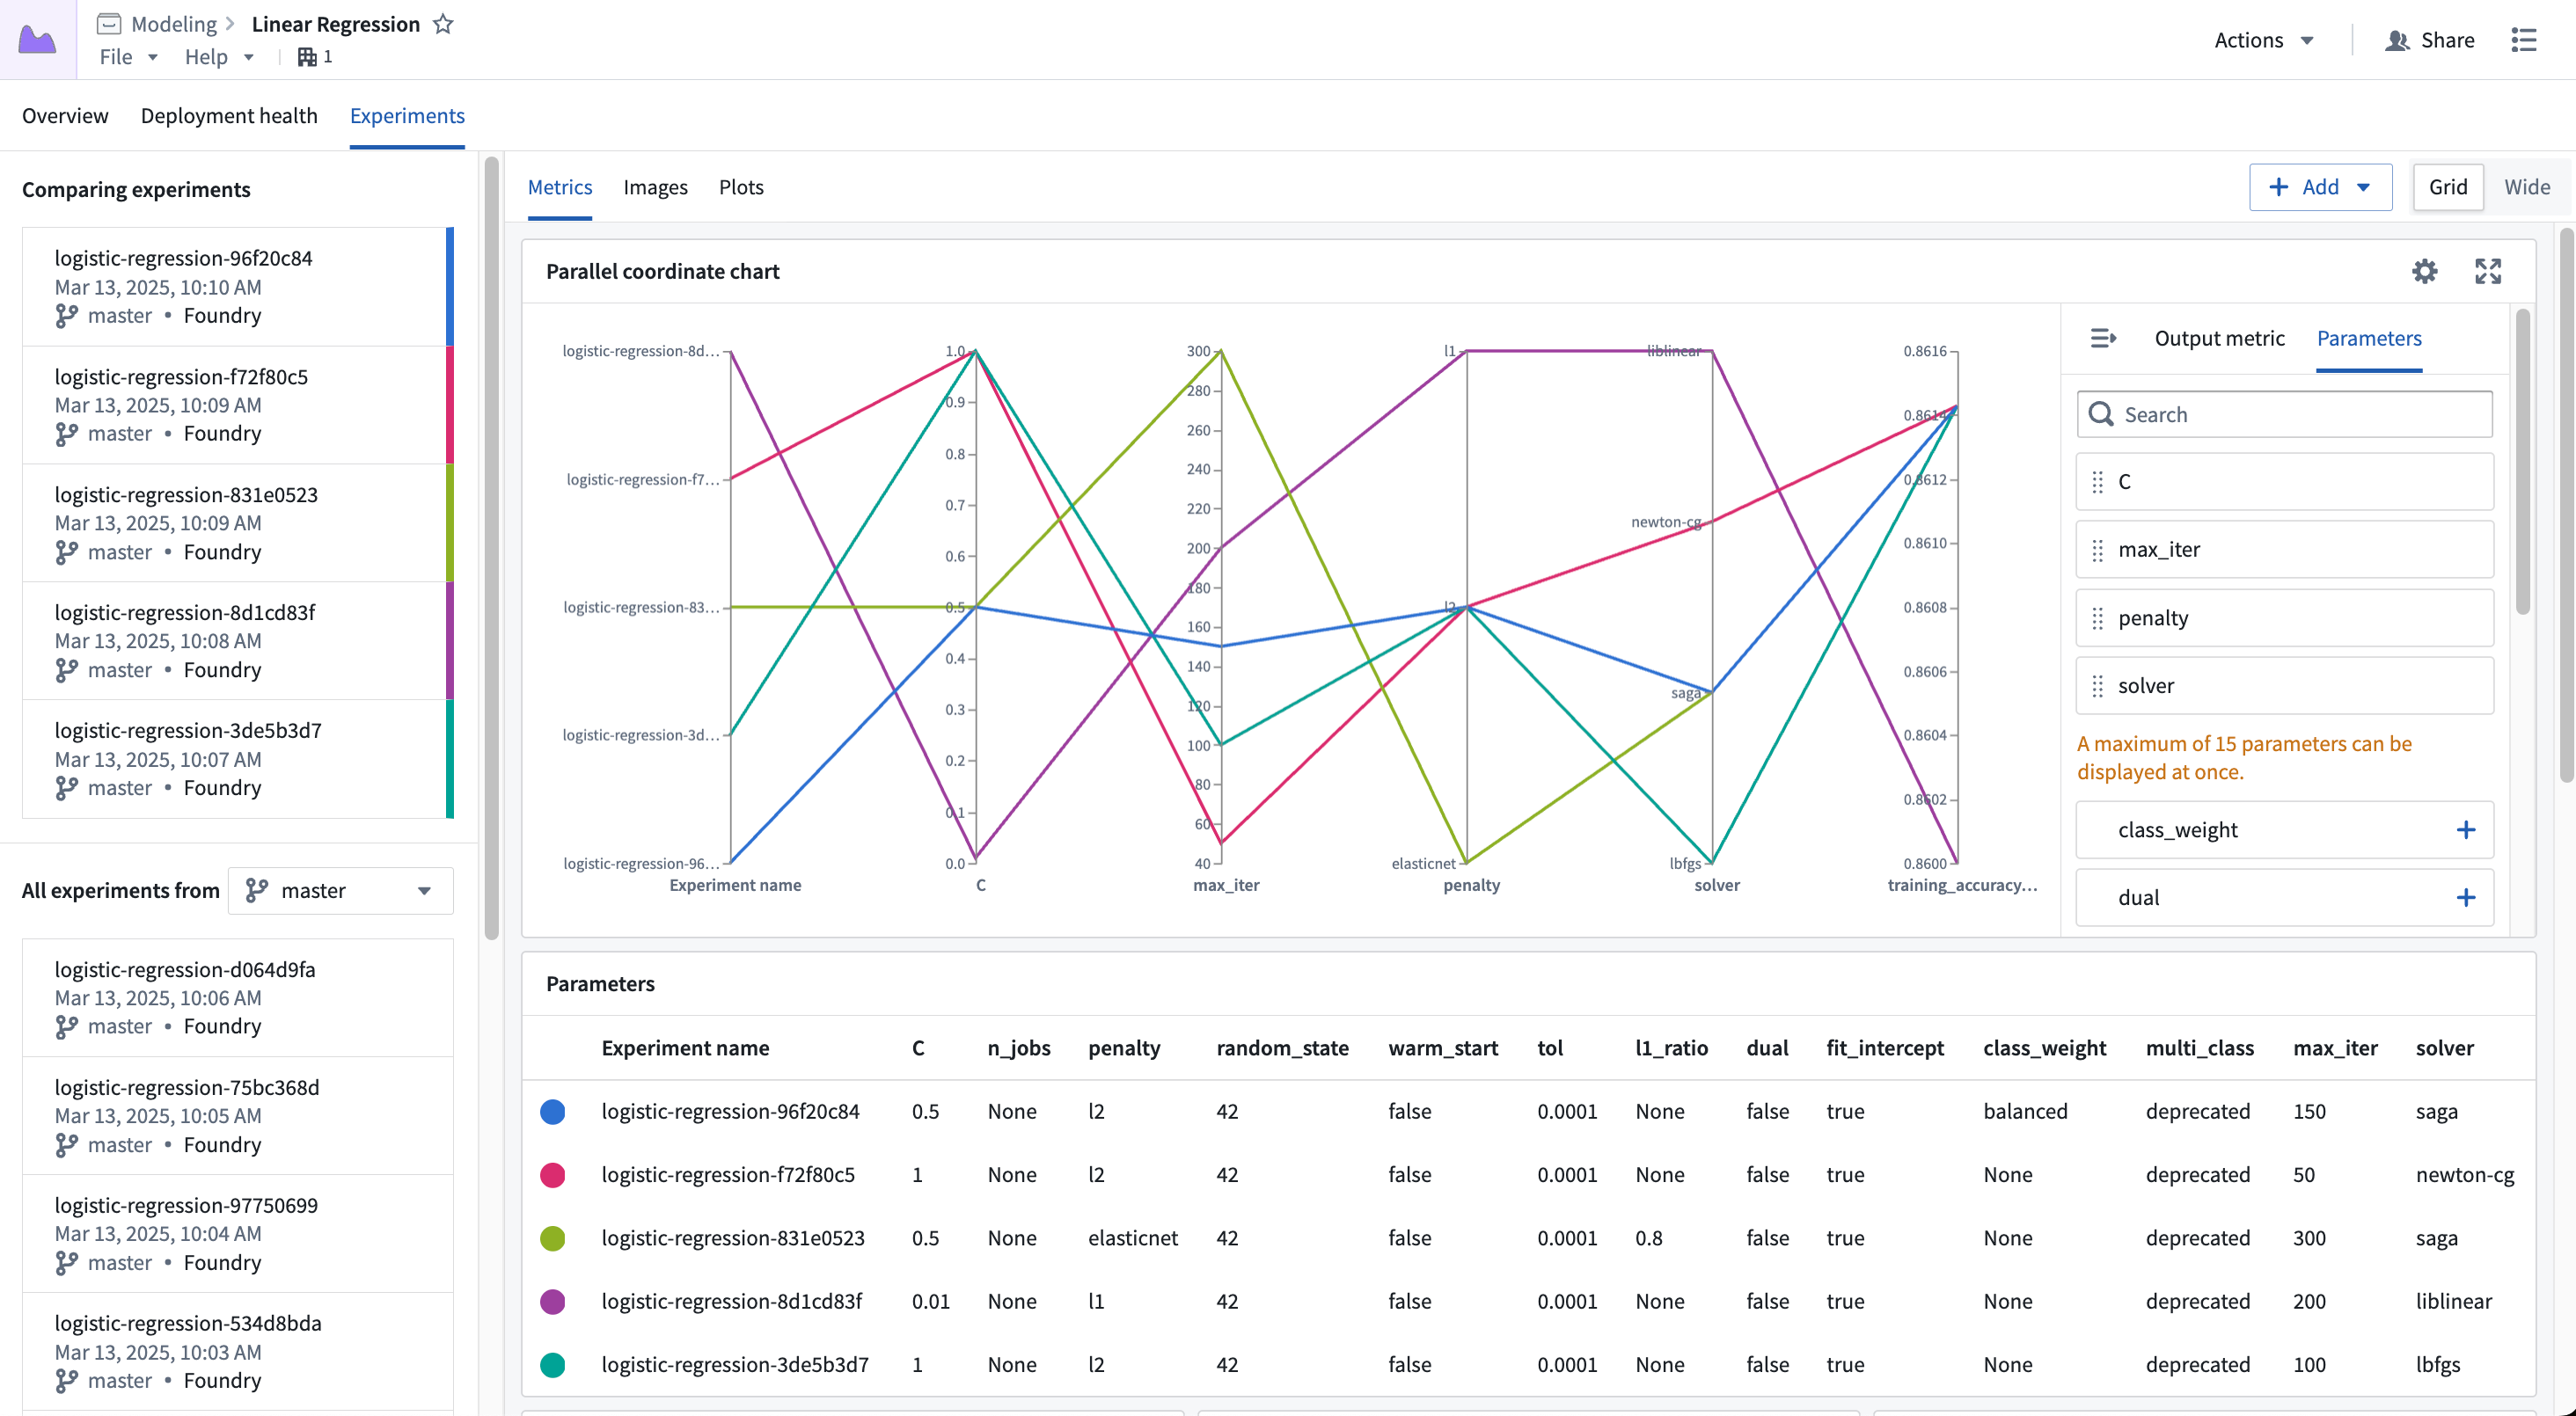
実験 は、モデルトレーニングジョブ中に生成されたメトリクスをまとめた作成物です。開発者は実験を使用して、トレーニングジョブ中にハイパーパラメーターとメトリクスを記録し、モデルページで可視化して、異なるモデルバージョン間で比較できます。
実験を使用する理由
モデル開発のプロセスでは必ず反復が必要であり、モデルを作成するためのさまざまな試行を追跡することは難しい場合があります。実験は、メトリクスやハイパーパラメーターなど、これらの試行に関連する詳細を記録するための軽量な Python API を提供します。これらのメトリクスとハイパーパラメーターを可視化し、異なるモデルバージョン間で比較することで、さまざまなパラメーターがモデルの性能にどのように影響するかをより深く理解できます。以下では、実験を作成して書き込む方法の概要を説明します。
実験を作成する
Jupyter® Code Workspaces および Code Repositories からモデルを公開するために使用する ModelOutput クラスには、実験を作成するためのフックが用意されています。
Code Workspaces で実験を作成します。
Copied!1 2 3 4from palantir_models.code_workspaces import ModelOutput # `my-alias` は現在のワークスペース内のモデルへのエイリアスです model_output = ModelOutput("my-alias") experiment = model_output.create_experiment(name="my-experiment")
Code Repositories で実験を作成します。
Copied!1 2 3 4 5 6 7 8 9from transforms.api import configure, transform, Input from palantir_models.transforms import ModelOutput @transform( input_data=Input("..."), model_output=ModelOutput("..."), ) def compute(input_data, model_output): experiment = model_output.create_experiment(name="my-experiment")
特定のモデルの2つの実験に同じ名前が使用されている場合、重複は自動的に排除されます。そのため、実験の名前変更を気にすることなく、同じコードを何度でも使用できます。
実験への書き込み時のネットワークエラーや、系列の最大サイズの超過により、モデルトレーニングコードの実行に失敗することがあります。Python クライアントはこれらのエラーを可能な限り適切に処理するよう設計されていますが、処理できない場合もあります。クライアントは、次の3つのエラー処理方式から、エラーを処理する方法を選択できます。
FAIL- エラーを即座に再送出し、コードの実行に失敗します。WARN(デフォルト) - エラーの警告を記録し、その後のすべてのエラーを抑制します。SUPPRESS- 何も記録しません。
エラーハンドラーモードは、次に示すように実験の作成時に設定できます。
Copied!1 2from palantir_models.experiments import ErrorHandlerType experiment = model_output.create_experiment(name="my-experiment", error_handler_type=ErrorHandlerType.FAIL)
実験を公開する
モデルページに実験を表示するには、モデルバージョンとともに公開する必要があります。公開後は、モデルページで実験を閲覧できます。
Copied!1model_output.publish(model_adapter, experiment=experiment)
ロギング
実験は、ハイパーパラメーター、メトリクス、画像、プロット、テーブルの5種類のログに対応しています。
ハイパーパラメーターを記録する
ハイパーパラメーターは、Experiment.log_param 関数および Experiment.log_params 関数を使用して記録できます。ハイパーパラメーターは単一のキーと値のペアであり、モデルトレーニングジョブに関連する静的データの保存に使用します。
Copied!1 2 3 4 5 6experiment.log_param("learning_rate", 1e-3) experiment.log_param("model_type", "CNN") experiment.log_params({ "batch_size": 12, "parallel": True })
現在、実験では次のデータ型のハイパーパラメーターを記録できます。
- ブール値
- Date/Datetime
- Float
- Int
- 文字列
メトリクスを記録する
メトリクスは、Experiment.log_metric 関数および Experiment.log_metrics 関数を使用して記録できます。メトリクスは系列に記録され、系列は記録された各値を時系列で追跡します。メトリクス値は数値である必要があり、ステップは厳密に増加する必要があります。
メトリクスの記録時にメトリクス系列がまだ作成されていない場合は、新しい系列が作成されます。また、呼び出し元は step パラメーターを渡して、記録先のステップを設定できます。
Copied!1 2 3 4 5 6experiment.log_metric("train/acc", 1.5) experiment.log_metric("test/acc", 15, step=1) experiment.log_metrics({ "train/acc": 5, "train/loss": 0.9 })
画像を記録する
画像は、Experiment.log_image を使用して記録できます。画像は系列に記録され、系列は記録された各画像を時系列で追跡します。記録する画像は PNG 形式または Pillow ↗ の画像である必要があります。ほかの画像形式は拒否されます。
画像の記録時に画像系列がまだ作成されていない場合は、新しい系列が作成されます。また、呼び出し元は step パラメーターを渡して、記録先のステップを設定できます。
Copied!1 2 3 4 5 6 7experiment.log_image("train/bounding_boxes", pillow_image) experiment.log_image("test/bounding_boxes", image_bytes_arr) experiment.log_image( "test/segmentation", "path/to/image.png", caption="Segmentation Image", step=1)
画像の記録は、カスタムチャートを記録する方法としても使用できます。
Copied!1 2 3 4 5import matplotlib.pyplot as plt plt.scatter(x_data, y_data) plt.savefig("path/to/image.png") experiment.log_image("scatter", "path/to/image.png")
プロットを記録する
プロットは、Experiment.log_plot を使用して記録できます。プロットは系列に記録され、系列は記録された各プロットを時系列で追跡します。プロットは Plotly ↗ の plotly.graph_objects.Figure として指定する必要があります。ほかの種類のプロットは拒否されます。
プロットの記録時にプロット系列がまだ作成されていない場合は、新しい系列が作成されます。また、呼び出し元は step パラメーターを渡して、記録先のステップを設定できます。
Copied!1 2 3 4 5 6 7 8 9 10 11import plotly.express as px fig = px.line(x=[1, 2, 3], y=[0.2, 0.4, 0.6]) experiment.log_plot("train/acc", fig) experiment.log_plot("test/acc", fig, step=1) experiment.log_plot( "validation/loss", fig, caption="Validation Loss over Epochs", step=2, )
テーブルを記録する
テーブルは、Experiment.log_table を使用して記録できます。指定するテーブルは、pandas ↗ または Polars ↗ の DataFrame である必要があります。ほかのデータ型は拒否されます。
Copied!1 2 3 4 5 6 7 8 9import pandas as pd leaderboard = pd.DataFrame({ "model_type": ["xgboost", "decision_tree", "torch_nn"], "score": [0.75, 0.6, 0.93], "rank": [2, 3, 1] }) experiment.log_table("model_leaderboard", leaderboard)
MLflow
MLflow ↗ は、モデルトレーニングのメトリクスを追跡するためのオープンソースツールキットであり、さまざまな機械学習ライブラリに対応した幅広いロギング機能を内蔵しています。ユーザーは MLflow とその自動ロギング機能 ↗ を活用して、必要な変更を控え目に抑えながら、モデルトレーニングコードへの実験の統合を効率化できます。
実験を作成した後、その実験をアクティブな MLflow 実行として設定し、MLflow の Python API を使用して実験にログを書き込むことができます。
Copied!1 2 3 4 5 6 7 8 9 10import mlflow experiment = model_output.create_experiment(name="my-experiment") with experiment.as_mlflow_run(): mlflow.sklearn.autolog() # 学習コード model_adapter = MyModelAdapter(trained_model) model_output.publish(model_adapter, experiment=experiment)
MLflow は、メトリクスの記録にコールバックが必要な場合がある、より高度な機械学習ライブラリ(Keras など)向けのフックも提供します。
Copied!1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29import keras import mlflow experiment = model_output.create_experiment(name="my-experiment") model = keras.Sequential( [ keras.Input([28, 28, 3]), keras.layers.Flatten(), keras.layers.Dense(2), ] ) model.compile( loss=keras.losses.SparseCategoricalCrossentropy(from_logits=True), optimizer=keras.optimizers.Adam(0.001), metrics=[keras.metrics.SparseCategoricalAccuracy()], ) with experiment.as_mlflow_run(): model.fit( data, label, batch_size=16, epochs=8, callbacks=[mlflow.keras.MlflowCallback()], ) model_adapter = MyModelAdapter(trained_model) model_output.publish(model_adapter, experiment=experiment)
MLflow 統合の制限事項
現在、実験との MLflow 統合は、MLflow ツールの全機能には対応していません。次の制限事項が適用されます。
- ロギングは、モデルの公開(トレーニング)時にのみ実行できます。
- アセットへの対応は限定的であり、PNG 以外のアセットは通知なく破棄されます。
- タグは通知なく無視されます。
- ネストされた実行には対応していません。
上限
以下のテーブルに、Foundry の実験に関連する上限を示します。
| 説明 | 上限 |
|---|---|
| 実験名/メトリクス名/ハイパーパラメーター名の最大長 | 100文字 |
| 実験内のすべてのメトリクス系列にわたる値の最大数 | 100,000 |
| 実験あたりのハイパーパラメーターの最大数 | 500 |
| テーブルあたりの最大行数 | 100,000 |
これらの上限を引き上げるには、Palantir サポートにお問い合わせください。
詳細については、モデル実験の Python API リファレンスを参照してください。