注: 以下の翻訳の正確性は検証されていません。AIPを利用して英語版の原文から機械的に翻訳されたものです。
1. チュートリアル - Foundry で機械学習プロジェクトをセットアップする
このチュートリアルのステップでは、Foundry で機械学習プロジェクトを作成します。このステップは必須で、次の内容を扱います。
1.1 機械学習用の Foundry プロジェクトを構成する方法
Foundry プロジェクトは、関連する作業を保存するためのフォルダー構造です。機械学習プロジェクトごとに個別の Foundry プロジェクトを用意することを推奨します。このプロジェクトには、次のものが必要です。
- このプロジェクトで使用するデータセットを保存する
dataフォルダー - このプロジェクトのモデルを保存する
modelsフォルダー - このプロジェクトで使用するモデルトレーニングのロジックを保存する
codeフォルダー - 本番用モデルを管理およびデプロイするためのモデリング目標
新しいプロジェクトを作成する権限がない場合は、既存のプロジェクト内に新しいフォルダーを作成し、機械学習プロジェクトのルートディレクトリとして使用できます。
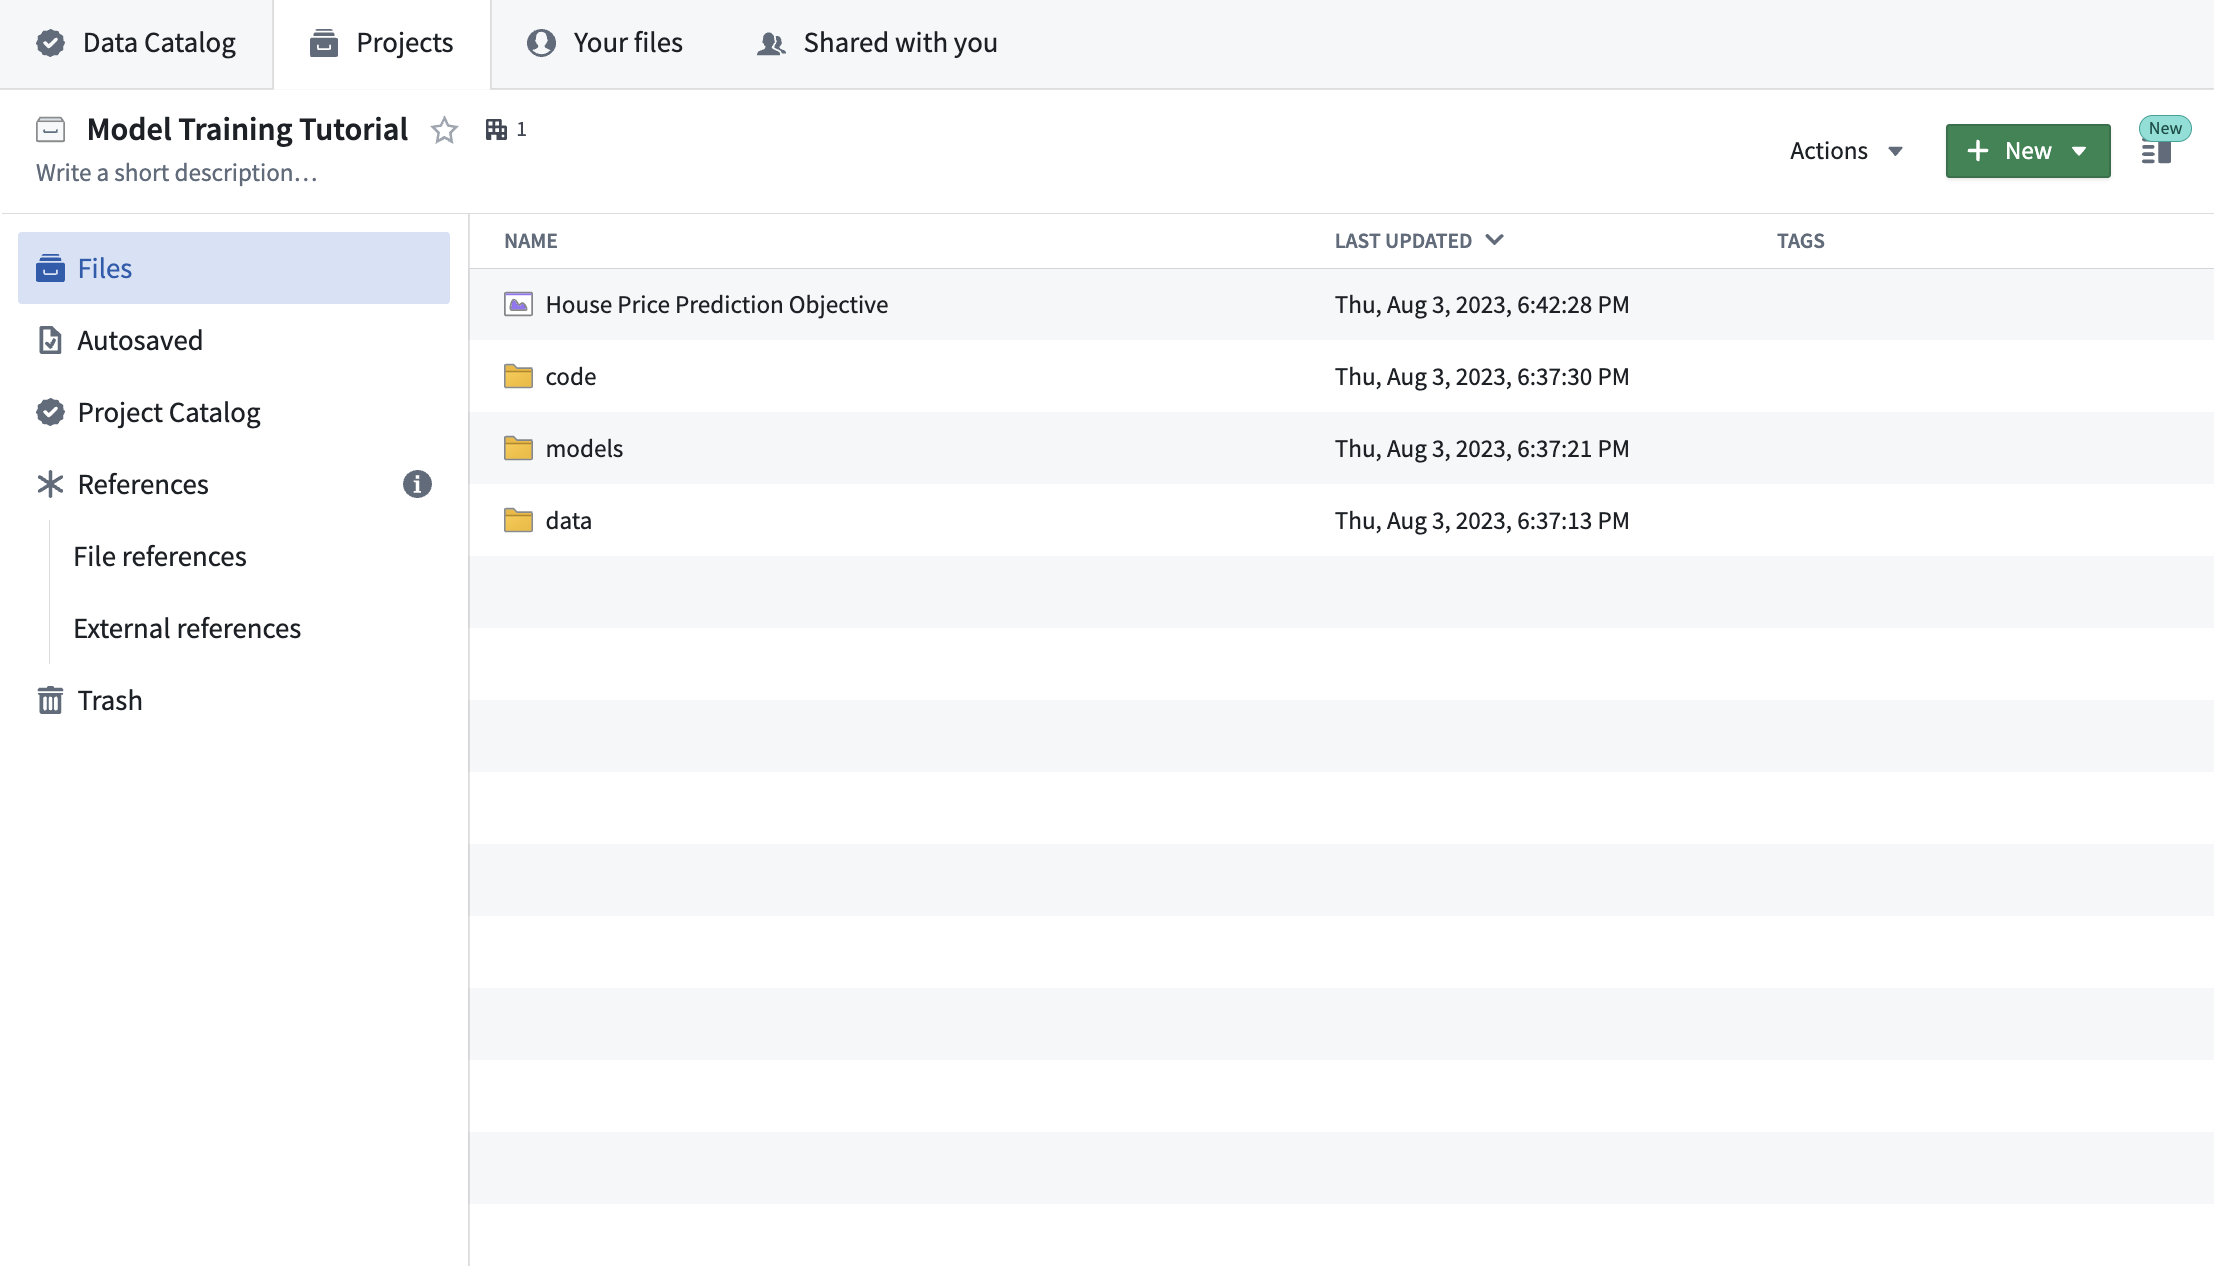
操作: このチュートリアル用に新しい Foundry プロジェクトを作成し、上記のフォルダーを作成します。作成方法はこちらを参照してください。新しい Foundry プロジェクトを作成できない場合は、代わりに既存のプロジェクト内に空のフォルダーを作成し、新しいプロジェクトのルートとして使用します。
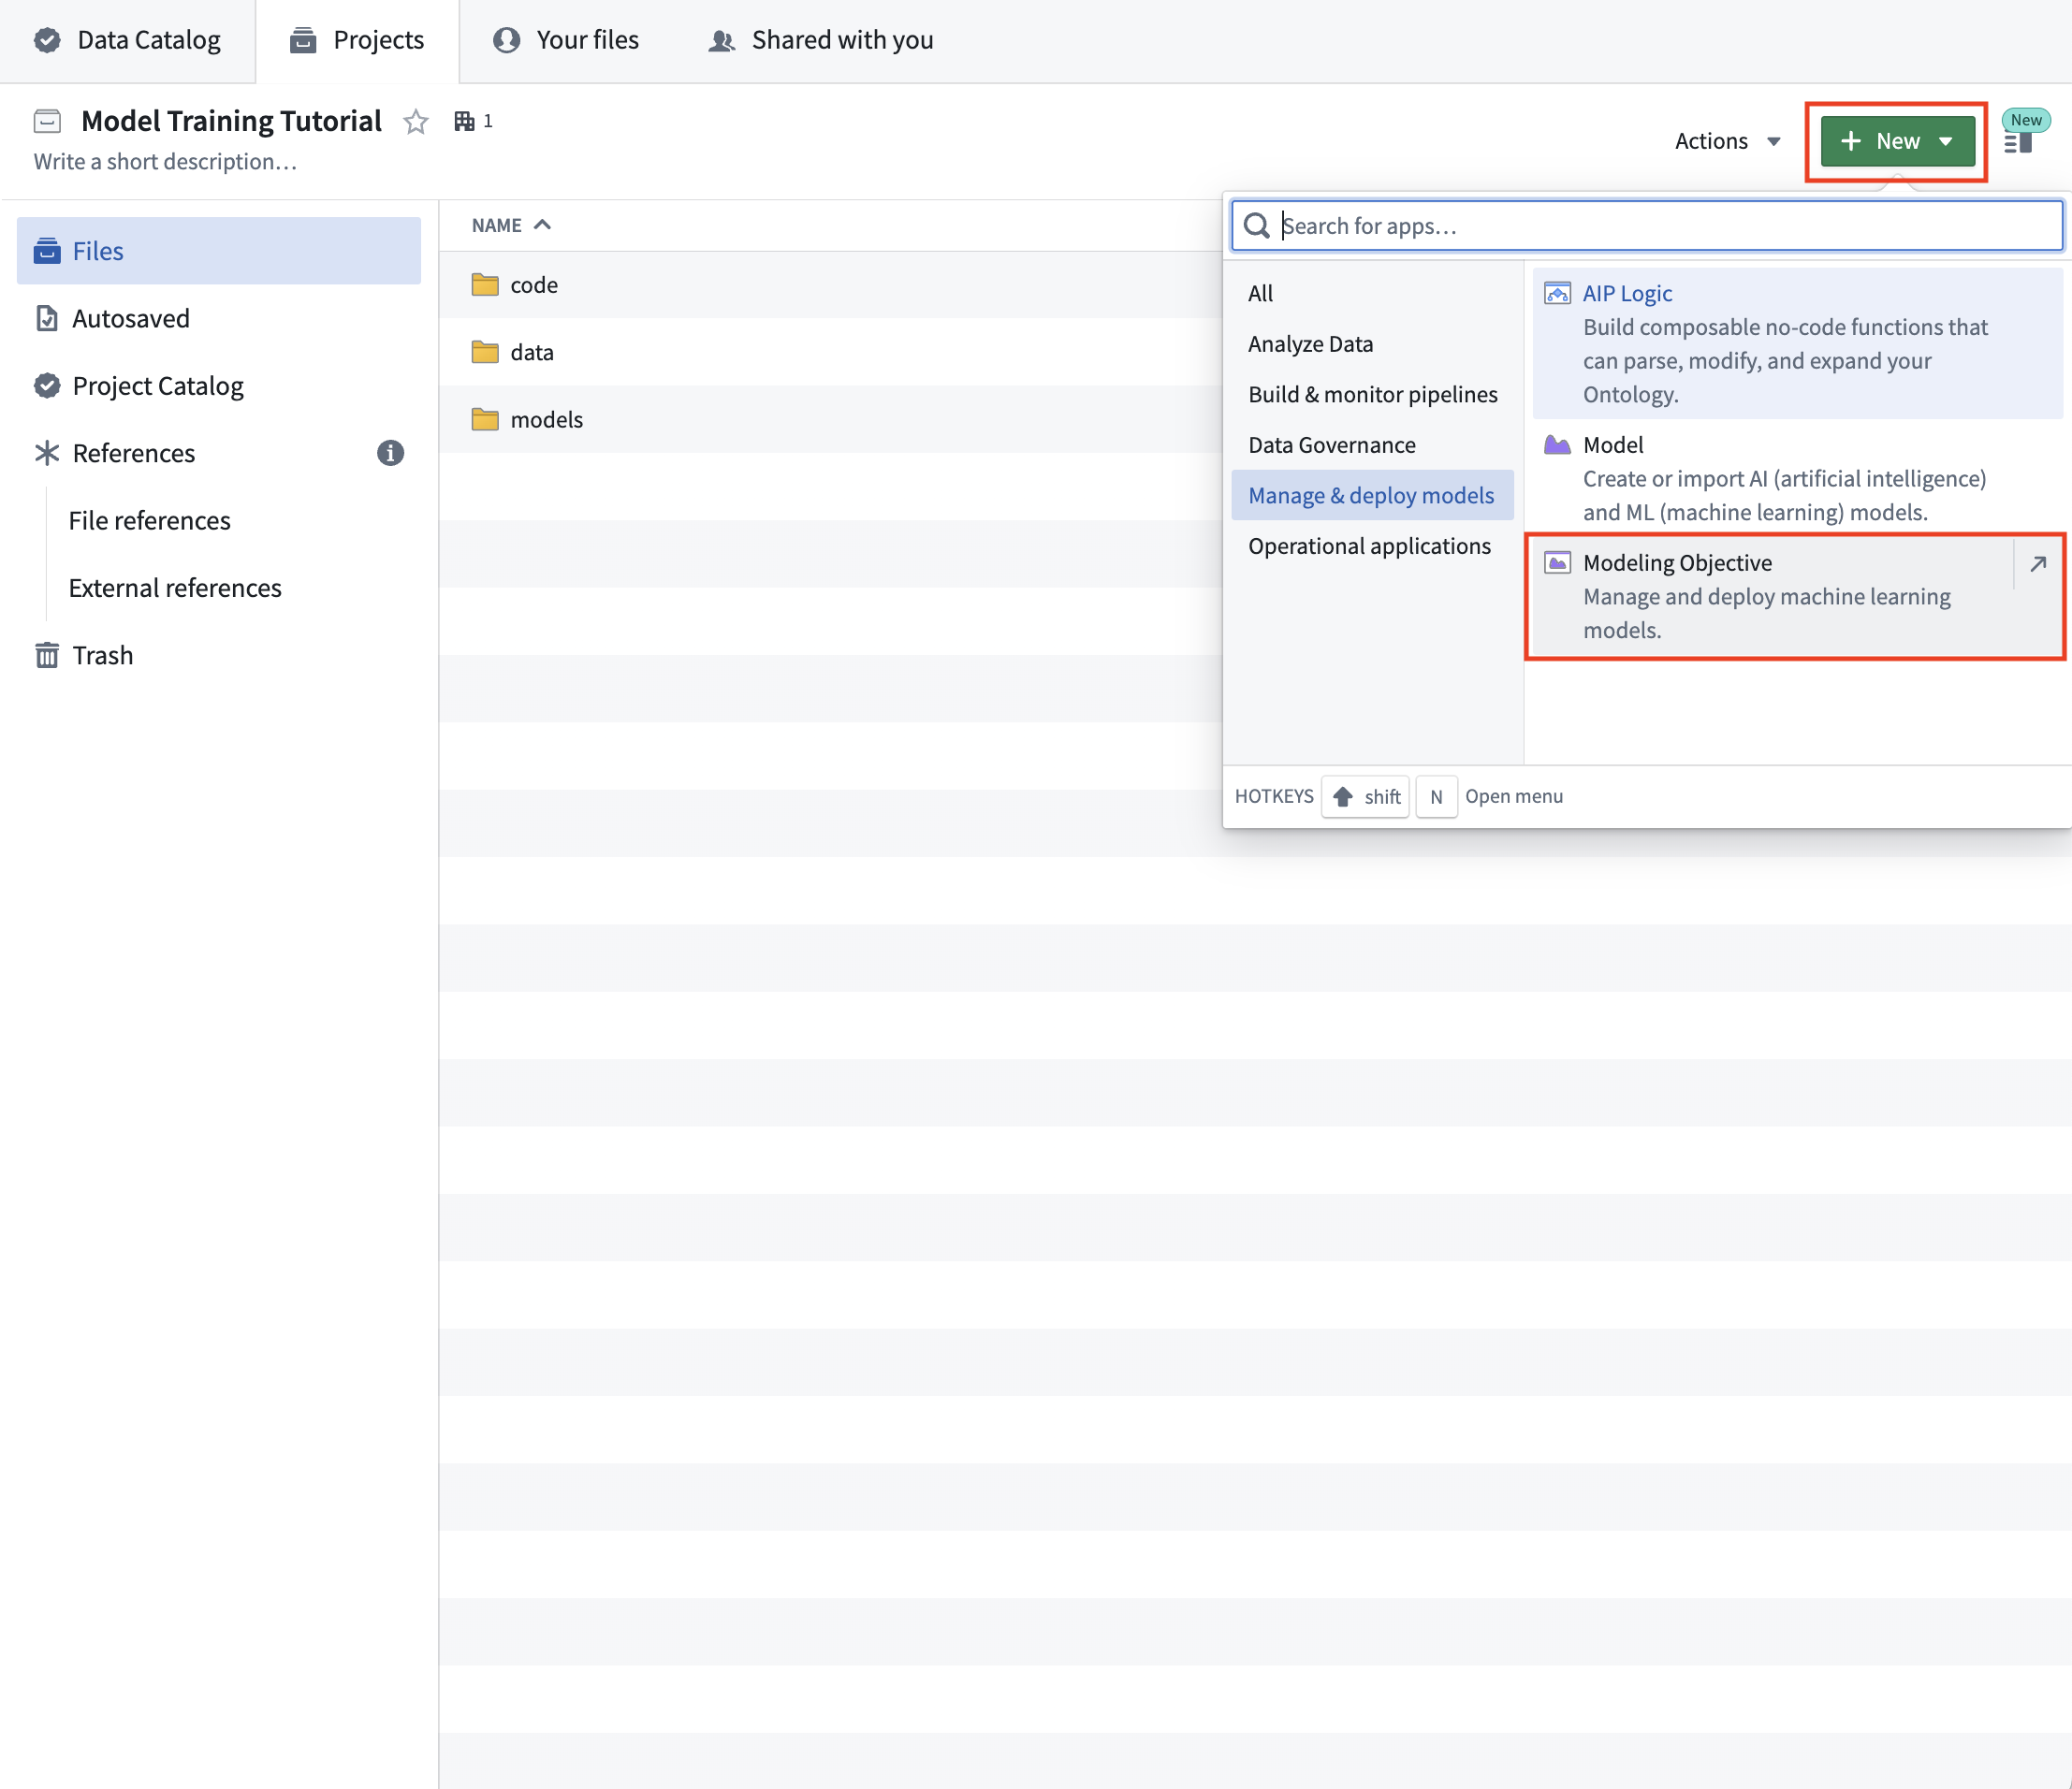
操作: Foundry プロジェクトで、+新規 > Modeling Objective を選択します。モデリング目標には、解決しようとしている機械学習の問題に関連する名前を付けます。この場合は、目標に「House Price Prediction Objective」という名前を付けます。
完成したプロジェクト構造
1.2 機械学習用のデータを管理する方法
このチュートリアルでは、米国の国勢調査地区における住宅価格の中央値を推定する機械学習モデルを作成します。
特徴量データ(米国の国勢調査地区に関する過去の詳細情報)とラベル(その時点での、その国勢調査地区の住宅価格の中央値)を使用して、特徴量とラベルの関係を明らかにし、その関係を再利用可能なモデルとして Foundry に保存します。将来、最新の特徴量データ(米国の国勢調査地区に関する詳細情報)はあるものの、最新のラベル(住宅価格の中央値)がない場合に、その国勢調査地区の特徴量データにモデルを適用して、その地区の住宅価格の推定値を求めることができます。この種類の機械学習プロジェクトは教師あり機械学習と呼ばれ、最も一般的な種類の機械学習プロジェクトです。
Foundry では、教師あり機械学習プロジェクトに次の2個のデータセットが必要です。
- モデルのトレーニングとテストに使用できるラベル付きデータセット
- 最新の特徴量を含み、ラベルを含まないラベルなしデータセット。このデータセットにモデルを適用して、推論結果(ラベルの予測)を生成します。
これらのデータセットは、多くの場合、本番ソースへのデータ接続またはオントロジーから取得されます。ただし、このチュートリアルでは、CSV ファイルをアップロードして本番ソースを模擬します。
操作: ラベル付きの米国住宅データソースをダウンロードし、data フォルダーに housing_features_and_labels としてアップロードします。ラベルなしの米国国勢調査データソースをダウンロードし、data フォルダーに housing_inference_data としてアップロードします。CSV ファイルは、フォルダー構造にドラッグすることで Foundry にアップロードできます。このチュートリアルでは、構造化データセットとしてアップロードします。
完成したデータフォルダー

1.3 機械学習モデルを管理する方法
Foundry でトレーニングされたモデルは、そのトレーニングに使用されたデータ、コード、開発環境にリンクされます。これにより、すべてのモデルがどのように作成されたかについて、ガバナンスの下で記録を残すとともに、過去の実験の詳細を記録して共有できます。
機械学習モデルは、Foundry の Code Repositories アプリケーションでトレーニングできます。
Code Repositories
Code Repositories アプリケーションは、データパイプラインと機械学習ロジックを開発するための Web ベースの開発環境です。機械学習用に、Foundry はモデル統合リポジトリとモデル訓練言語テンプレートを提供しています。
Code Repositories は、ローカルでコードを反復開発するために Git をサポートしていますが、Foundry 内でビルドを実行するには、コードをコミットする必要があります。Code Repositories アプリケーションは、本番用の再現可能なデータパイプラインと機械学習ロジックの開発に最適です。
既存のモデルを統合する
Foundry の外部でトレーニングしたモデルがすでにあり、それを Foundry で使用したい場合は、次の方法で既存のモデルを統合できます。
- ローカルの開発環境、Code Workspaces、またはレガシーシステムでトレーニングされた
.pklファイルなど、事前トレーニング済みのモデルファイルからモデルを公開する。ステップごとのウォークスルーについては、具体的な scikit-learn の例を参照してください。 - Hugging Face から事前トレーニング済みのモデルファイルをインポートする
- コンテナイメージをモデルとしてアップロードする
- 外部でホストされているモデルのプロキシとして機能するモデルを作成する
このチュートリアルのステップには、必須の操作はありません。
1.4 機械学習プロジェクトを管理する方法
Foundry では、Modeling Objectives アプリケーションで機械学習プロジェクトを管理します。モデリング目標は、次の方法で機械学習プロジェクトを管理するためのベストプラクティスを提示します。
- 特定の問題を中心に機械学習プロジェクトを進める
- 体系的なモデル評価のための基準を作成する
- 本番で使用する前に、複数の関係者によるモデルのレビューを可能にする
- 本番で使用されたすべてのモデルの履歴を保持する
- モデル開発を、バッチパイプラインまたはリアルタイムのホスト型推論へのデプロイと統合する
このチュートリアルのモデリング目標は、国勢調査地区における住宅価格の中央値を予測することです。
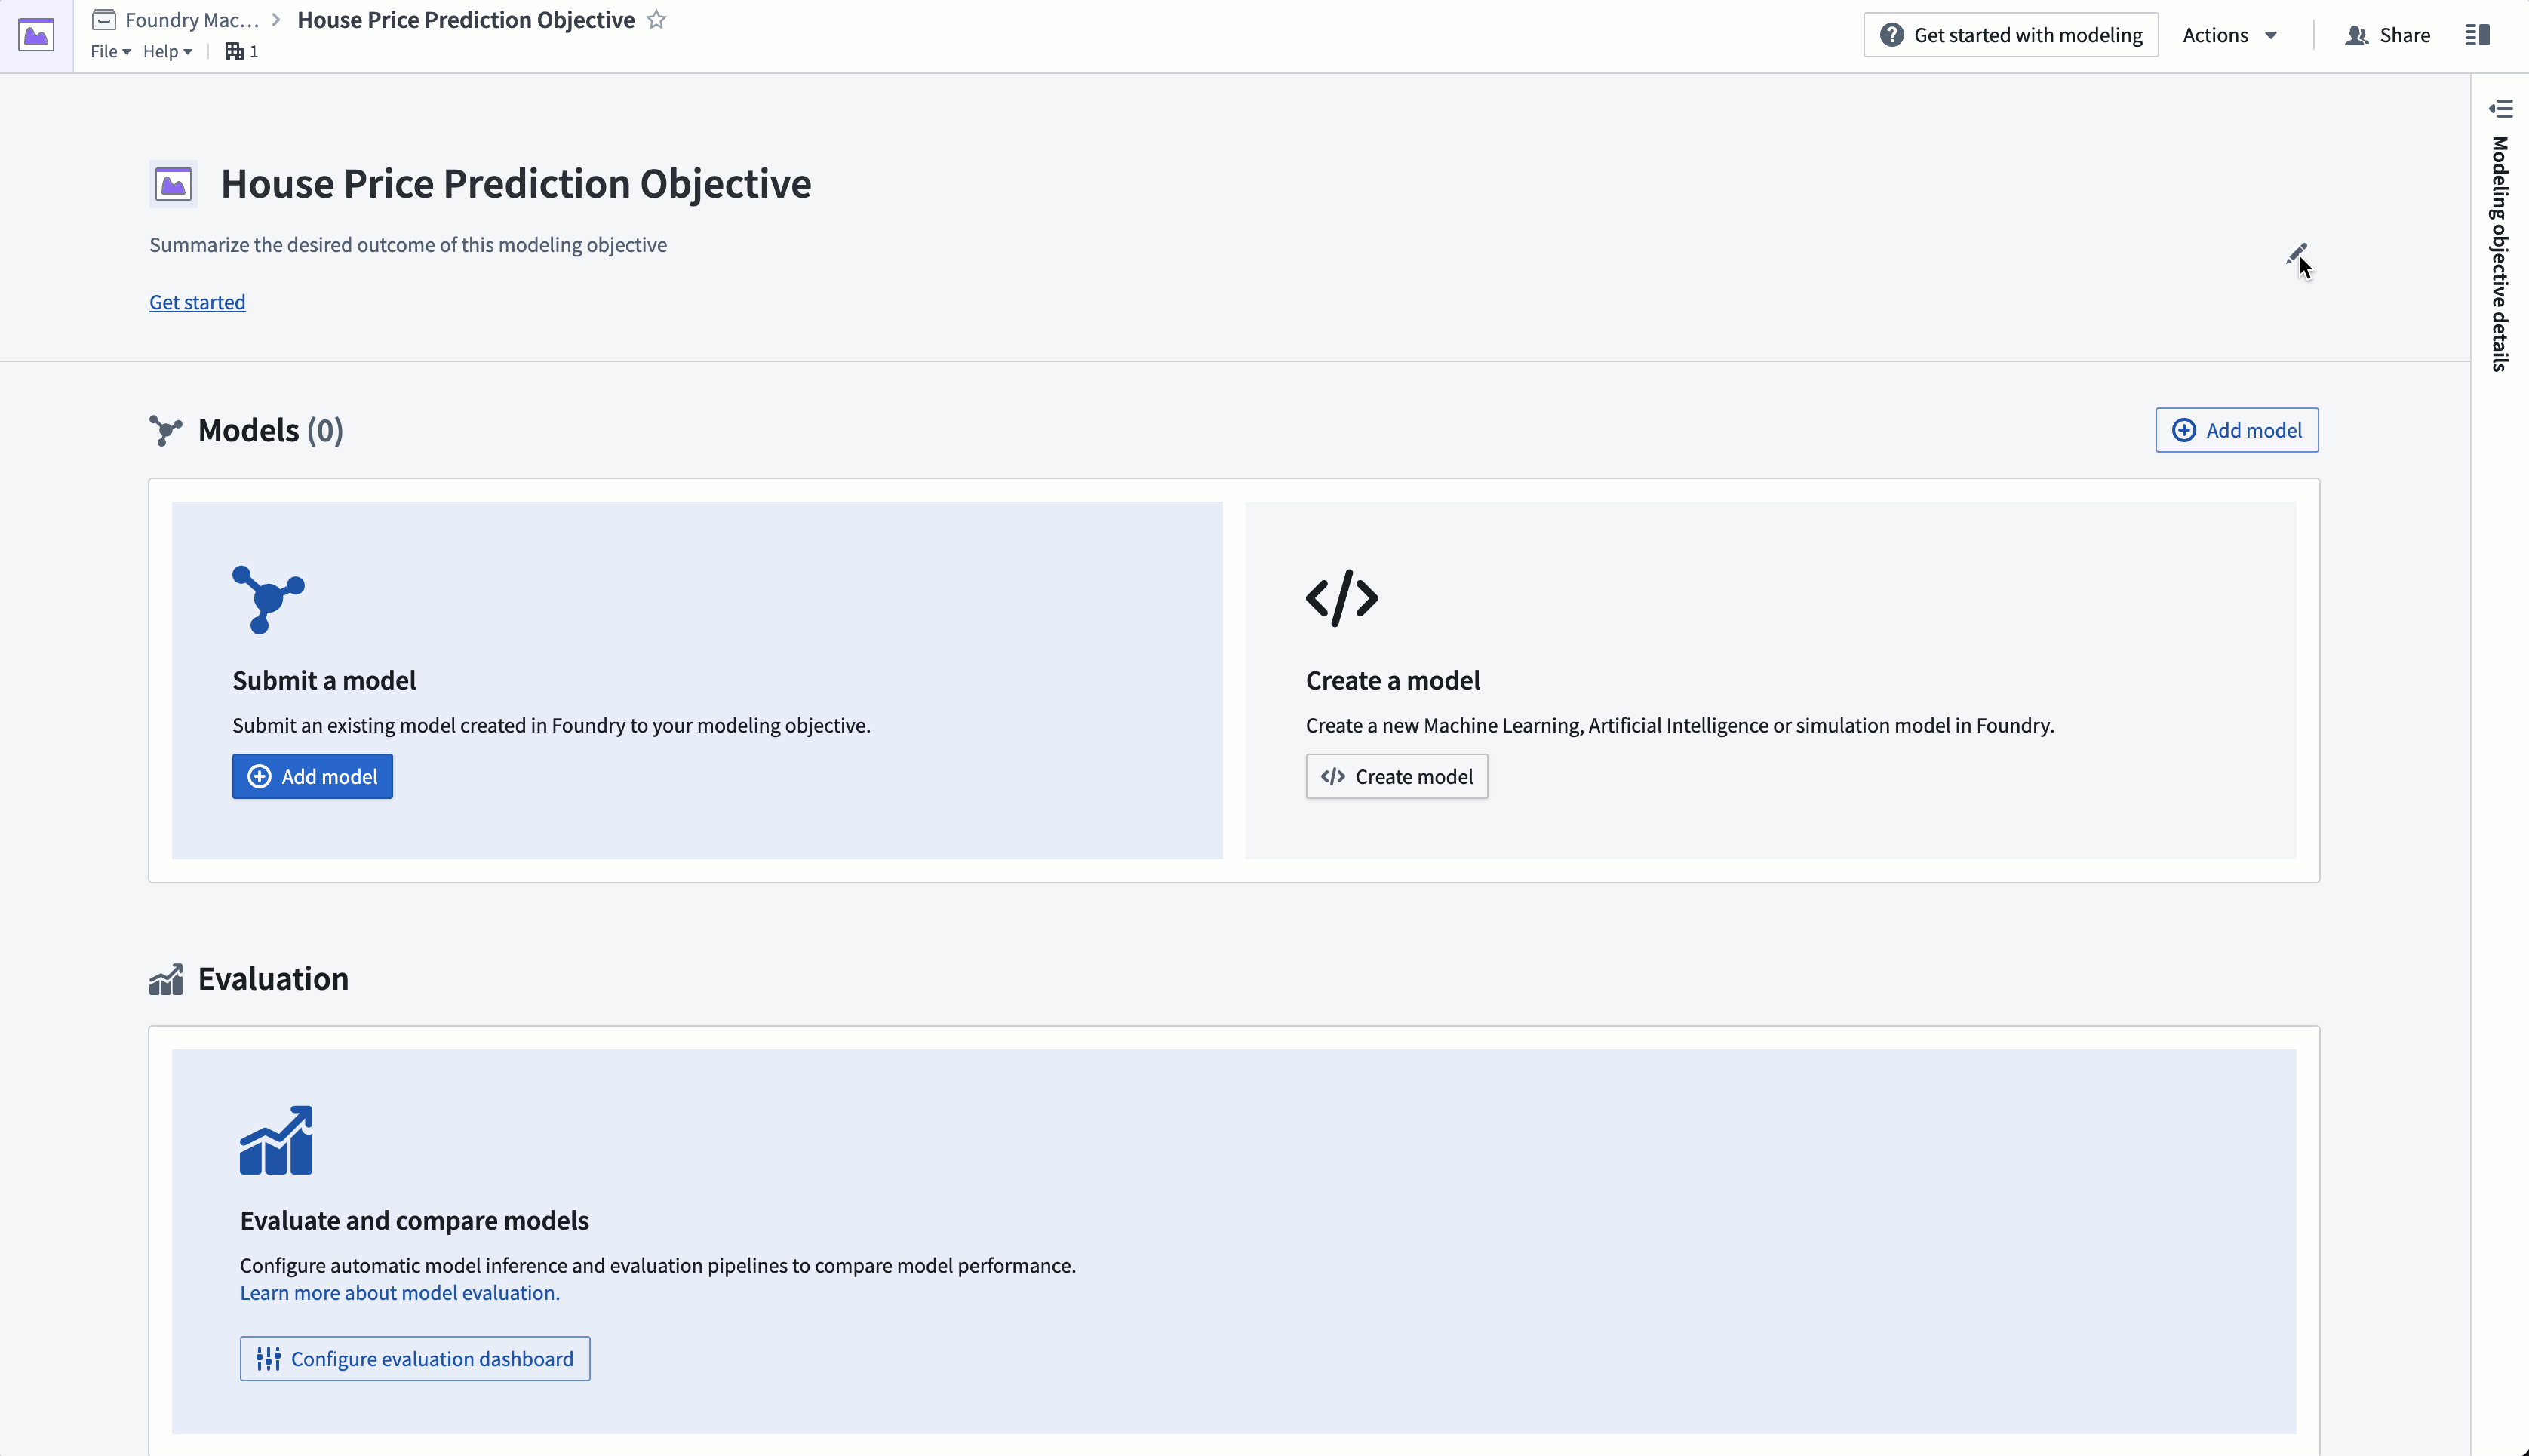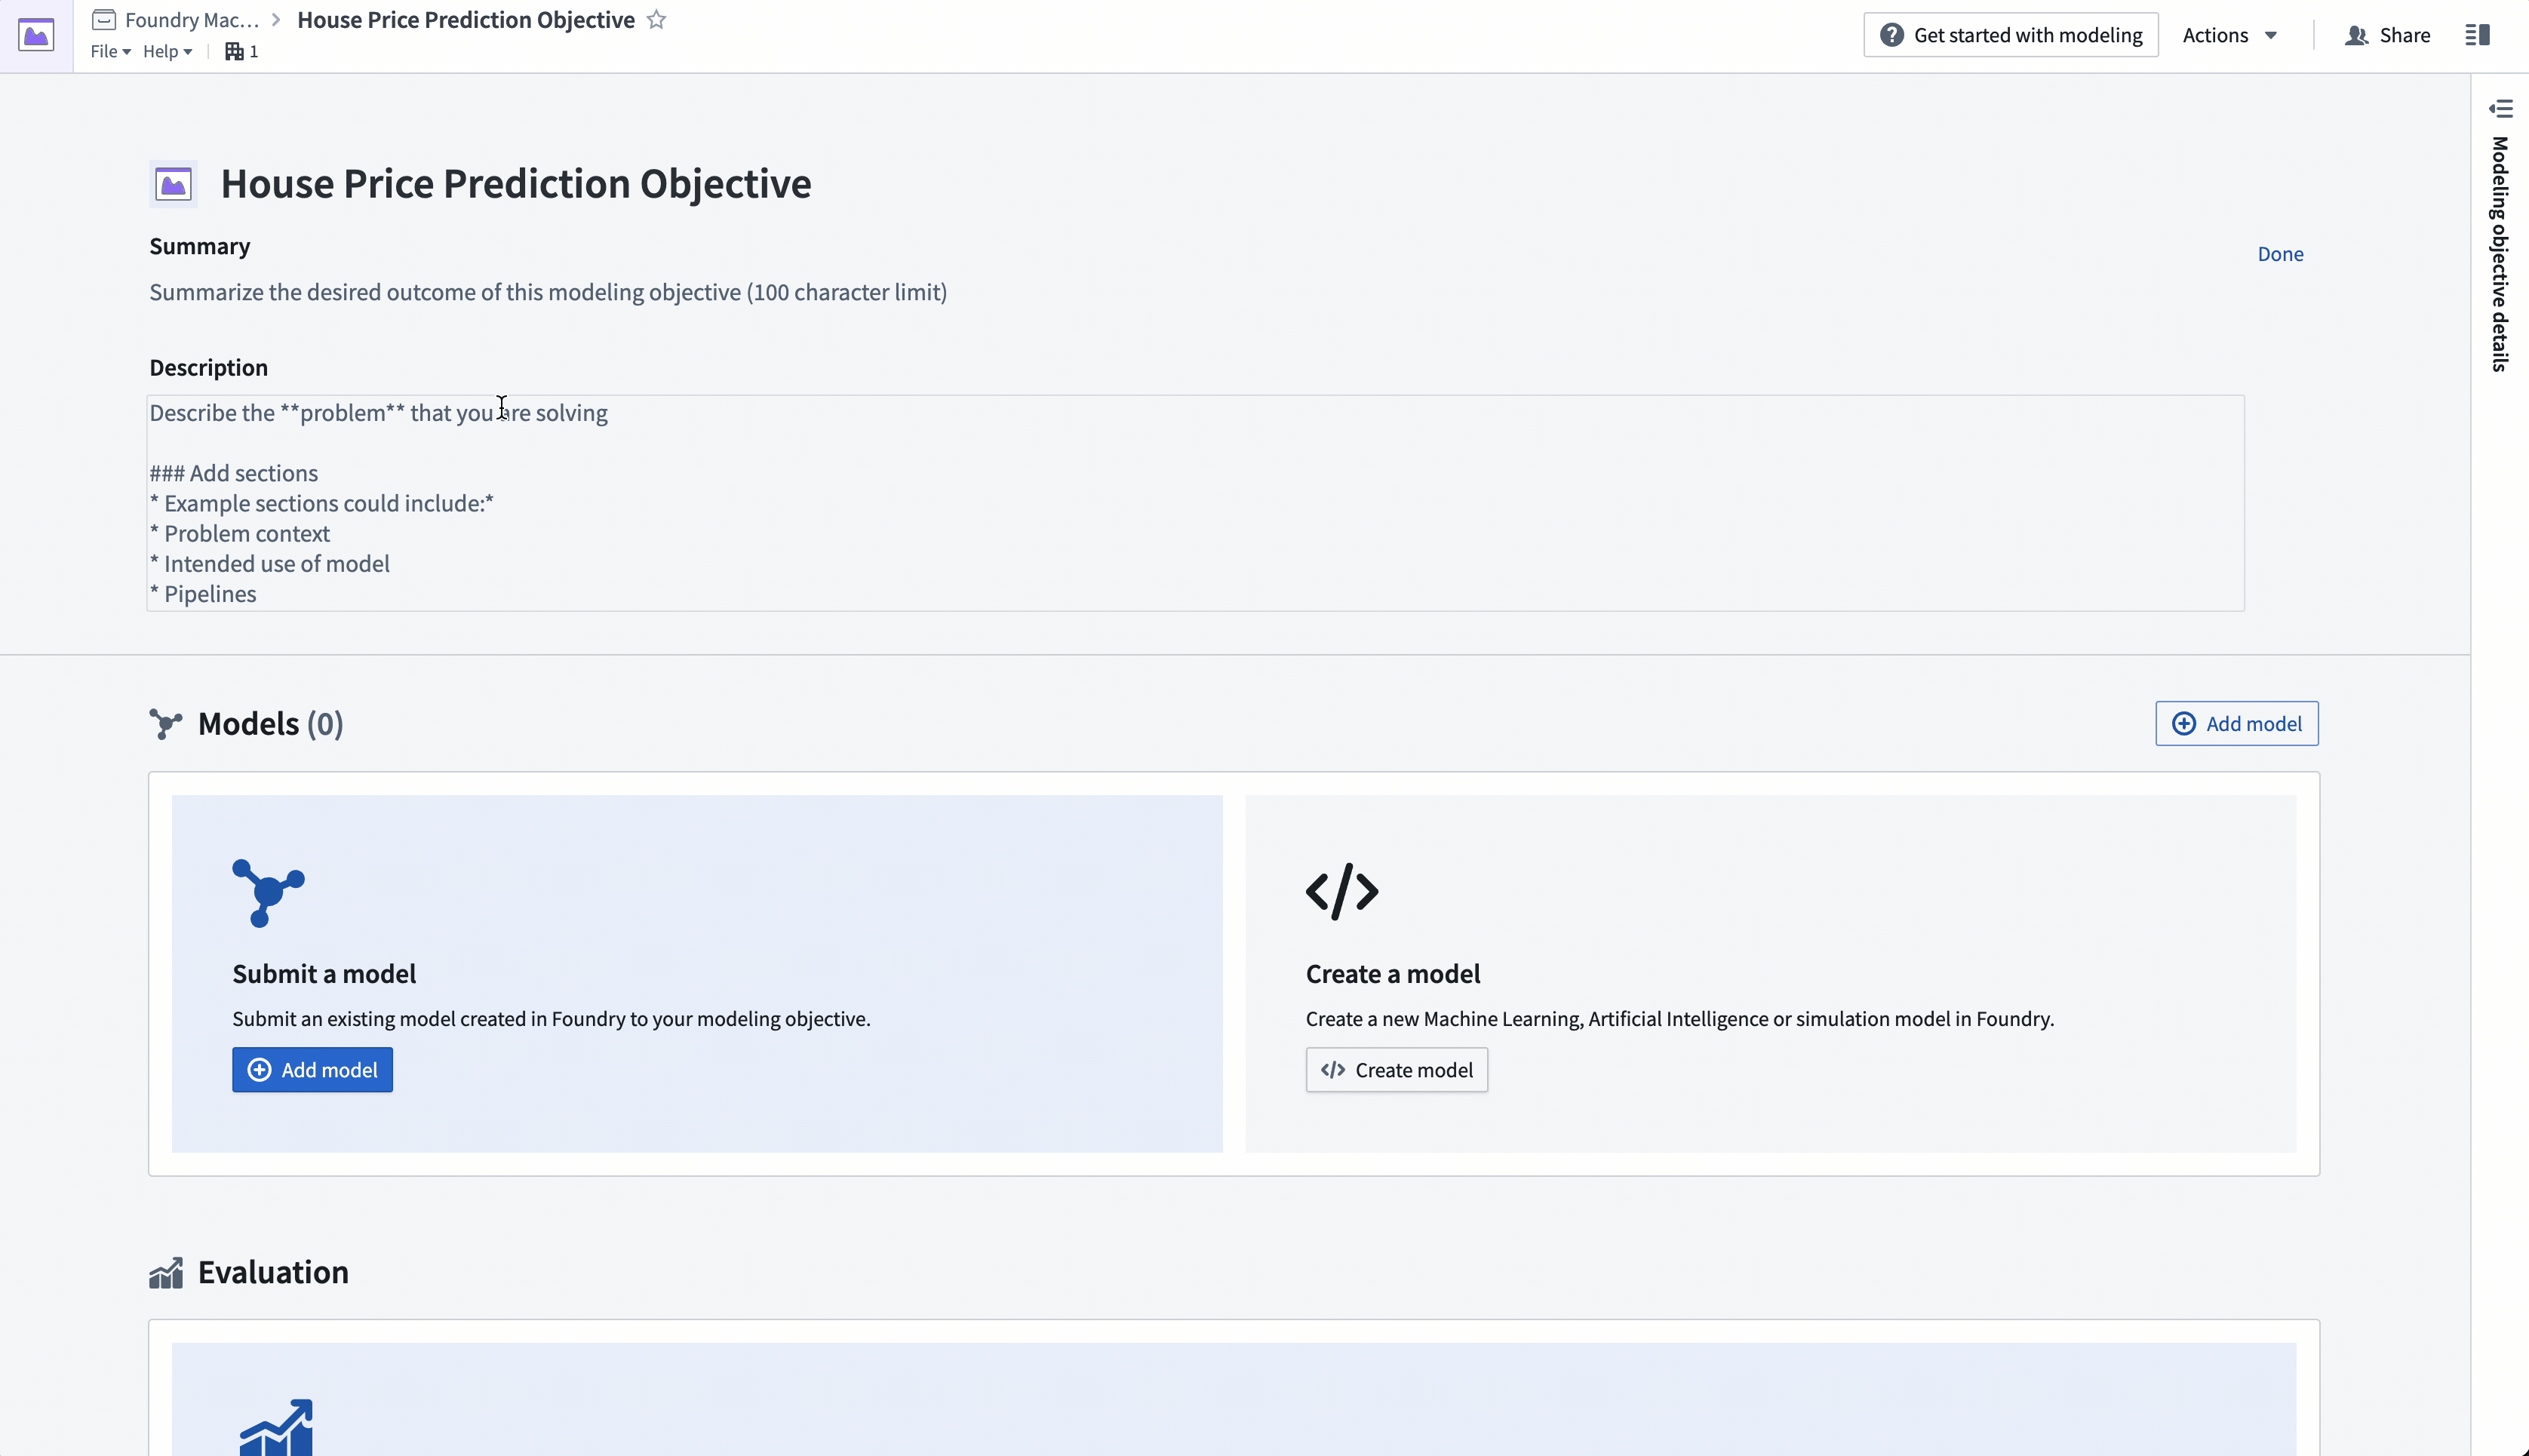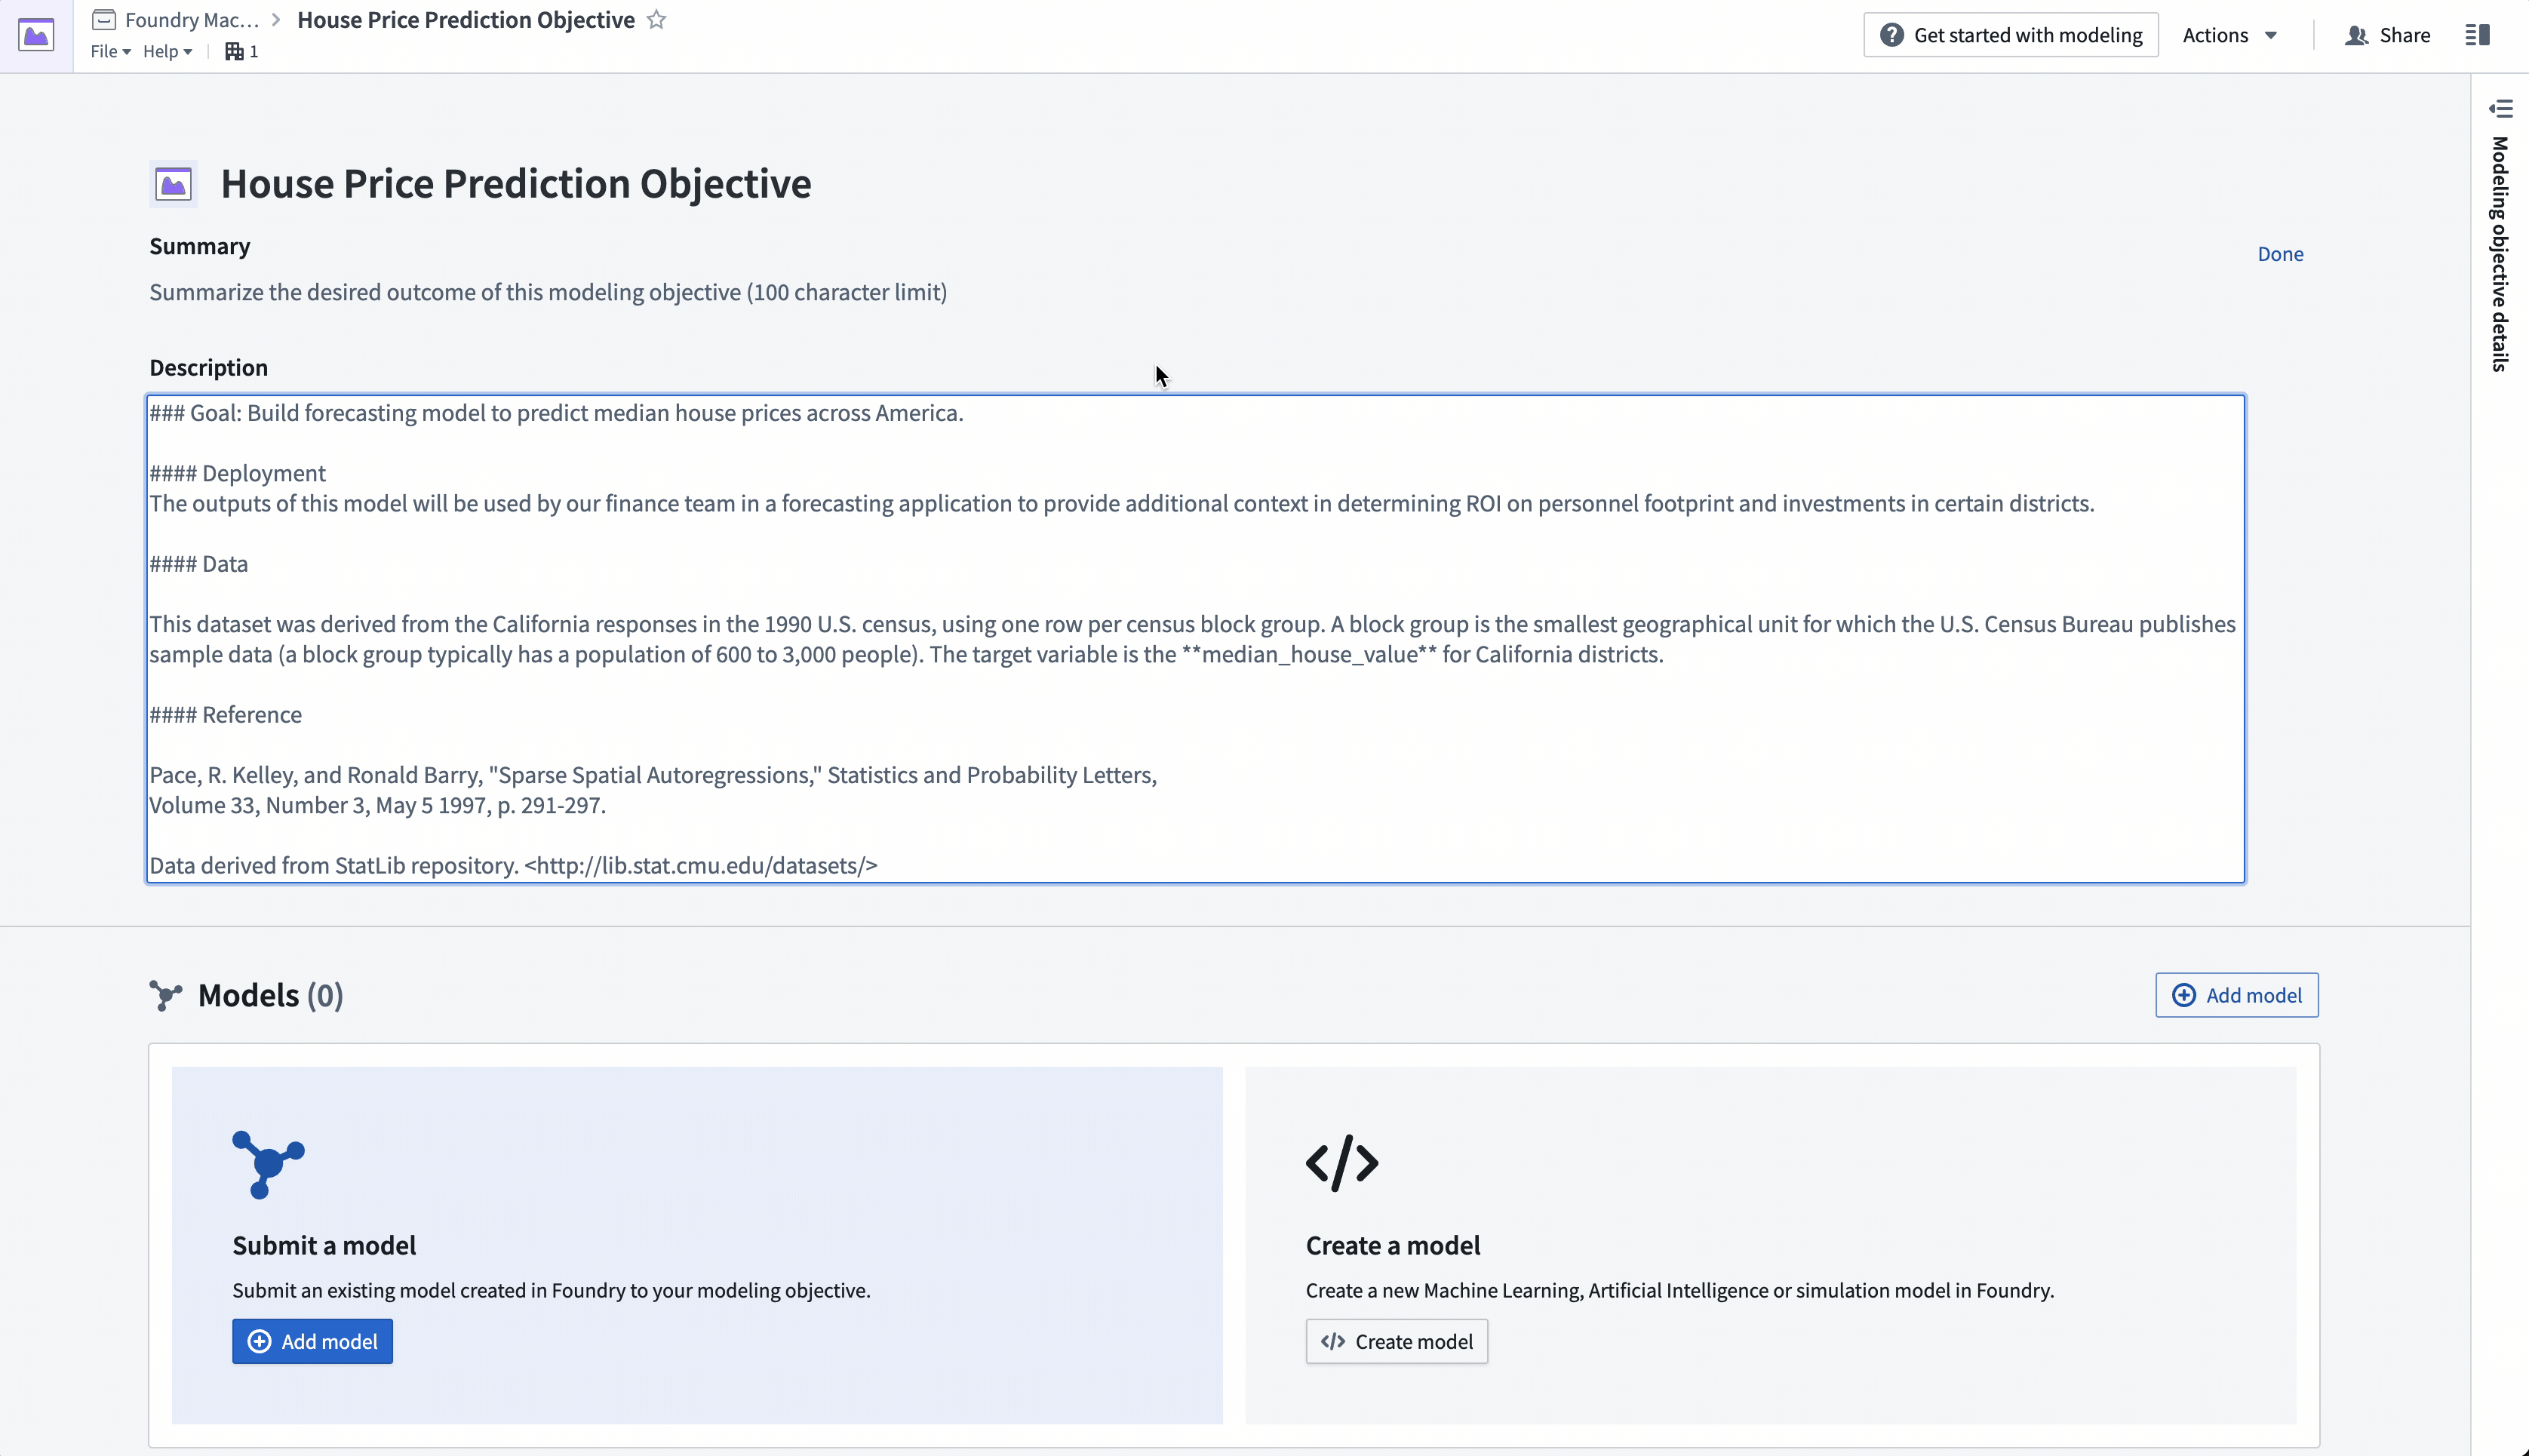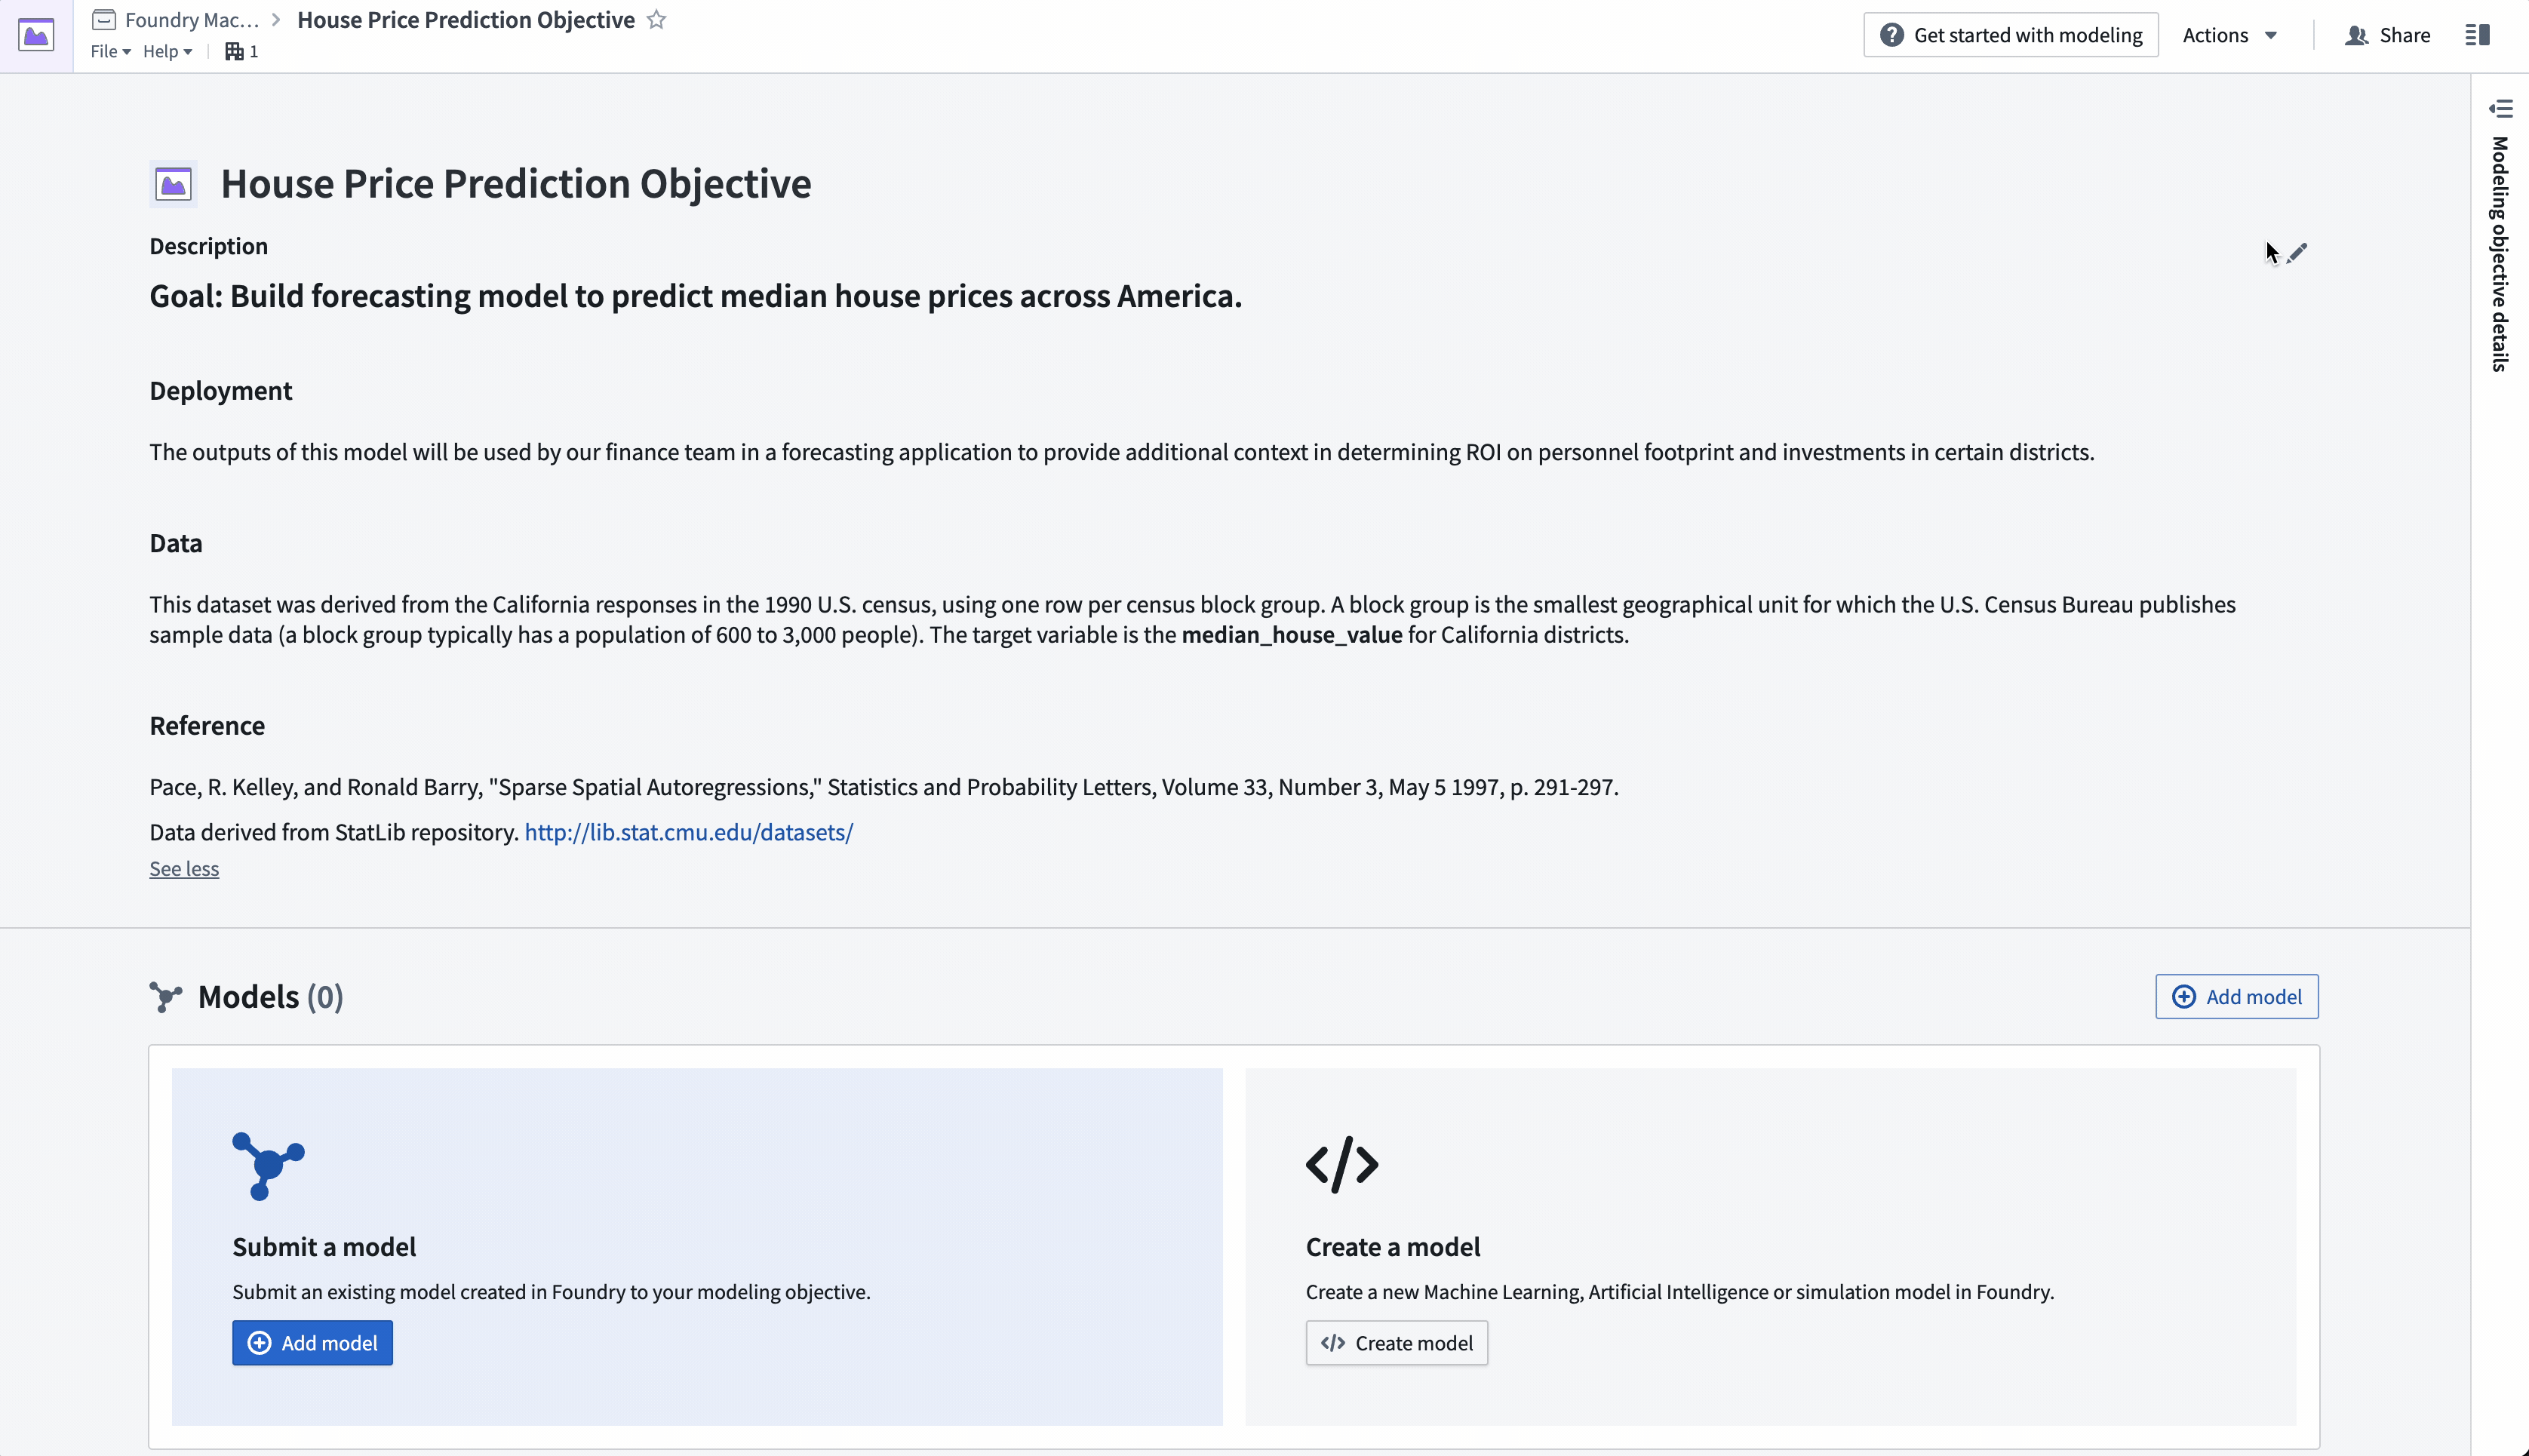
操作: 先ほど作成した「House Price Prediction Objective」モデリング目標に移動します。ほかのチームに問題を説明するため、モデリング目標のヘッダー部分にプロジェクトのコンテキストを追加します。ヘッダーの右側にあるペンアイコンを選択して編集モードに入り、目標の概要と説明を追加します。説明フィールドは Markdown をサポートしています。推奨する内容の例を以下に示します。
#### Goal: Build forecasting model to predict median house prices across America.

#### Data

This dataset was derived from the California responses in the 1990 U.S. census, using one row per census block group. A block group is the smallest geographical unit for which the U.S. Census Bureau publishes sample data (a block group typically has a population of 600 to 3,000 people).

The target variable is the **median_house_value** for California districts.

#### Reference

Pace, R. Kelley, and Ronald Barry, "Sparse Spatial Autoregressions," Statistics and Probability Letters,
Volume 33, Number 3, May 5 1997, p. 291-297.

Data derived from StatLib repository. <http://lib.stat.cmu.edu/datasets/>
次のステップ
機械学習プロジェクトの構成ができたので、モデルトレーニングに進みます。このチュートリアルの次のステップでは、Model Studio でモデルをトレーニングする、Jupyter® ノートブックでモデルをトレーニングする、または Code Repositories でモデルをトレーニングするのいずれかを選択します。迅速な反復型のモデル開発には Jupyter® ノートブックを、本番品質のデータパイプラインとモデルパイプラインには Code Repositories を推奨します。