注: 以下の翻訳の正確性は検証されていません。AIPを利用して英語版の原文から機械的に翻訳されたものです。
API:モデルまたは Modeling Objective のライブデプロイメントにクエリを実行する
モデルの直接デプロイメントでも Modeling Objective でも、ライブデプロイメントを作成し、HTTP エンドポイント経由でモデルをホストできます。ホストされたモデルは、ライブデプロイメントのクエリタブから、モデル上の Functions を通じて本番環境でモデルを使用することで、またはライブデプロイメント API を直接使用することでテストできます。
ホストされたモデルに直接クエリを実行するには、次のエンドポイントの選択肢から選びます。
- 複数 I/O(入力/出力)エンドポイント: 複雑なホストモデルや入力データ型に加え、入力と出力がそれぞれ1個の単純なモデルも扱える柔軟なエンドポイントです。複数 I/O エンドポイントの URL には
/v2という接尾辞が付き、「v2 エンドポイント」とも呼ばれます。 - 単一 I/O エンドポイント [サンセット]: 入力と出力がそれぞれ1個の API を持つ単純なホストモデルのみを扱えるレガシーエンドポイントです。単一 I/O エンドポイントは「v1 エンドポイント」とも呼ばれ、今後非推奨となる予定です。
単一 I/O エンドポイントは非推奨であり、Modeling Objective のデプロイメントでのみサポートされています。
複数 I/O エンドポイント
複数 I/O エンドポイントは、「v2 エンドポイント」とも呼ばれる、1個以上の入力と1個以上の出力をサポートする柔軟なエンドポイントです。
- URL:
<ENVIRONMENT_URL>/foundry-ml-live/api/inference/transform/ri.foundry-ml-live.<LIVE_DEPLOYMENT_RID>/v2<ENVIRONMENT_URL>:詳細は下記のセクションを参照してください。
- HTTP メソッド:
POST - 認証タイプ: Bearer トークン
- 必須 HTTP ヘッダー:
Content-Type:"application/json"である必要があります。Authorization:"Bearer <BEARER_TOKEN>"である必要があります。<BEARER_TOKEN>は認証トークンです。
- リクエスト本文: モデルに送信する情報を含む JSON オブジェクトです。期待される形式は、デプロイされたモデルの API によって異なります。
- 応答: 成功したレスポンスでは、ステータスコード
200と、モデルが返した推論レスポンスを表す JSON オブジェクトが返されます。このオブジェクトの形式は、現在デプロイされているモデルの API を反映します。
例:複数 I/O エンドポイントでライブデプロイメントにクエリを実行する
以下の例では、入力と出力がそれぞれ1個の単純な API を持つモデルを使用します。
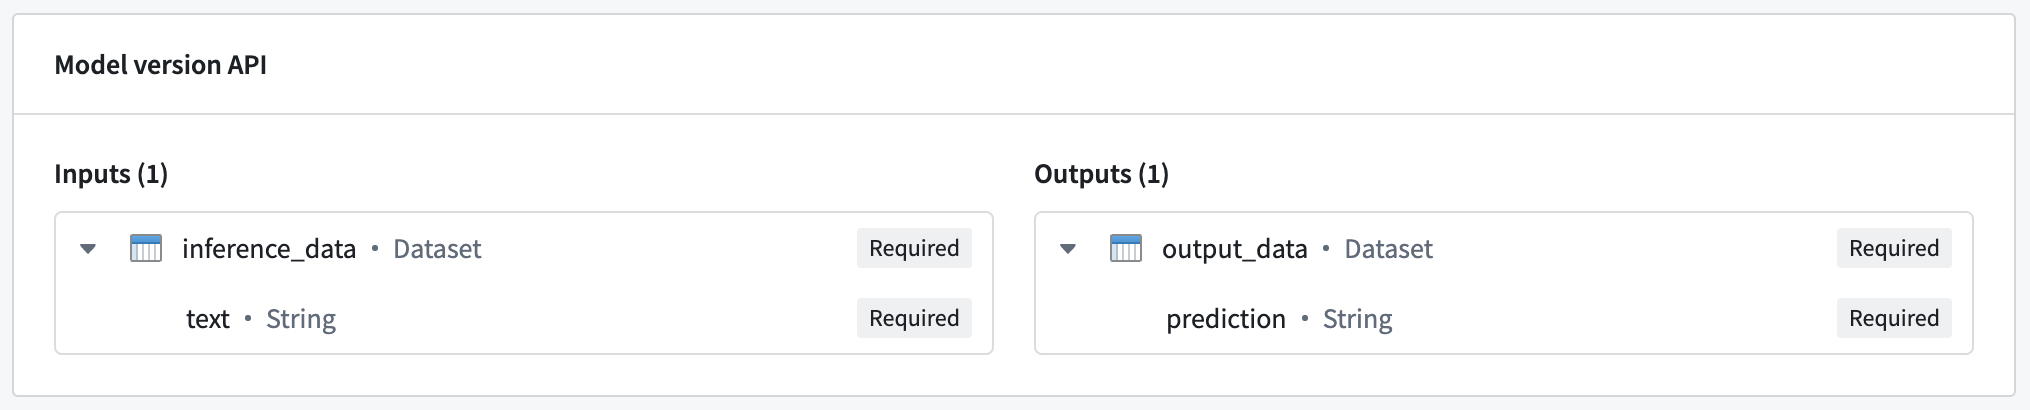
この例のホストモデルは、inference_data という名前の入力を1個受け取ります。この入力は、text 列を含むデータセットです。この場合、期待されるリクエスト形式は次のようになります。
Copied!1 2 3 4 5{ "inference_data": [{ "text": "<Text goes here>" }] }
モデルは、prediction 列を含む output_data という名前のデータセットを返します。これは、次のレスポンスに対応します。
Copied!1 2 3 4 5{ "output_data": [{ "prediction": "<Model prediction here>" }] }
例: curl
Copied!1curl --http2 -H "Content-Type: application/json" -H "Authorization: <BEARER_TOKEN>" -d '{ "inference_data": [ { "text": "Hello, how are you?" } ] }' --request POST <ENVIRONMENT_URL>/foundry-ml-live/api/inference/transform/ri.foundry-ml-live.<LIVE_DEPLOYMENT_RID>/v2
例: Python
Copied!1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16import requests url = '<ENVIRONMENT_URL>/foundry-ml-live/api/inference/transform/ri.foundry-ml-live.<LIVE_DEPLOYMENT_RID>/v2' inference_request = { 'inference_data': [ { 'text': 'Hello, how are you?' } ] } response = requests.post( url, json=inference_request, headers={ 'Content-Type': 'application/json', 'Authorization': 'Bearer <BEARER_TOKEN>' }) if response.ok: modelResult = response.json() print(modelResult) else: print("An error occurred")
例: JavaScript(Node.js 18 を使用)
Copied!1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28// リクエストを作成します const inferenceRequest = { "inference_data": [{ "text": "Hello, how are you?" }] }; // リクエストを送信します const response = await fetch( "<ENVIRONMENT_URL>/foundry-ml-live/api/inference/transform/ri.foundry-ml-live.<RID>/v2", { method: "POST", headers: { "Content-Type": "application/json", Authorization: "Bearer <BEARER_TOKEN>", }, body: JSON.stringify(inferenceRequest), } ); if (!response.ok) { throw Error(`${response.status}: ${response.statusText}`); } const result = await response.json(); console.log(result);
例:複数 I/O モデル
複数 I/O モデルは、複数の入力を受け取り、複数の出力を返すことができます。以下の画像は、複数の入力と出力を持つモデルの例です。
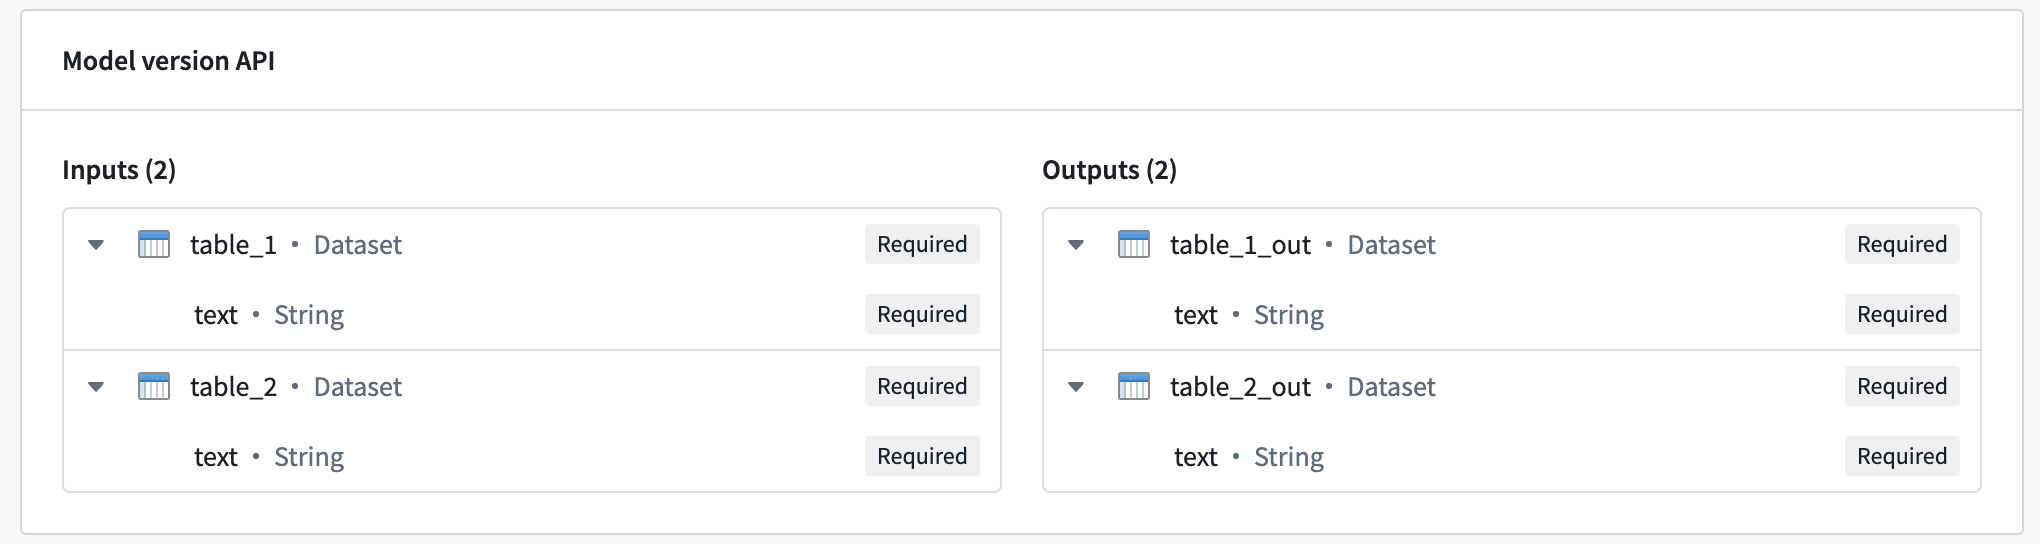
複数 I/O モデルにクエリを実行するには、前の例と同じリクエスト形式を使用し、inference_request に各入力に対応する名前付きフィールドを含めます。
Copied!1 2 3 4{ "table_1": [{ "text": "Text for table one" }], "table_2": [{ "text": "Text for table two" }] }
モデルも、各出力に対応する名前付きフィールドを含むオブジェクトを返します。
Copied!1 2 3 4{ "table_1_out": [{ "text": "Result for table one" }], "table_2_out": [{ "text": "Result for table two" }], }
単一 I/O エンドポイント
新しい実装では、単一 I/O エンドポイントは推奨されなくなりました。上記の、より柔軟な複数 I/O エンドポイントを優先してください。
- URL:
<ENVIRONMENT_URL>/foundry-ml-live/api/inference/transform/ri.foundry-ml-live.<LIVE_DEPLOYMENT_RID> <ENVIRONMENT_URL>:詳細は下記のセクションを参照してください。- HTTP メソッド:
POST - 認証タイプ: Bearer トークン
- 必須 HTTP ヘッダー:
Content-Type:"application/json"である必要があります。Authorization:"Bearer <BEARER_TOKEN>"である必要があります。<BEARER_TOKEN>は認証トークンです。
- リクエスト本文: 次のフィールドを含む JSON オブジェクトです。
requestData:モデルに送信する情報を含む配列です。期待される形式は、デプロイされたモデルの API によって異なります。
- 応答: 成功したレスポンスでは、ステータスコード
200と、次のフィールドを含む JSON オブジェクトが返されます。modelUuid:モデルを識別する文字列です。responseData:オブジェクトの配列で、各オブジェクトはモデルの推論レスポンスを表します。これらのオブジェクトの形式は、デプロイされたモデルの API によって異なります。
例:単一 I/O エンドポイントでライブデプロイメントにクエリを実行する
以下の例では、入力と出力がそれぞれ1個の単純な API を持つモデルを使用します。
この例のホストモデルは、inference_data という名前の入力を1個受け取ります。この入力は、text 列を含むデータセットです。この場合、期待されるリクエスト形式は次のようになります。
Copied!1 2 3 4{ "requestData": [{ "text": "<Text goes here>" }], "requestParams": {}, }
モデルは、prediction 列を含む output_data という名前のデータセットを返します。これは、次のレスポンスに対応します。
Copied!1 2 3 4 5 6{ "modelUuid": "000-000-000", "responseData": [{ "prediction": "<Model prediction here>" }] }
例: curl
Copied!1curl --http2 -H "Content-Type: application/json" -H "Authorization: <BEARER_TOKEN>" -d '{"requestData":[ { "text": "Hello, how are you?" } ], "requestParams":{}}' --request POST <ENVIRONMENT_URL>/foundry-ml-live/api/inference/transform/ri.foundry-ml-live.<RID>
例: Python
Copied!1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20import requests # この v1 エンドポイントはサンセット段階にあり、入力が1個 # かつ出力が1個のモデルでのみ動作します。より汎用的な v2 エンドポイントの使用を推奨します。 url = '<ENVIRONMENT_URL>/foundry-ml-live/api/inference/transform/ri.foundry-ml-live.<RID>' inference_request = { 'requestData': [{ 'text': 'Hello, how are you?' }], 'requestParams': {}, } response = requests.post( url, json=inference_request, headers={ 'Content-Type': 'application/json', 'Authorization': 'Bearer <BEARER_TOKEN>' }) if response.ok: modelResult = response.json()['responseData'] print(modelResult) else: print("An error occurred")
例: JavaScript(Node.js 18 を使用)
Copied!1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29// リクエストを作成します const inferenceRequest = { requestData: [{ text: "Hello, how are you?" }], requestParams: {}, }; // リクエストを送信します。 // この v1 エンドポイントはサンセット段階にあり、入力が1個 // かつ出力が1個のモデルでのみ動作します。v1 ではなく v2 エンドポイントを使用してください。 const response = await fetch( "<ENVIRONMENT_URL>/foundry-ml-live/api/inference/transform/ri.foundry-ml-live.<RID>", { method: "POST", headers: { "Content-Type": "application/json", Authorization: "Bearer <BEARER_TOKEN>", }, body: JSON.stringify(inferenceRequest), } ); if (!response.ok) { throw Error(`${response.status}: ${response.statusText}`); } const result = await response.json(); console.log(result.responseData);
環境 URL
上記の例では、<ENVIRONMENT_URL> プレースホルダーは環境の URL を表します。環境 URL を取得するには、デプロイメントのクエリタブから curl リクエストをコピーし、URL を抽出します。
エラー処理
最も一般的な HTTP エラーコードの詳細は次のとおりです。
- 400: 無効なリクエストまたはモデルの失敗によって発生します。
- 通常、モデルの推論中に発生した例外が原因です。通常、デバッグに役立つスタックトレースがレスポンス本文に含まれます。
- リクエストがモデル API に準拠していない場合にも、このエラーコードが返されます。
- 422: リクエストの形式が適切でないために発生します。リクエスト内の JSON が有効で、期待される形式であることを確認してください。
- 429: リクエストが多すぎるために発生します。バックオフを適用して再試行するか、同時実行数を減らしてください。レート制限は環境によって異なります。
- 500: 内部サーバーエラーまたはデプロイメントエラーによって発生します。手動での対応が必要になる場合があります。
- 503: サービスまたはデプロイメントは利用できません。これは、デプロイメントのリソースが不足している場合、メモリーが不足している場合、これ以上のリクエストを同時に処理できない場合、または自動的に再起動を試みている場合に発生することがあります。バックオフを適用して再試行してください。手動での対応が必要になる場合があります。