注: 以下の翻訳の正確性は検証されていません。AIPを利用して英語版の原文から機械的に翻訳されたものです。
コード定義の入力フィルタリング
トランスフォームのプレビューのドキュメントで説明している入力戦略の設定「サンプリング済み」と「データセット全体」に加えて、VS Code のプレビューでは「コード定義のフィルター」という選択肢もサポートしています。これにより、トランスフォームのプレビュー時に読み込むデータを厳密に制御するカスタム Python 関数を記述できます。ランダムサンプリングやデータセット全体の読み込みに頼るのではなく、使用するデータのサブセットを決めるロジックを正確に定義できます。
適用可能な場合、これらのフィルターは述語プッシュダウン ↗を活用し、最も関連性の高いデータサンプルのみが読み込まれるようにします。Palantir extension for Visual Studio Code は、リポジトリ内でフィルターとして使用できる条件を満たすすべての関数を自動的に見つけ、プレビューの設定時にドロップダウンメニューに表示します。
コード定義のフィルターを使用する理由は何ですか?
特定のシナリオをテストする: 関係のないデータを選別することなく、開発で重要なエッジケースや特定のデータ条件に集中できます。
再利用可能なロジックを作成する: フィルターを1度記述すれば、複数のプレビューセッションで使用でき、開発ワークフローの一貫性が高まります。
パフォーマンスを微調整する: データセット全体の読み込みにも時間がかかる大規模なデータセットでは、フィルタリングするデータを厳密に指定して最適化できます。
複数のフィルターを組み合わせる: 複数のフィルターを選択し、任意の順序で連結して、高度なサンプリング戦略を作成できます。
コード定義のフィルターを使用する方法
プレビュー用のフィルターを選択する
- プレビューパネルで入力戦略を設定するを選択します。
- コード定義のフィルターを選択します。
- 組み込みフィルターの一覧から選択するか、ご自身で作成したフィルターを選択します。
- フィルターを希望する順序に並べます。フィルターは順番に適用されます。
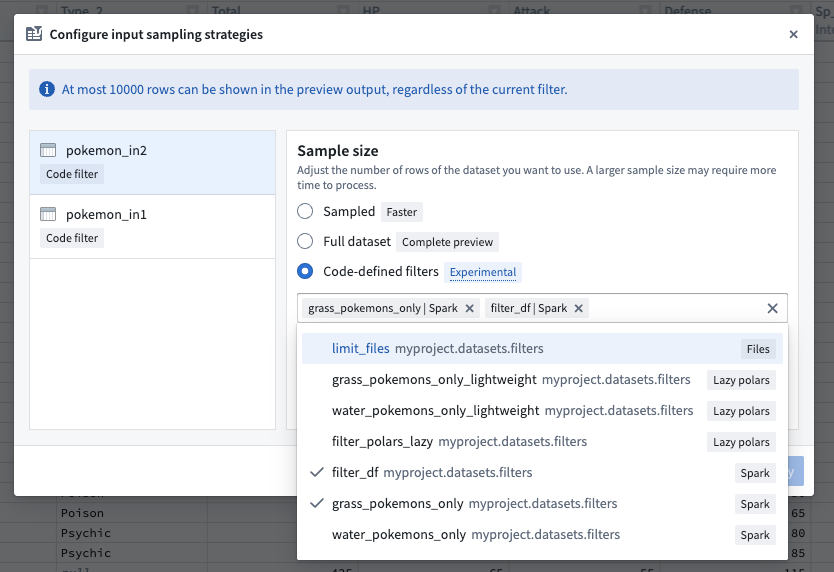
拡張機能は、プロジェクトのコードベース内のどこにあっても、条件を満たすすべてのフィルターを自動的に見つけ、選択用のドロップダウンメニューに表示します。
フィルター関数を作成する
Python 関数からプレビュー用のフィルターとして使用できるものを作成するには、以下のルールに従う必要があります。
関数の要件
関数は次の条件を満たす必要があります
- モジュールのグローバルスコープで直接定義されていること
- 次のいずれかのシグネチャで、型注釈が完全に付けられていること。
- Spark トランスフォームの場合:
(pyspark.sql.DataFrame) -> pyspark.sql.DataFrame - 軽量トランスフォームの場合:
(polars.LazyFrame) -> polars.LazyFrame - 生ファイルの場合:
(collections.abc.Iterator[transforms.api.FileStatus]) -> collections.abc.Iterator[transforms.api.FileStatus]
- Spark トランスフォームの場合:
関数は次のいずれにも該当してはいけません
- ネストされている
if、with、forなどの文の内部で定義されている- クラスの一部である
- 別の場所からインポートされている
- 関数が代入された変数である
async関数またはプライベート関数である(関数名は_で始めることはできません)- デコレーターが適用されている
フィルター関数の例
次の例には、有効なプレビュー用のフィルター関数がいくつか含まれています。
Copied!1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19from pyspark.sql import DataFrame from pyspark.sql import functions as F from collections.abc import Iterator from transforms.api import FileStatus import itertools as it import polars as pl def limit_files(files: Iterator[FileStatus]) -> Iterator[FileStatus]: """ ファイルシステムの一覧に含まれるファイル数を制限します。""" return it.islice(files, 10) def ocean_animals_only(df: DataFrame) -> DataFrame: """ 海に生息する動物のみを取得します """ return df.filter(F.col("Habitat") == "Ocean") def grassland_animals_only_lightweight(df: pl.LazyFrame) -> pl.LazyFrame: """ 草原に生息する動物のみを取得します """ return df.filter(pl.col("Habitat") == "Grassland")
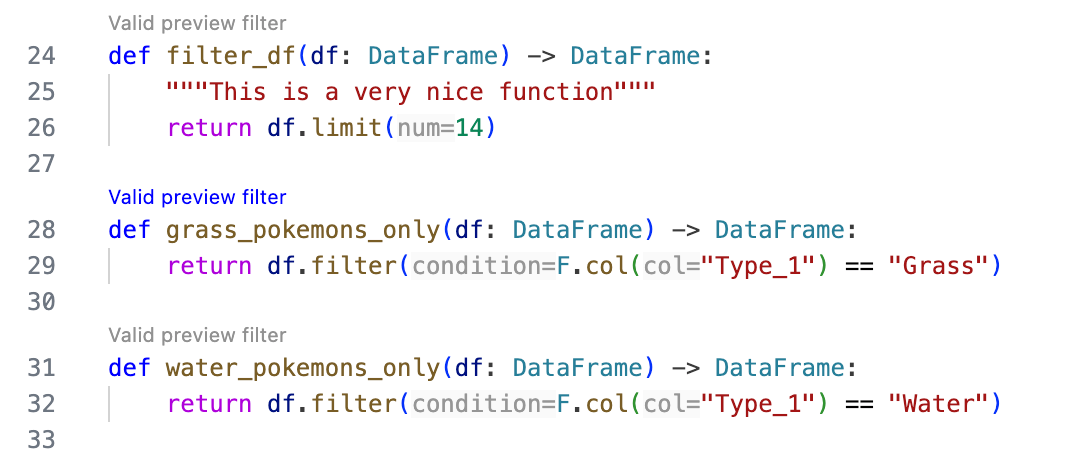
フィルター関数の上に表示される CodeLens ヒントによって、関数が使用条件を満たしているかどうかのフィードバックをすぐに確認できます。
フィルターにパラメーターを追加する
パラメーターを追加すると、フィルターの柔軟性を高められます。これにより、さまざまなシナリオに対応する、汎用的で再利用可能なフィルター関数を作成できます。
パラメーターを追加する方法
- 関数シグネチャに型注釈付きのパラメーターを定義します。
- パラメーターの前に
*記号を追加し、キーワード専用引数として指定します。 - 拡張機能がこれらのパラメーターを自動的に検出し、フィルターを選択すると値の入力を求めるダイアログが表示されます。
次に、パラメーターを使用する例を示します。
Copied!1 2 3 4 5 6from pyspark.sql import DataFrame from pyspark.sql import functions as F def filter_animals_by_habitat(df: DataFrame, *, habitat: str) -> DataFrame: """ 海に生息する動物のみを取得します """ return df.filter(F.col("Habitat") == habitat)
habitat パラメーターの前にある * 記号に注目してください。この記号により、パラメーターはキーワード専用引数に分類されます。
サポートされているパラメーターのデータ型
現在サポートされているパラメーターのデータ型は次のとおりです。
strintfloatbool
デフォルト値を指定する
関数シグネチャでパラメーターのデフォルト値を指定できます。デフォルト値を指定すると、パラメーターは任意になり、設定時に値を入力しなかった場合はデフォルト値が使用されます。
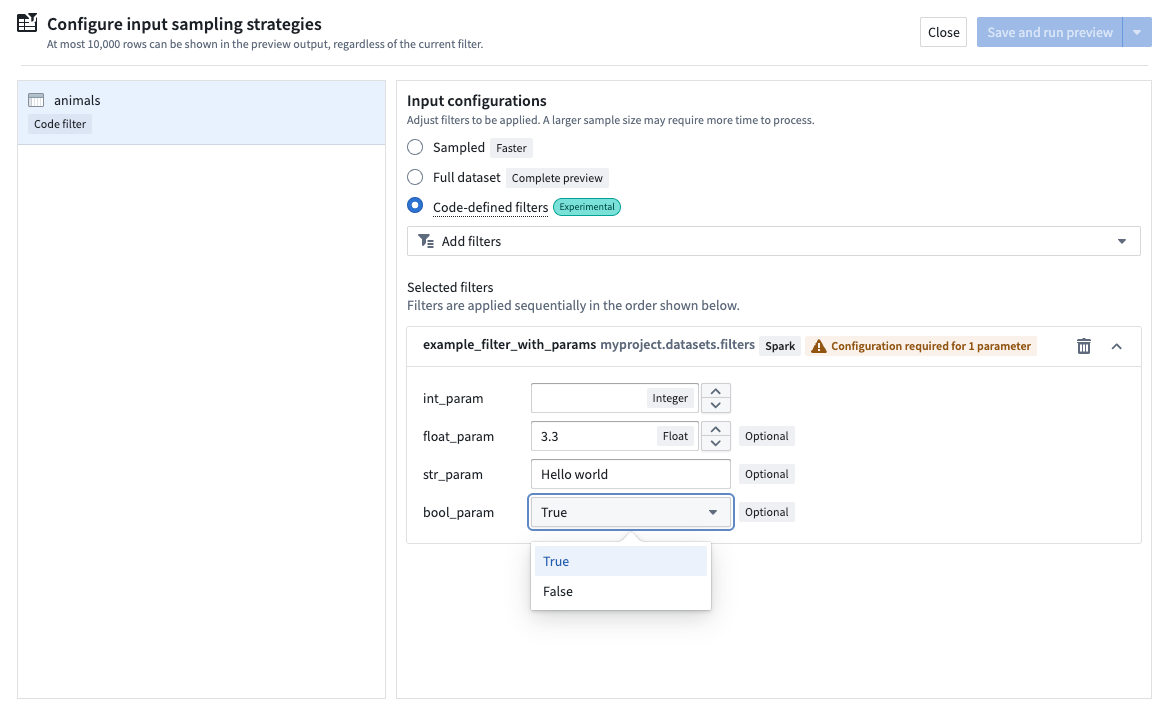
Copied!1 2 3 4 5 6 7 8 9from pyspark.sql import DataFrame from pyspark.sql import functions as F def example_filter_with_params( df: DataFrame, *, int_param: int, float_param: float = 3.3, str_param: str = "Hello world", bool_param: bool = True ) -> DataFrame: """異なるデータ型のパラメーターを多数持つ関数の例です""" print(f"int_param: {int_param}, float_param: {float_param}, str_param: {str_param}, bool_param: {bool_param}") return df.limit(int_param)
プレビュー用にパラメーター付きのフィルターを選択すると、パラメーターごとにプロンプトが表示されます。
サポートされている入力の種類
フィルター選択用のドロップダウンメニューには、使用可能なフィルターが表示されます。ただし、トランスフォームのコンテキストに応じて、特定の種類のフィルターを選択するほうが適している場合があります。
- Spark トランスフォームで構造化入力を扱う場合:
DataFrameフィルターを使用します。 - 軽量トランスフォームで構造化入力を扱う場合:
LazyFrameフィルターを使用します。 - Spark または軽量トランスフォームで非構造化入力(生ファイル)を扱う場合:
Iterator[FileStatus]フィルターを使用します。