注: 以下の翻訳の正確性は検証されていません。AIPを利用して英語版の原文から機械的に翻訳されたものです。
評価スイートを作成する
評価スイートは、対象関数のパフォーマンスを測定するために使用するテストケースと評価関数をまとめたものです。評価スイートを実行すると、テストケースごとに対象関数が実行され、そのスイートに関連付けられた評価方法が使用されます。
AIP Logic 関数、AIP Chatbot 関数、コードで作成した関数などの対象関数に対して、評価スイートを作成できます。
AIP Logic 関数:AIP Logic で評価スイートの使用をはじめるには、Logic 関数の評価スイートを参照してください。
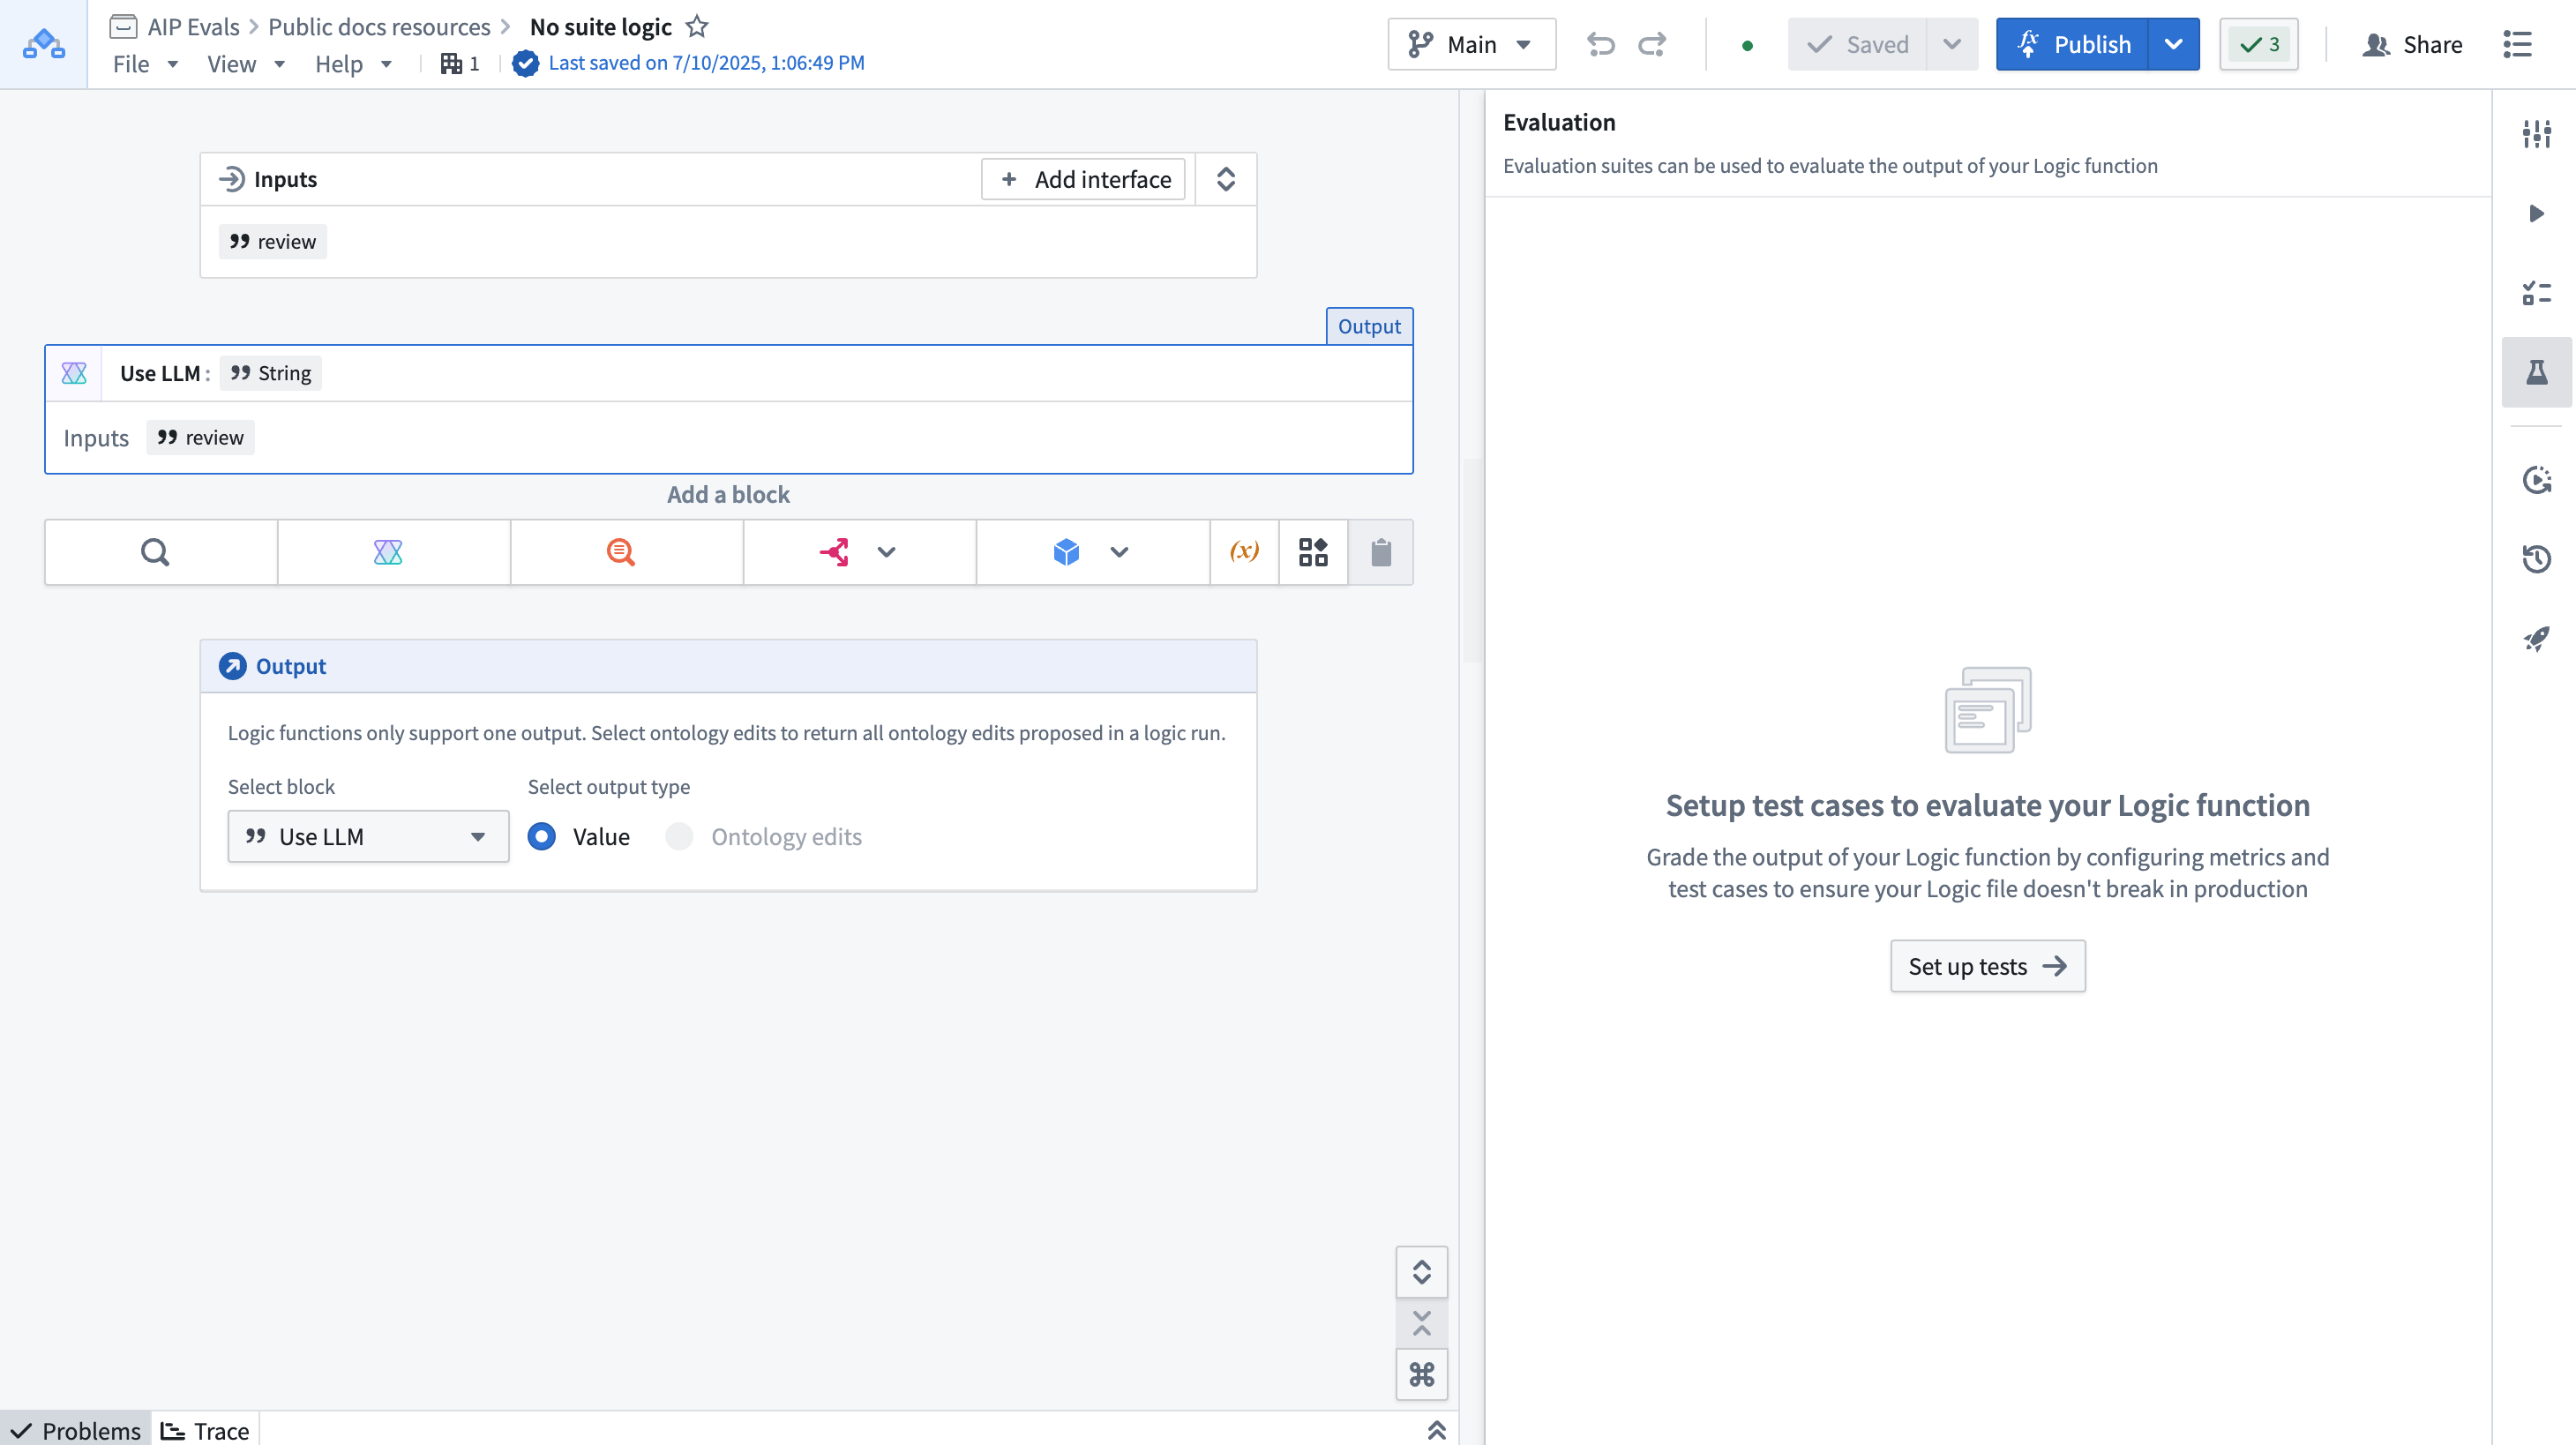
AIP Chatbot 関数:AIP Chatbot 関数をテストするには、まずチャットボットを関数として公開する必要があります。その後、左サイドバーの評価タブから評価スイートを作成できます。サイドバーが似ているため、詳細については、Logic 関数の評価スイートセクションに沿って進めることができます。

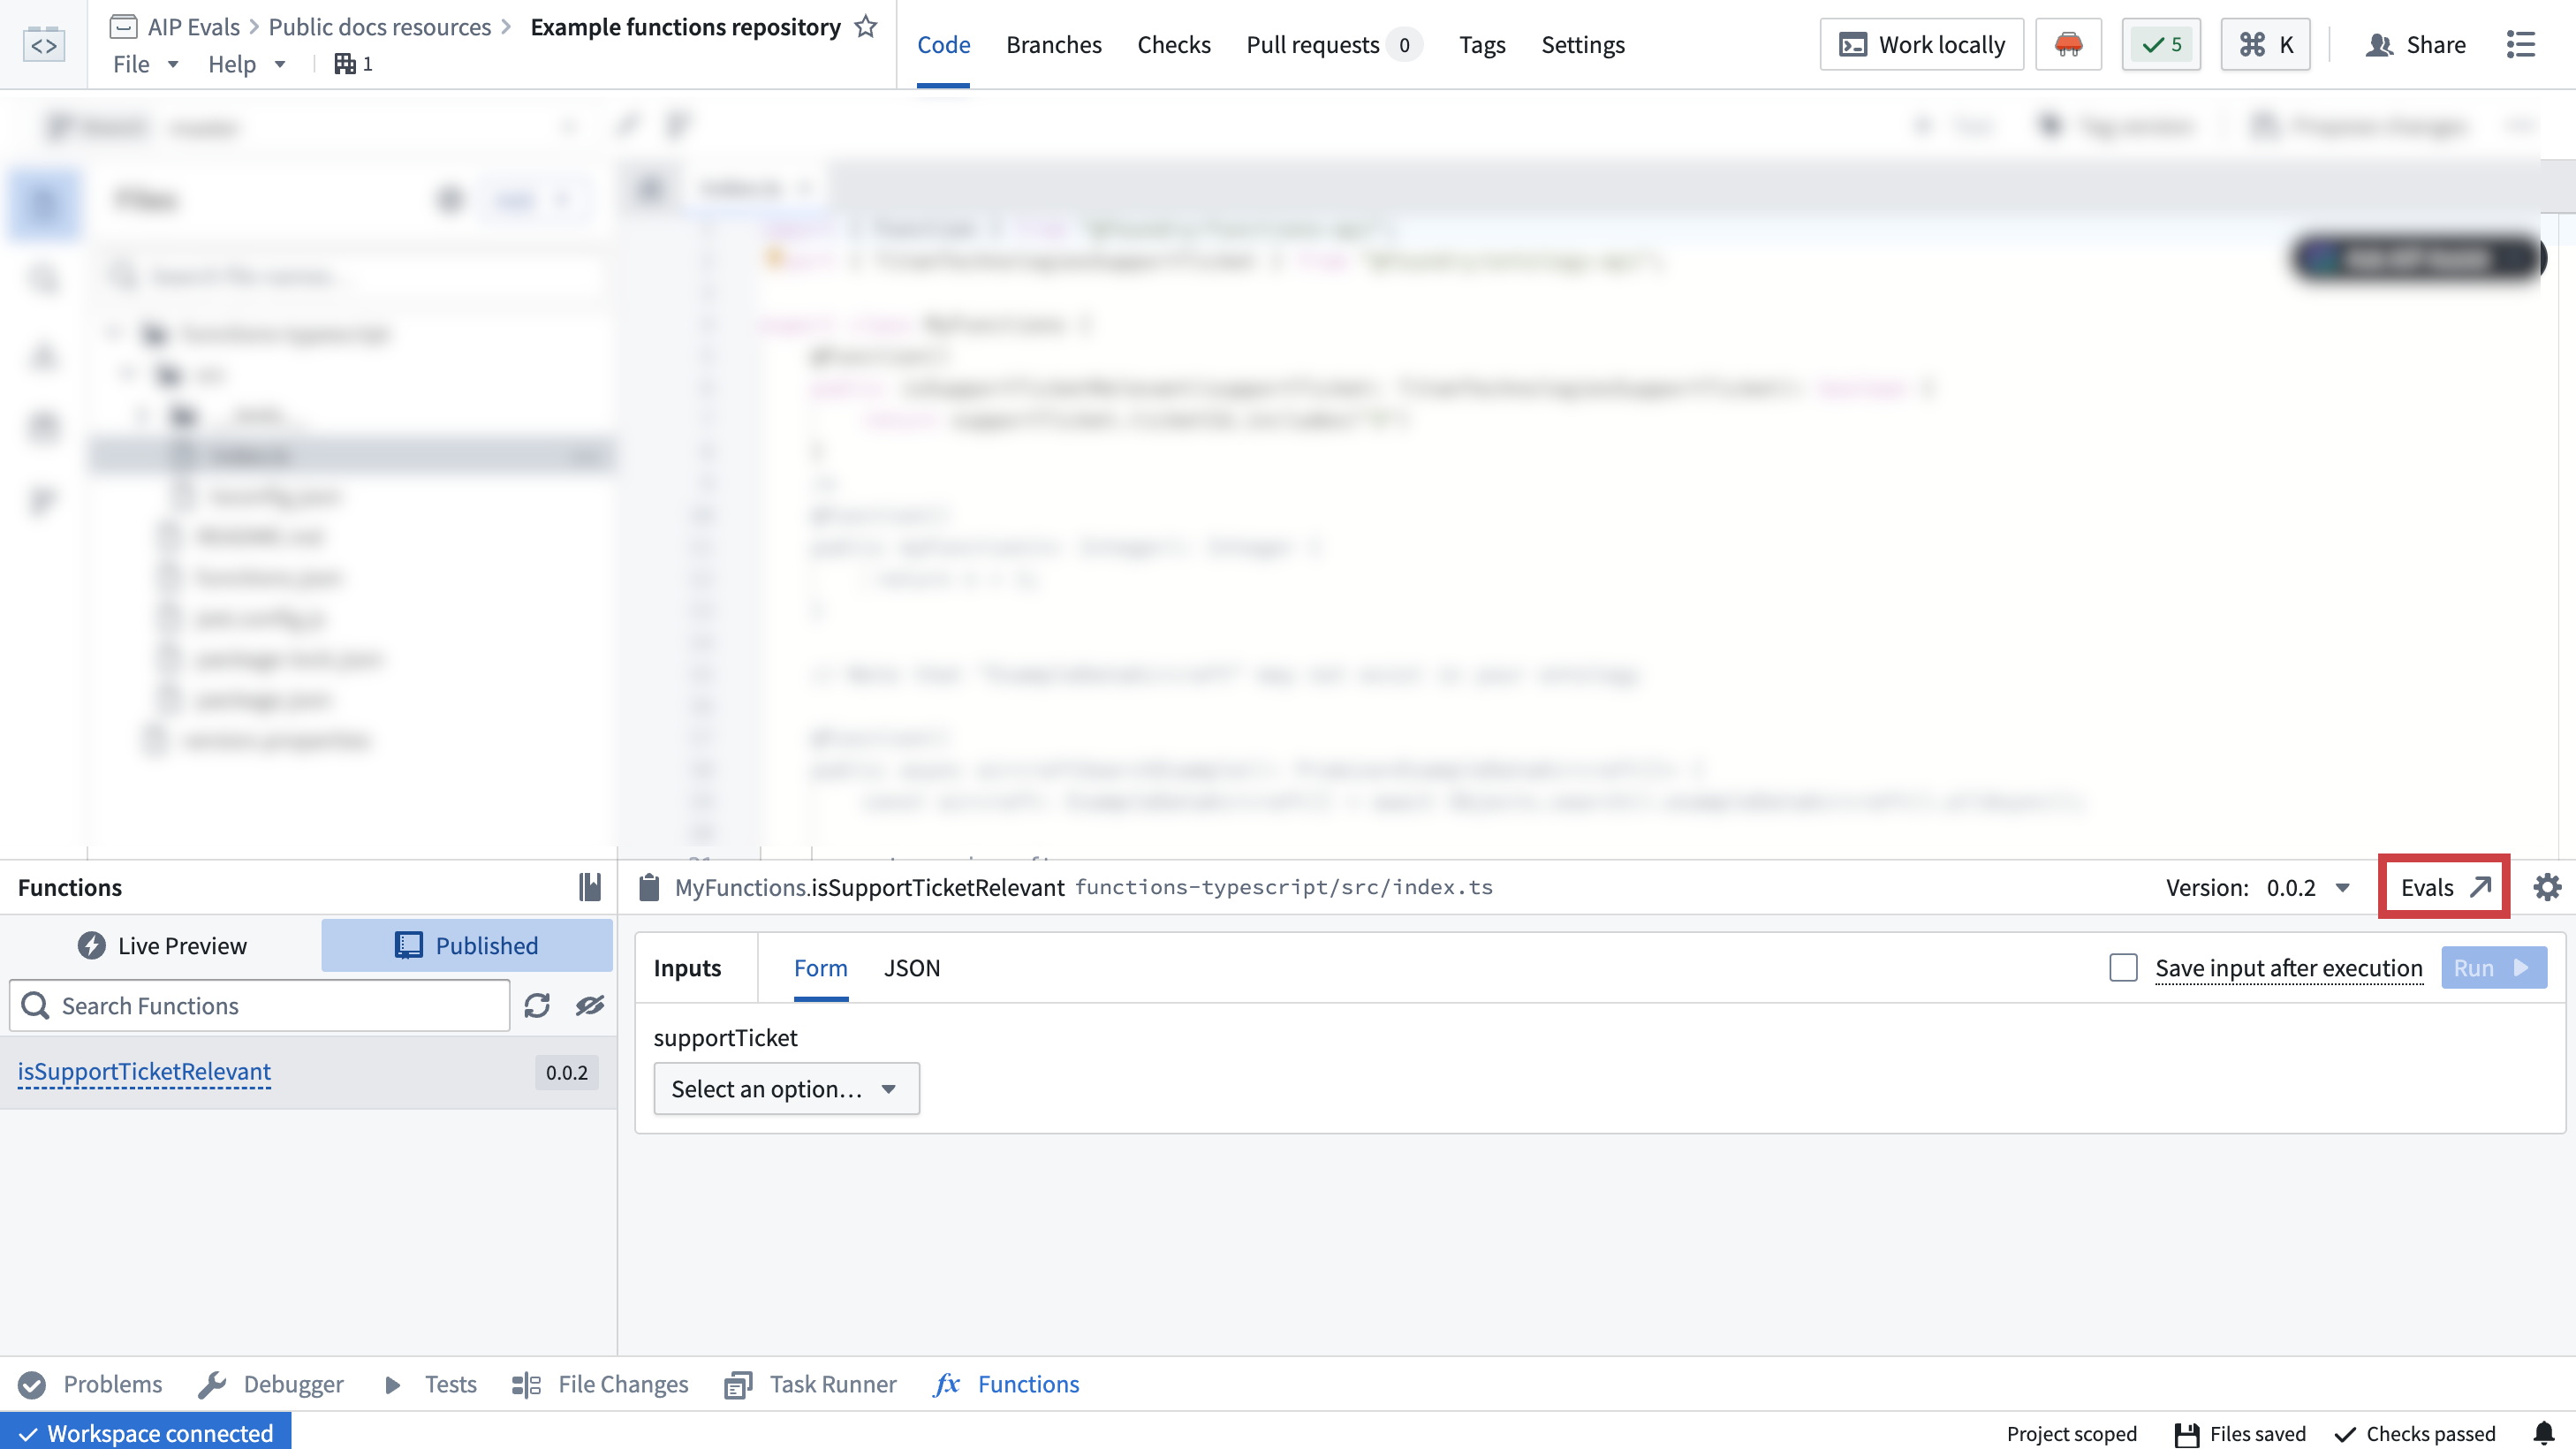
コードで作成した関数: Code Repositories で作成した関数の評価スイートは、Code Repositories > コード > 関数 > 公開済みに移動して、公開済みタブから直接作成したり開いたりできます。
追加の対象関数
対象関数を追加すると、同じ評価スイートで複数の関数をテストできます。これにより、公開済みの異なる Foundry 関数や Logic 関数に対して、一度に評価を実行できます。実装間でパフォーマンスを比較したり、類似する関数を同じテストケースで評価したりする場合に役立ちます。
対象関数を追加するには、AIP Evals で評価スイートを開き、スイートを編集を選択してから、ターゲット関数パネルでターゲット関数を追加を選択します。対象関数ごとに異なる入出力シグネチャを使用でき、評価ツールは対象関数ごとに設定します。
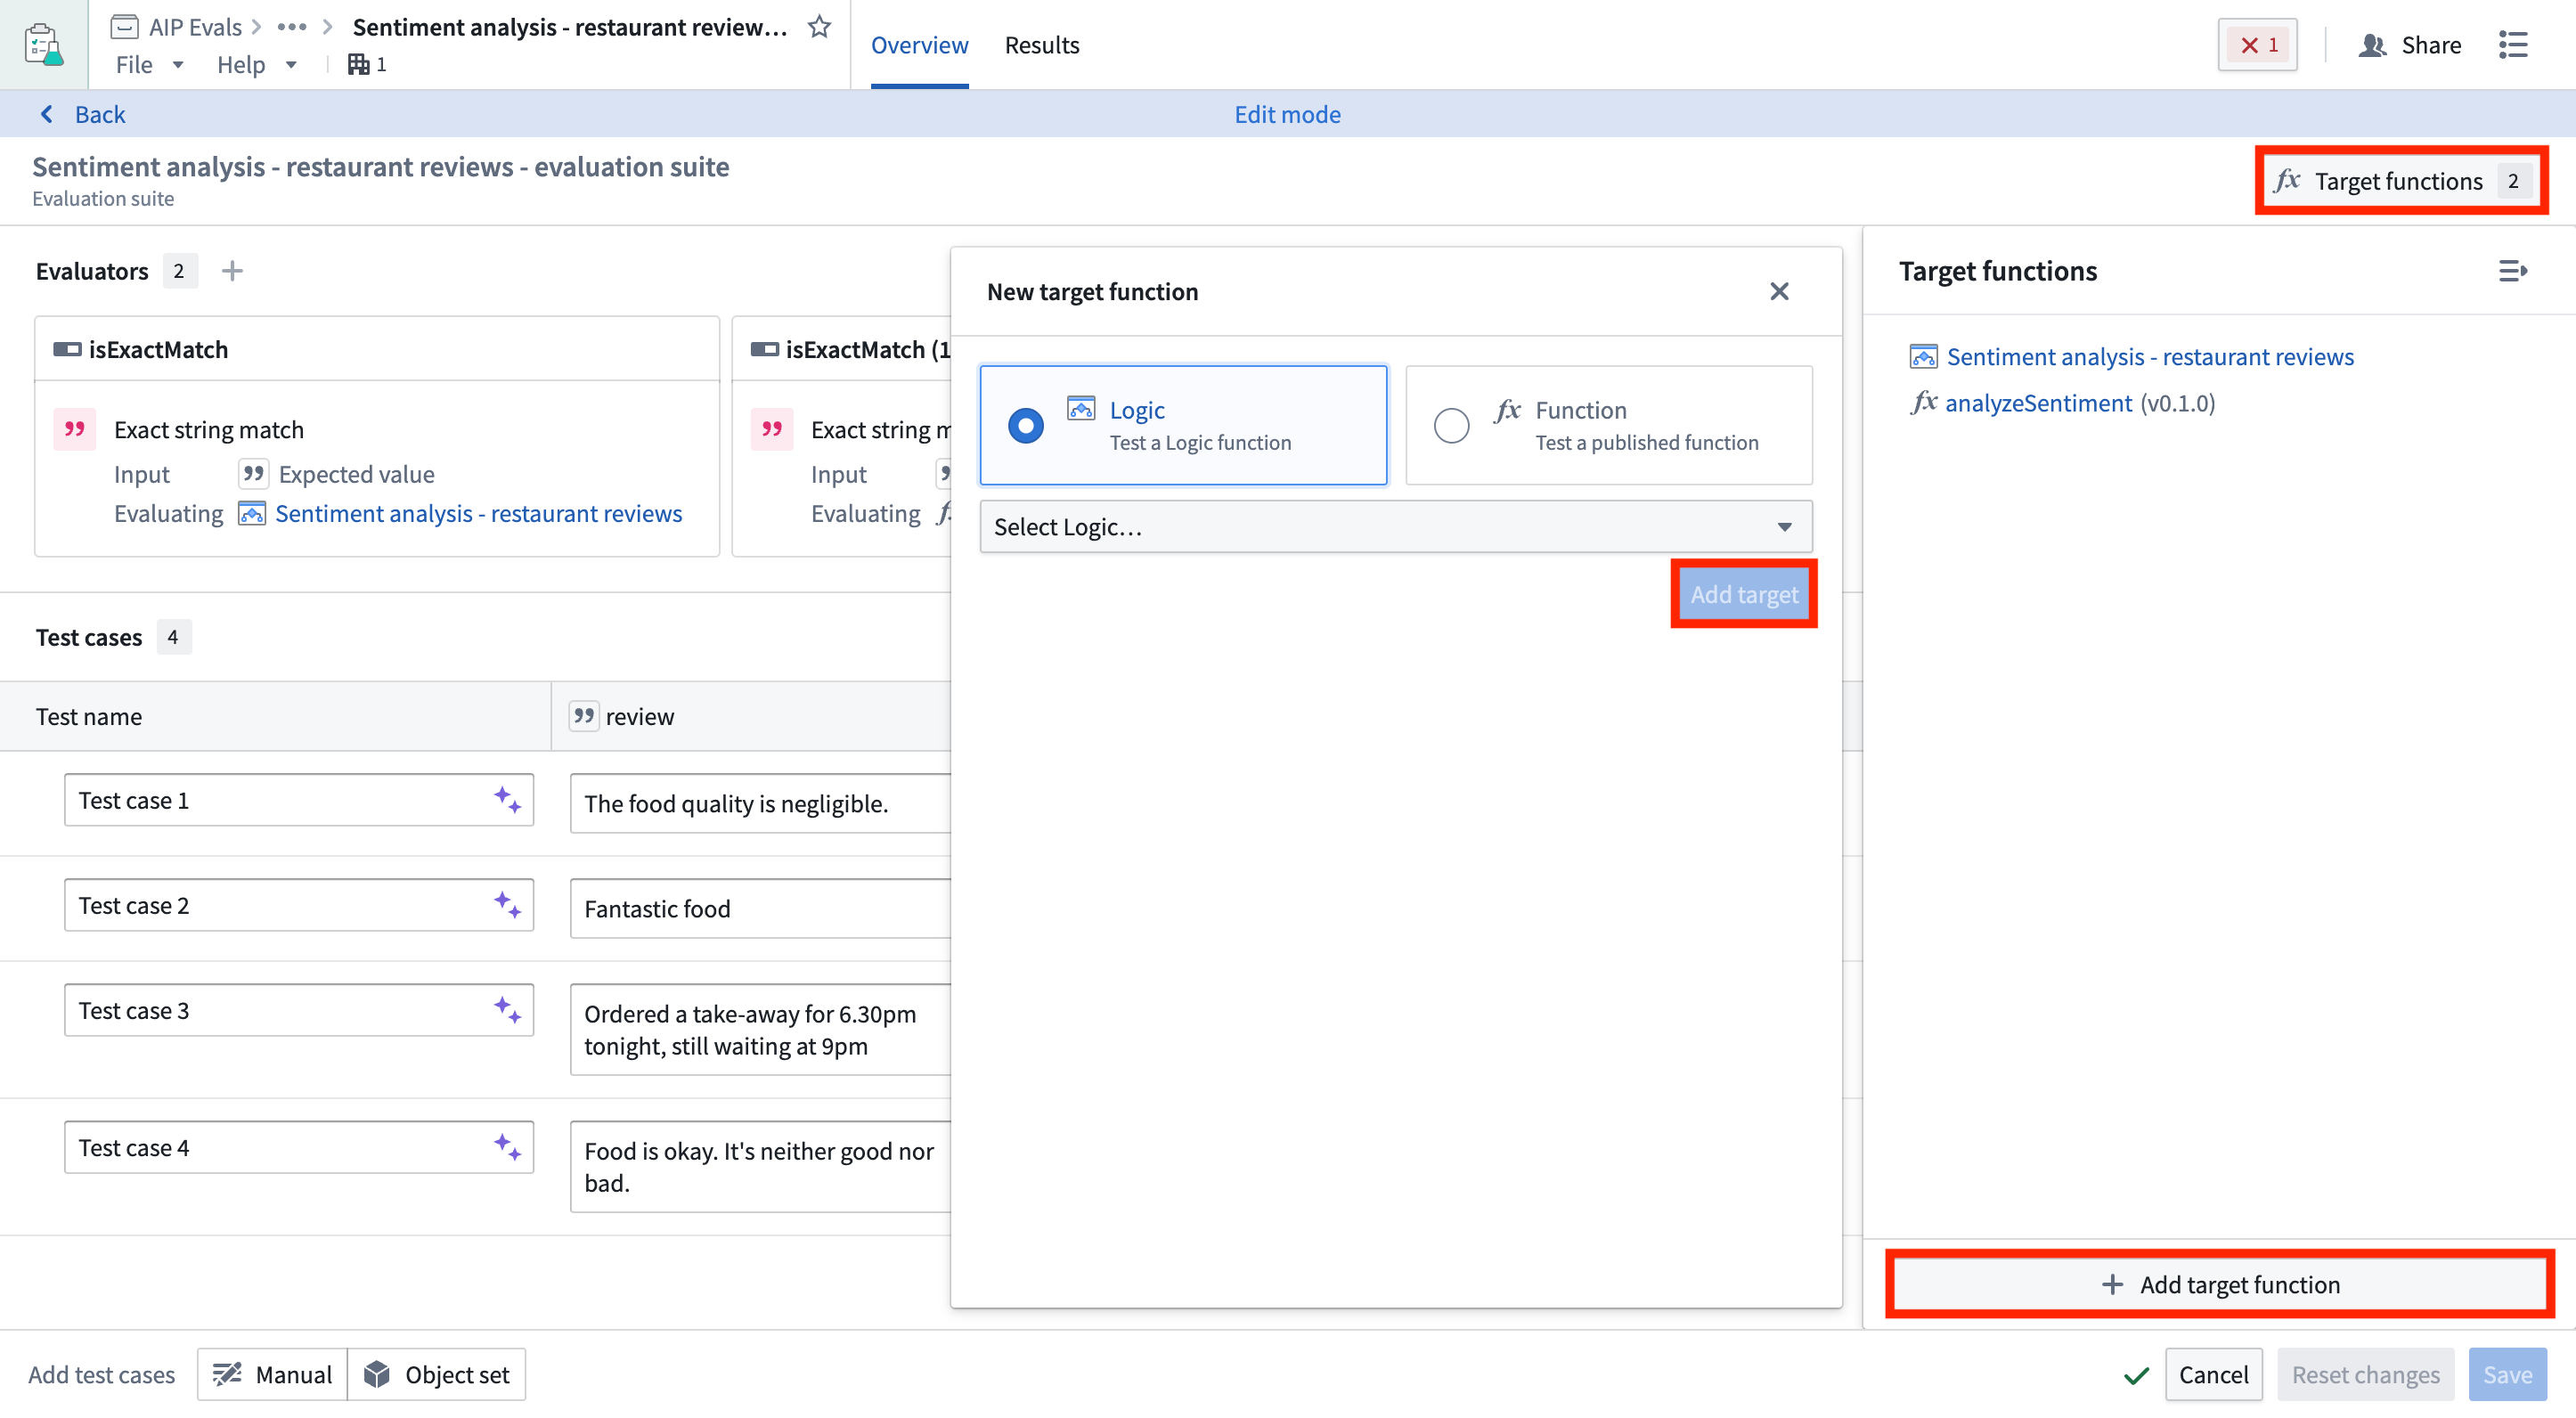
複数の対象関数を設定した場合は、評価スイートを実行する際に、含める対象関数を選択できます。
テストケースを追加する
評価スイートのテストケースは、個々のテストケースを手動で定義する方法、オブジェクトセットを使用して複数のテストケースを生成する方法、または同じスイート内で両方の方法を組み合わせることで作成できます。この柔軟性により、既存のオブジェクトセットを活用しながら、必要に応じて特定のテストケースを手動で追加できます。
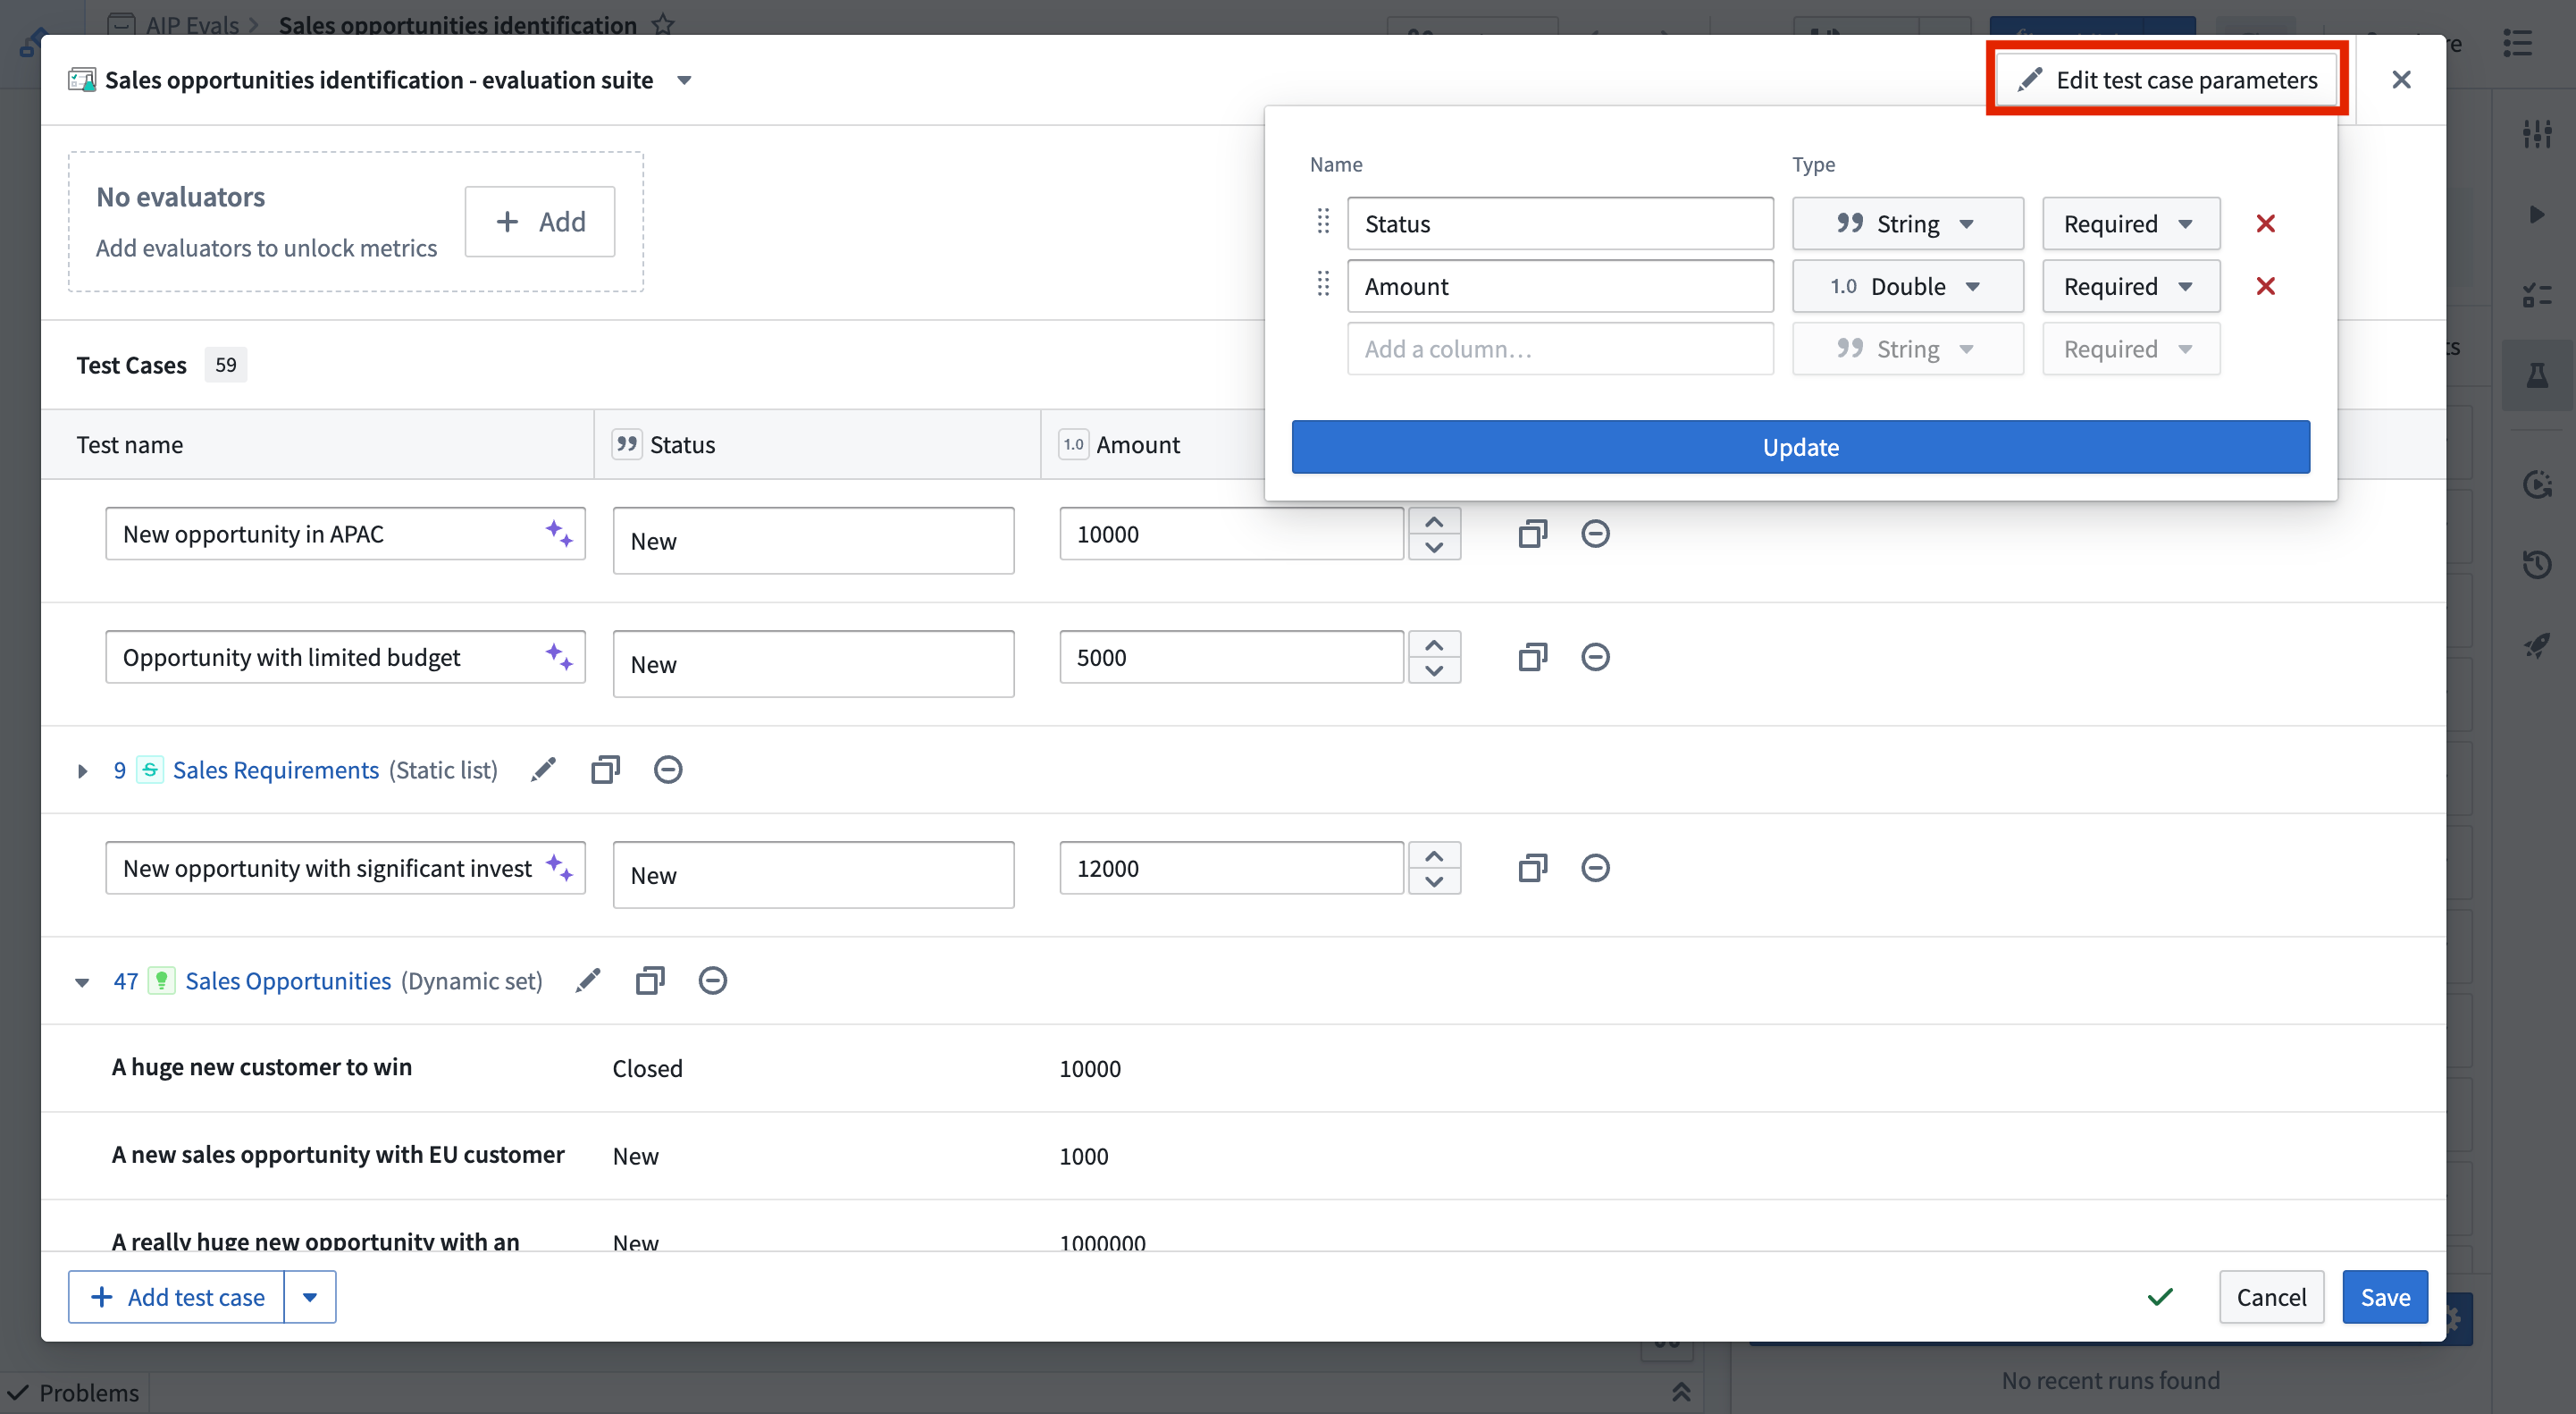
列を変更アイコンを選択すると、評価スイートの列を編集できます。その後、テストケースの列とそれぞれのデータ型を追加、削除、または並べ替えることができます。
手動のテストケース
テストケースを手動で定義するには、評価スイートの表示で、テストケースを追加の下にあるマニュアルを選択します。各テストケースに名前を付け、適切な列に入力と期待される値を定義します。テストケース名の横にある紫色の AIP の星アイコンを選択すると、おすすめの名前を生成できます。

この例では、おすすめの名前である「食品の品質に関する否定的なレビュー」は、「テストケース1」よりも多くの情報を伝えます。

手動のテストケースは、特定のエッジケースや、オブジェクトセットでは十分に網羅されていない可能性のあるシナリオをテストする場合、またはテストの入力と期待される出力を厳密に制御したい場合に最適です。
オブジェクトセットのテストケース
オブジェクトセットからテストケースを追加することもできます。この場合、選択したオブジェクトセットのオブジェクトが、それぞれのテストケースになります。オブジェクトセットのテストケースを追加するには、テストケースを追加の下にあるオブジェクトセットを選択します。オブジェクトセットの選択ダイアログで、使用するオブジェクトセットとプロパティを選択します。
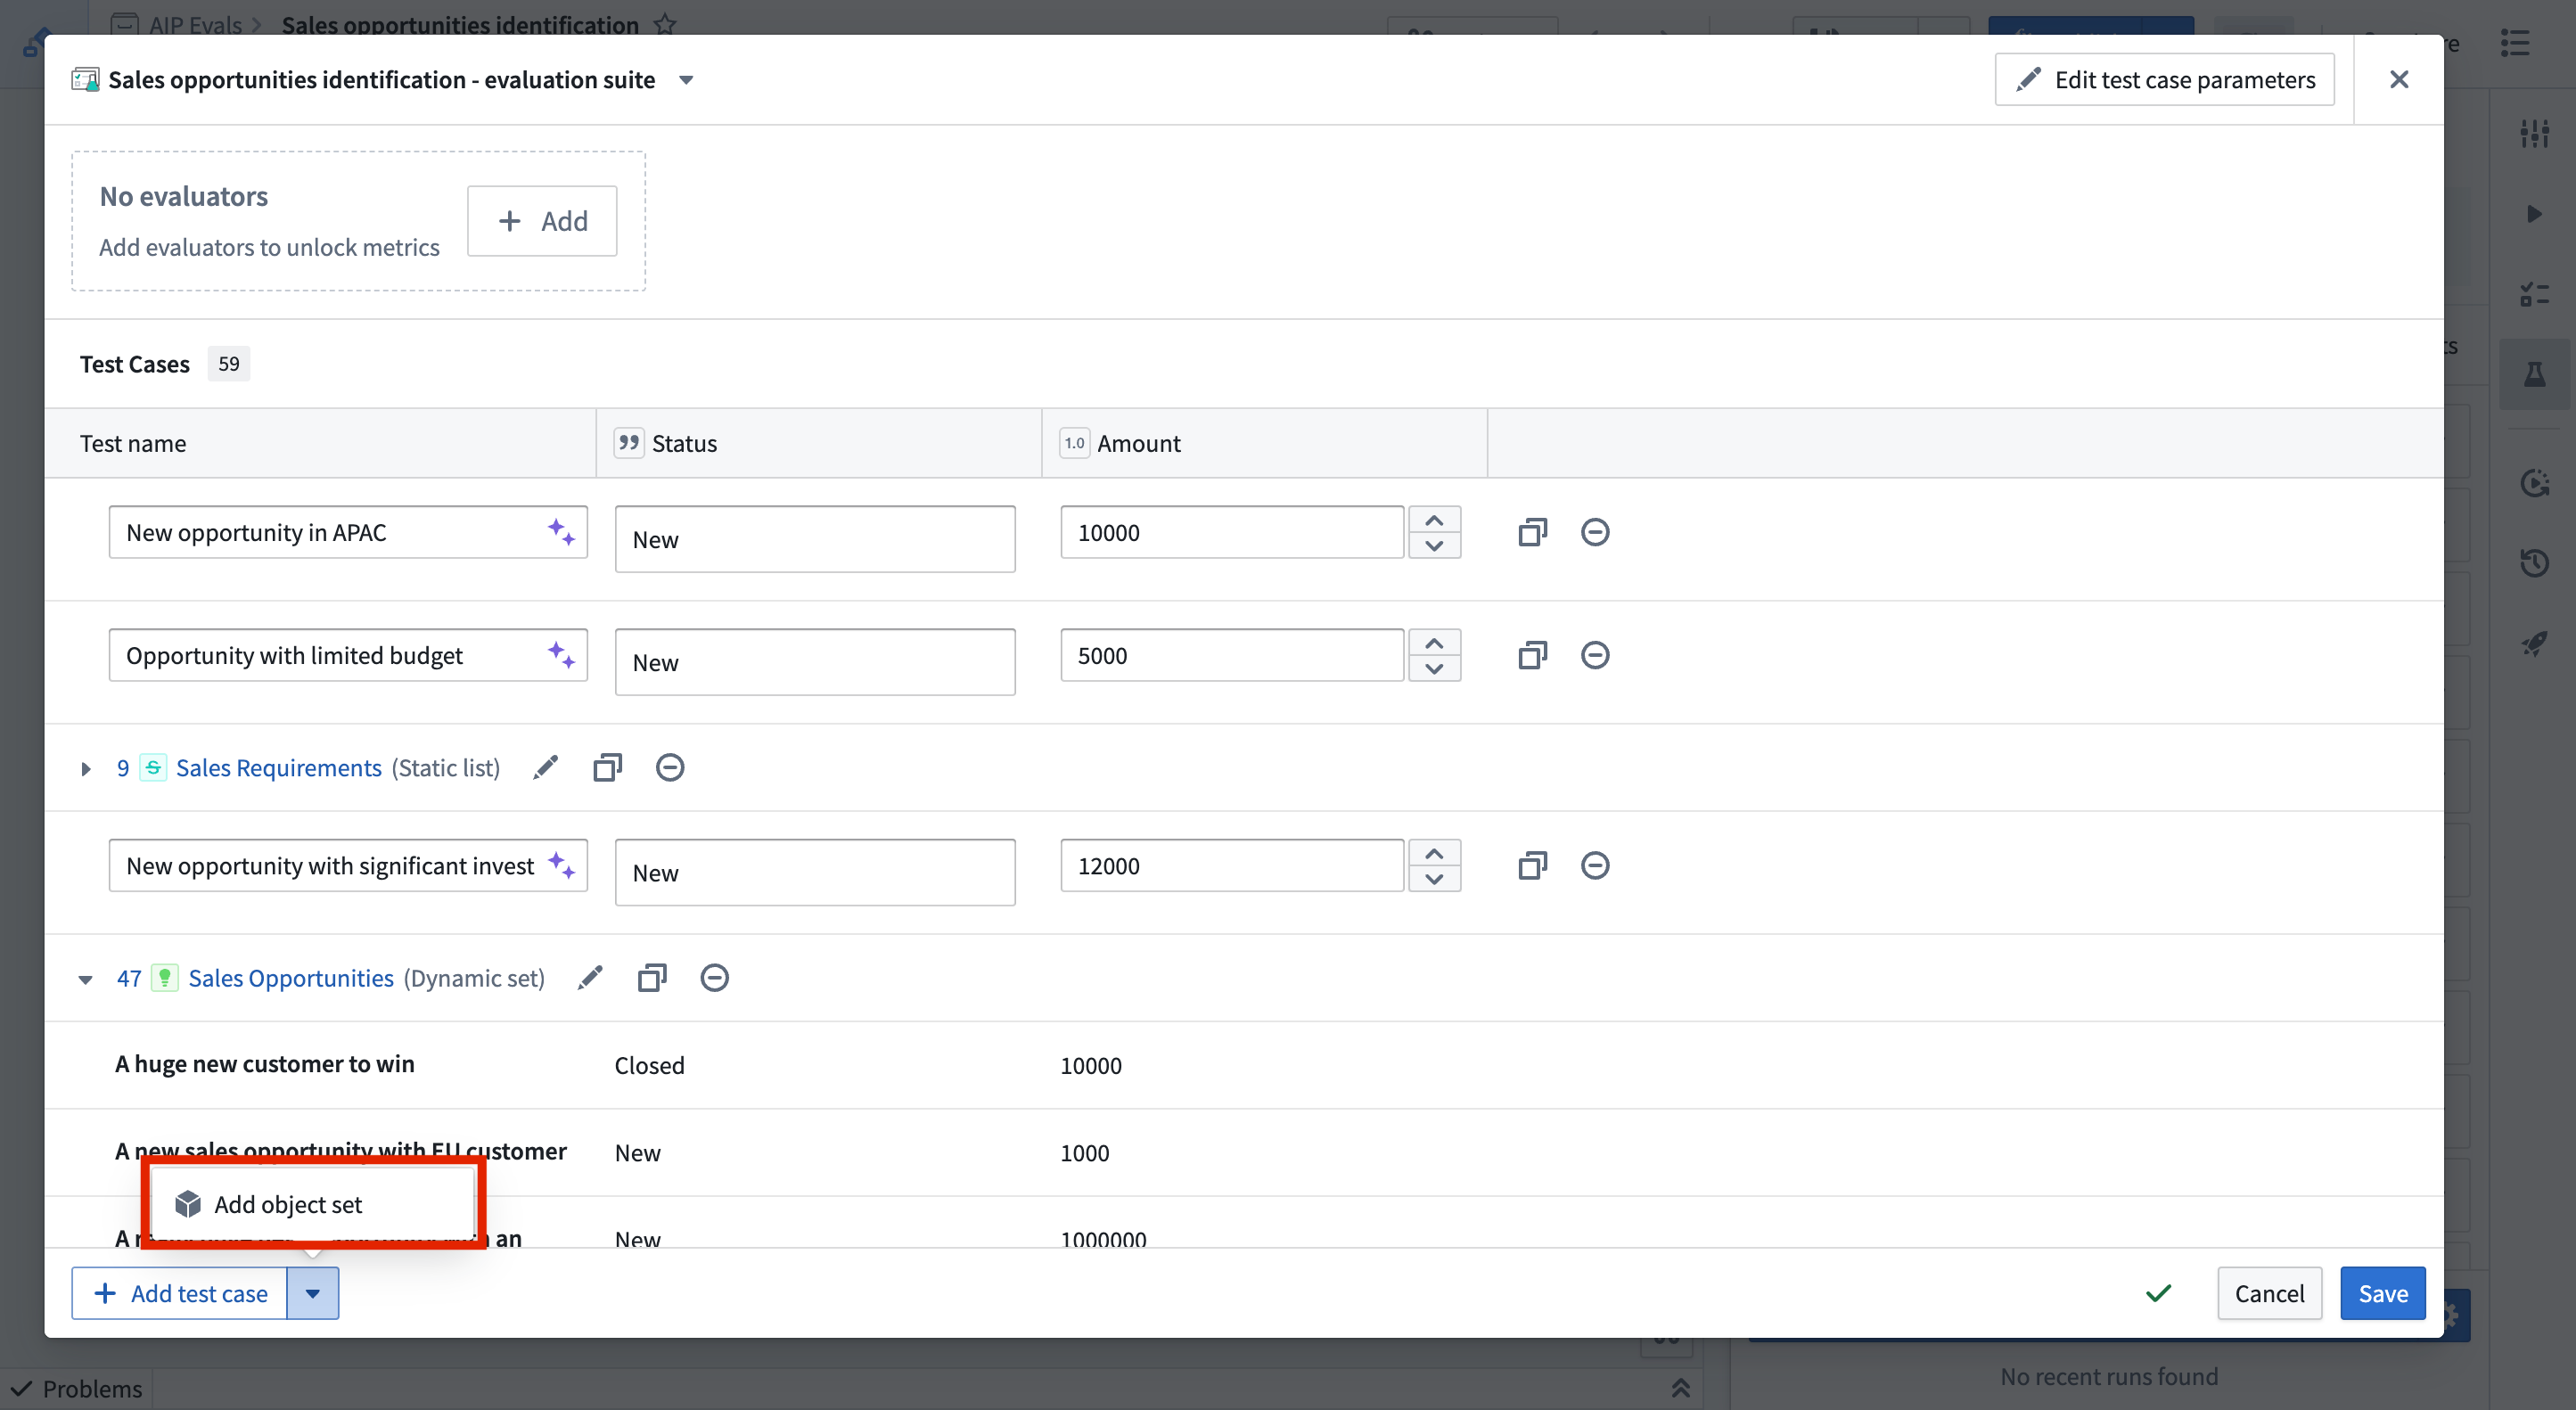
オブジェクトセットのテストケースは、実データを使用して大規模にテストし、実際のデータの代表的なサンプル全体で関数が動作することを確認する場合に特に役立ちます。同じ評価スイートに複数のオブジェクトセットを追加し、手動のテストケースと組み合わせることで、包括的なテストカバレッジを確保できます。
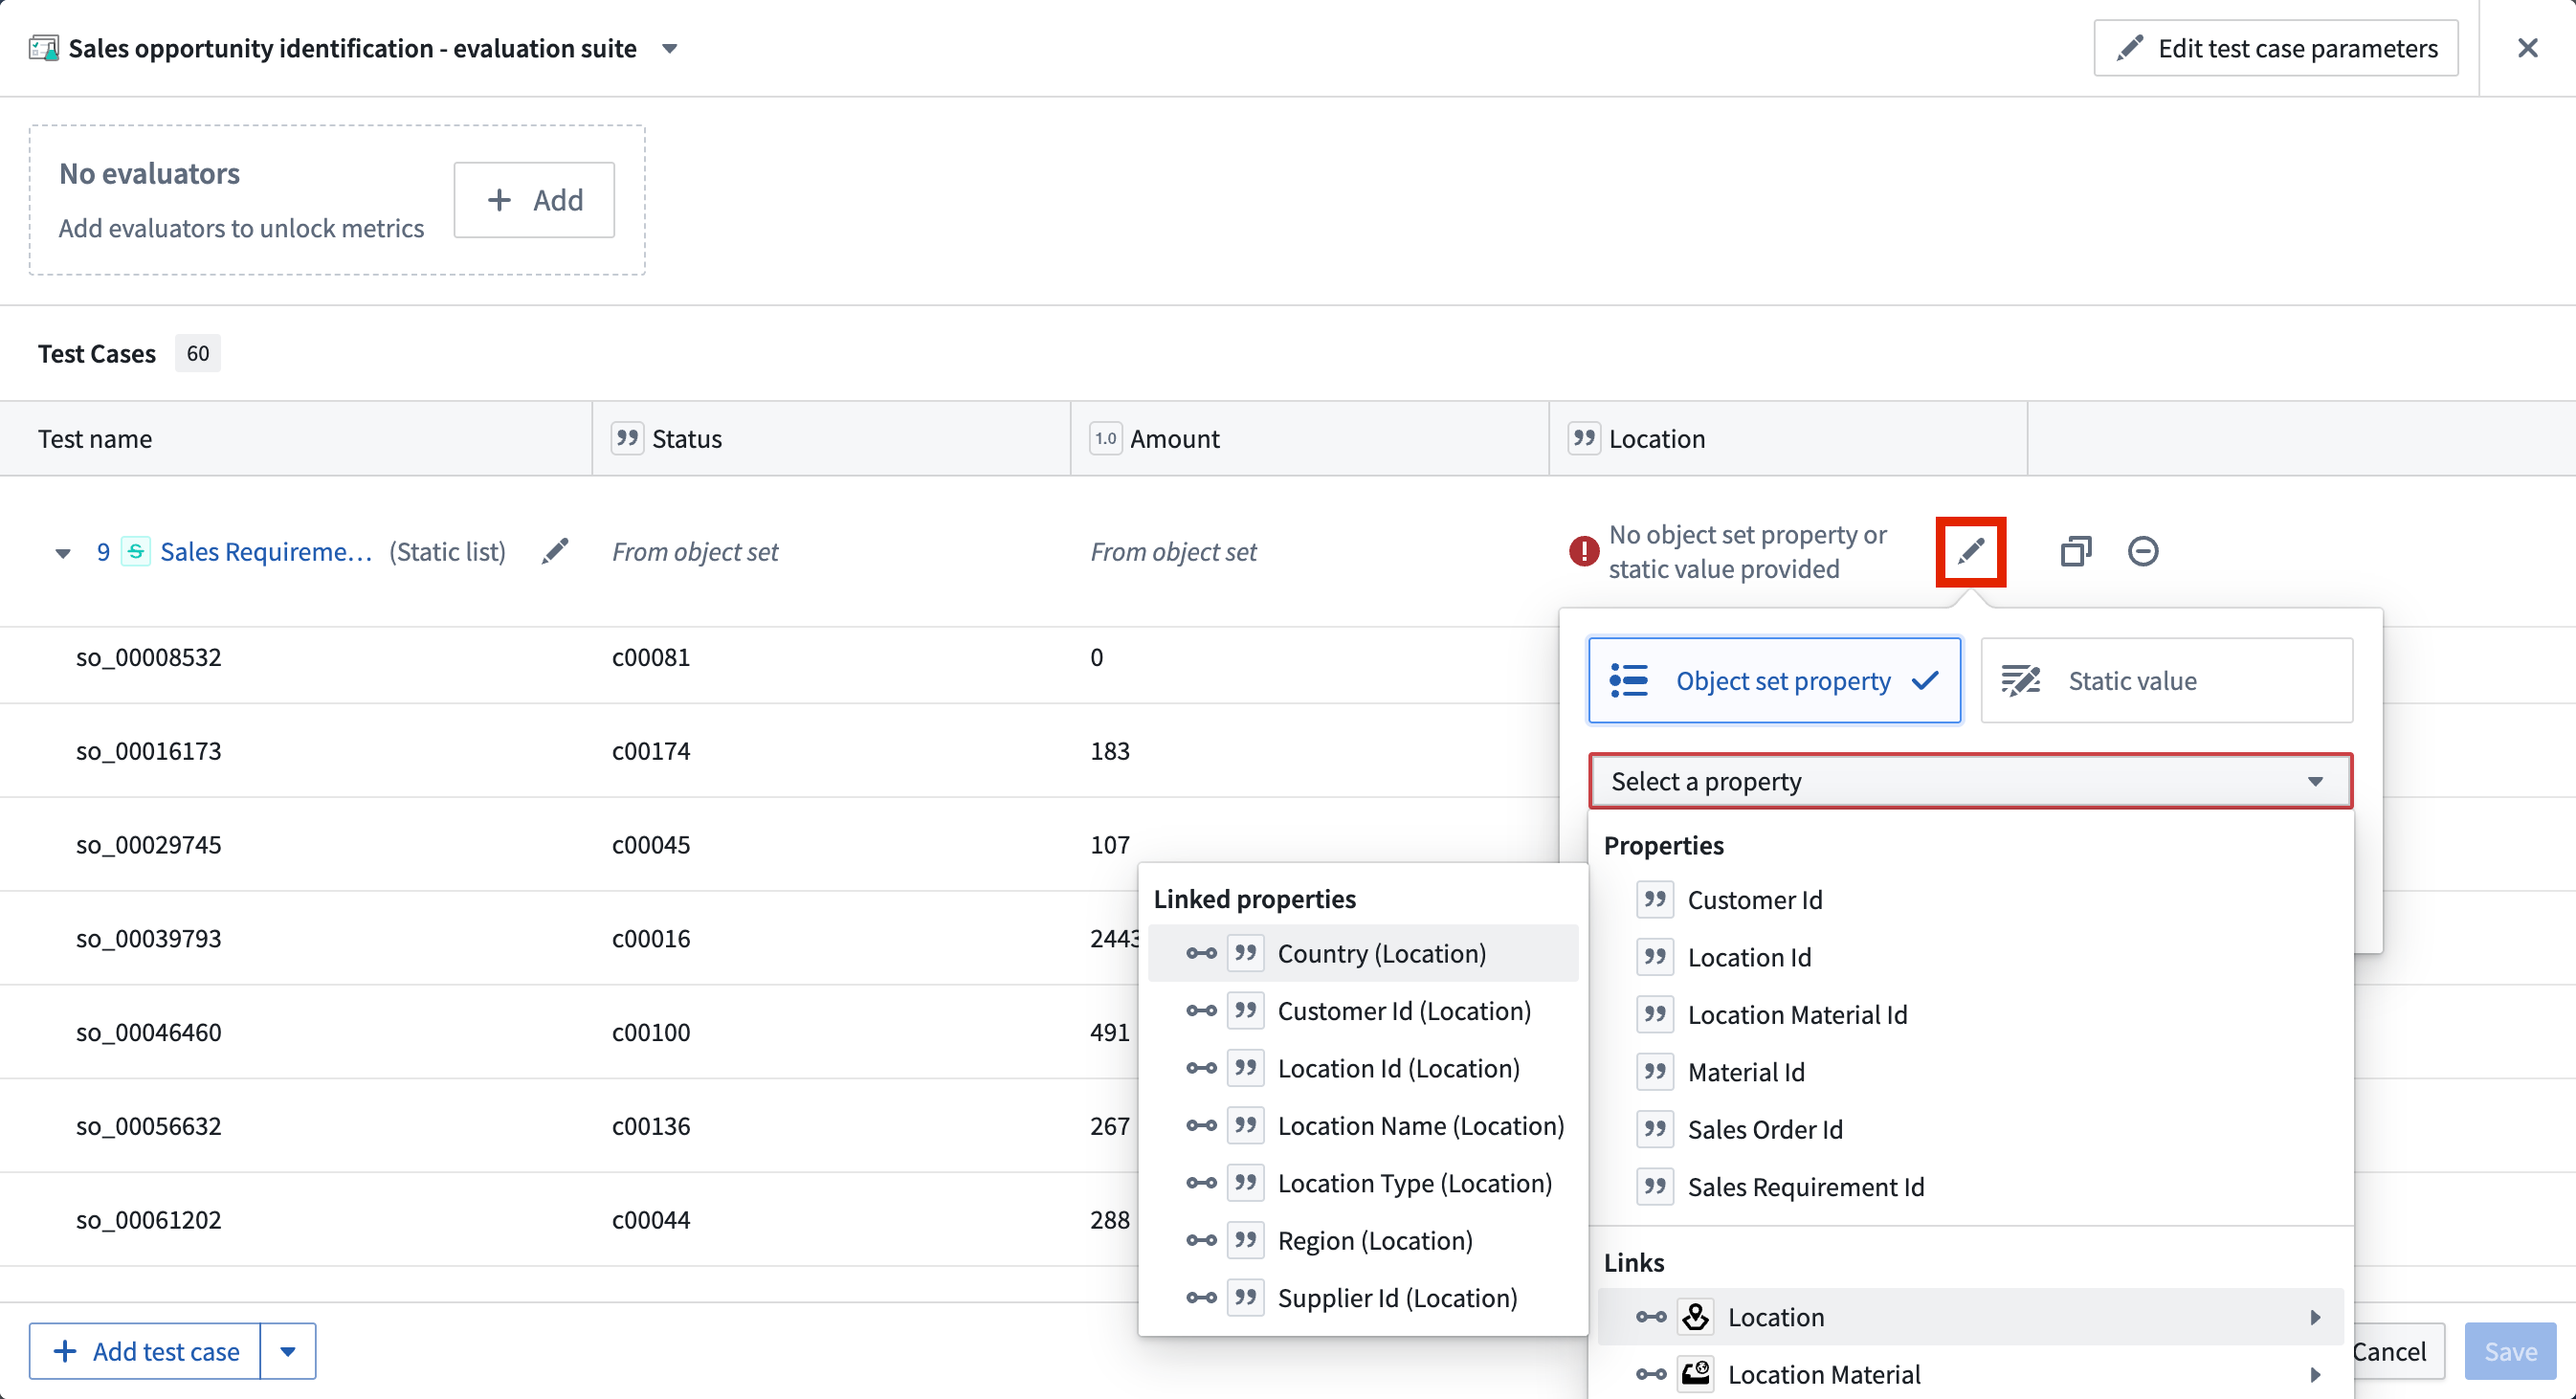
元のオブジェクトセットは、オブジェクトセット設定を編集アイコンを選択すると、設定ダイアログで編集できます。オブジェクトセットのヘッダー列を使用して、プロパティを個別に編集することもできます。
オブジェクトセットは、評価スイートの列にさまざまな種類のデータを渡すように設定できます。これには、次のものが含まれます。
- 元のオブジェクトセットのオブジェクト
- 元のオブジェクトセットのオブジェクトプロパティ
- 元のオブジェクトセットにリンクされたオブジェクトまたはオブジェクトセット
- リンクされたオブジェクトまたはリンクされたオブジェクトセットのプロパティ(Object Storage V2 でのみ利用可能)
- 元のオブジェクトセットのすべての行に適用される固定値
評価ツール
評価ツールは、テスト対象の関数の出力を期待される出力と照合して評価するための手法です。評価ツールは単純な true/false の結果を返すことも、意味的距離などの数値を生成することもできます。評価ツールのない評価スイートは、複数のシナリオで関数を実行し、各出力を手動で確認する場合に便利です。ただし、評価ツールは比較可能なパフォーマンス指標を生成するため、大規模な実行結果の測定と客観化が可能になります。
AIP Evals には、次のセクションで説明する組み込み評価ツールが用意されています。特定の基準に基づいてパフォーマンスを測定するためのカスタム評価関数を定義することもできます。
評価ツールを追加する
評価ツールを追加するには、テストケーステーブルの上部にある + 追加を選択します。選択パネルが開き、組み込み評価ツールまたはカスタム評価ツールの一覧から選択できます。
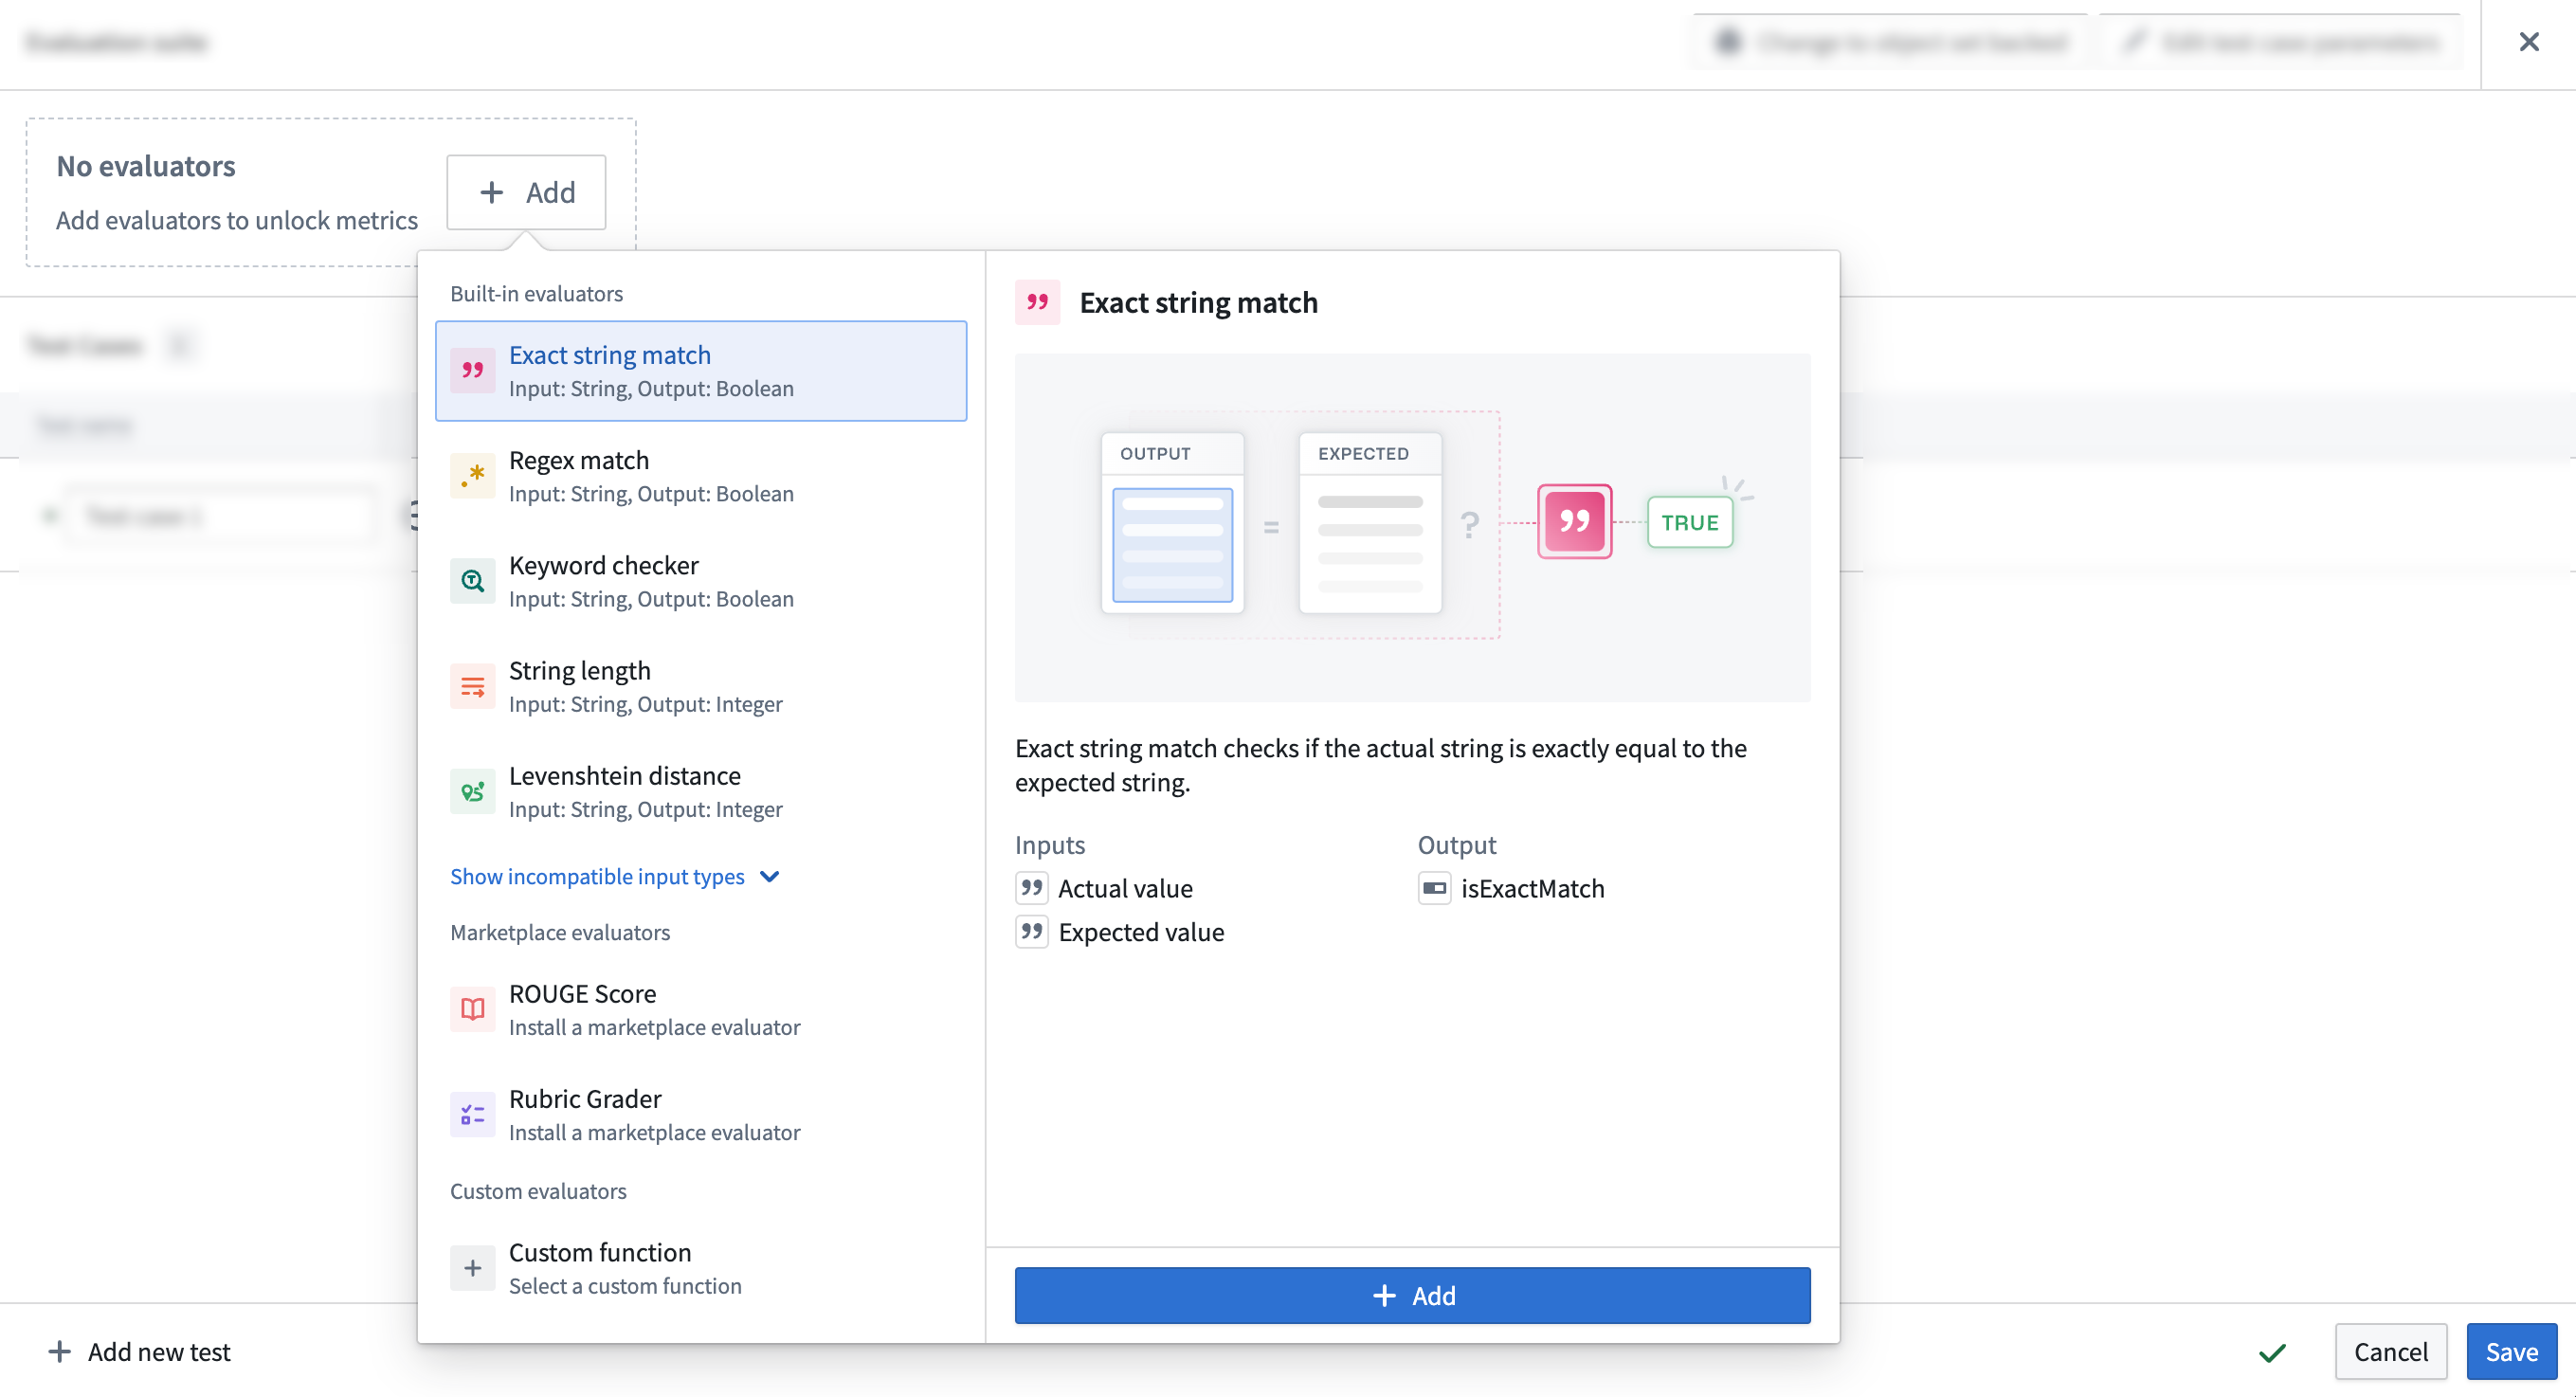
評価ツールを選び、+ 追加を選択すると、テストケーステーブルに評価ツールが追加されます。その後、テストケーステーブルで関数の出力を実際の値列に、期待値を期待値列にマッピングして、評価ツールを設定できます。
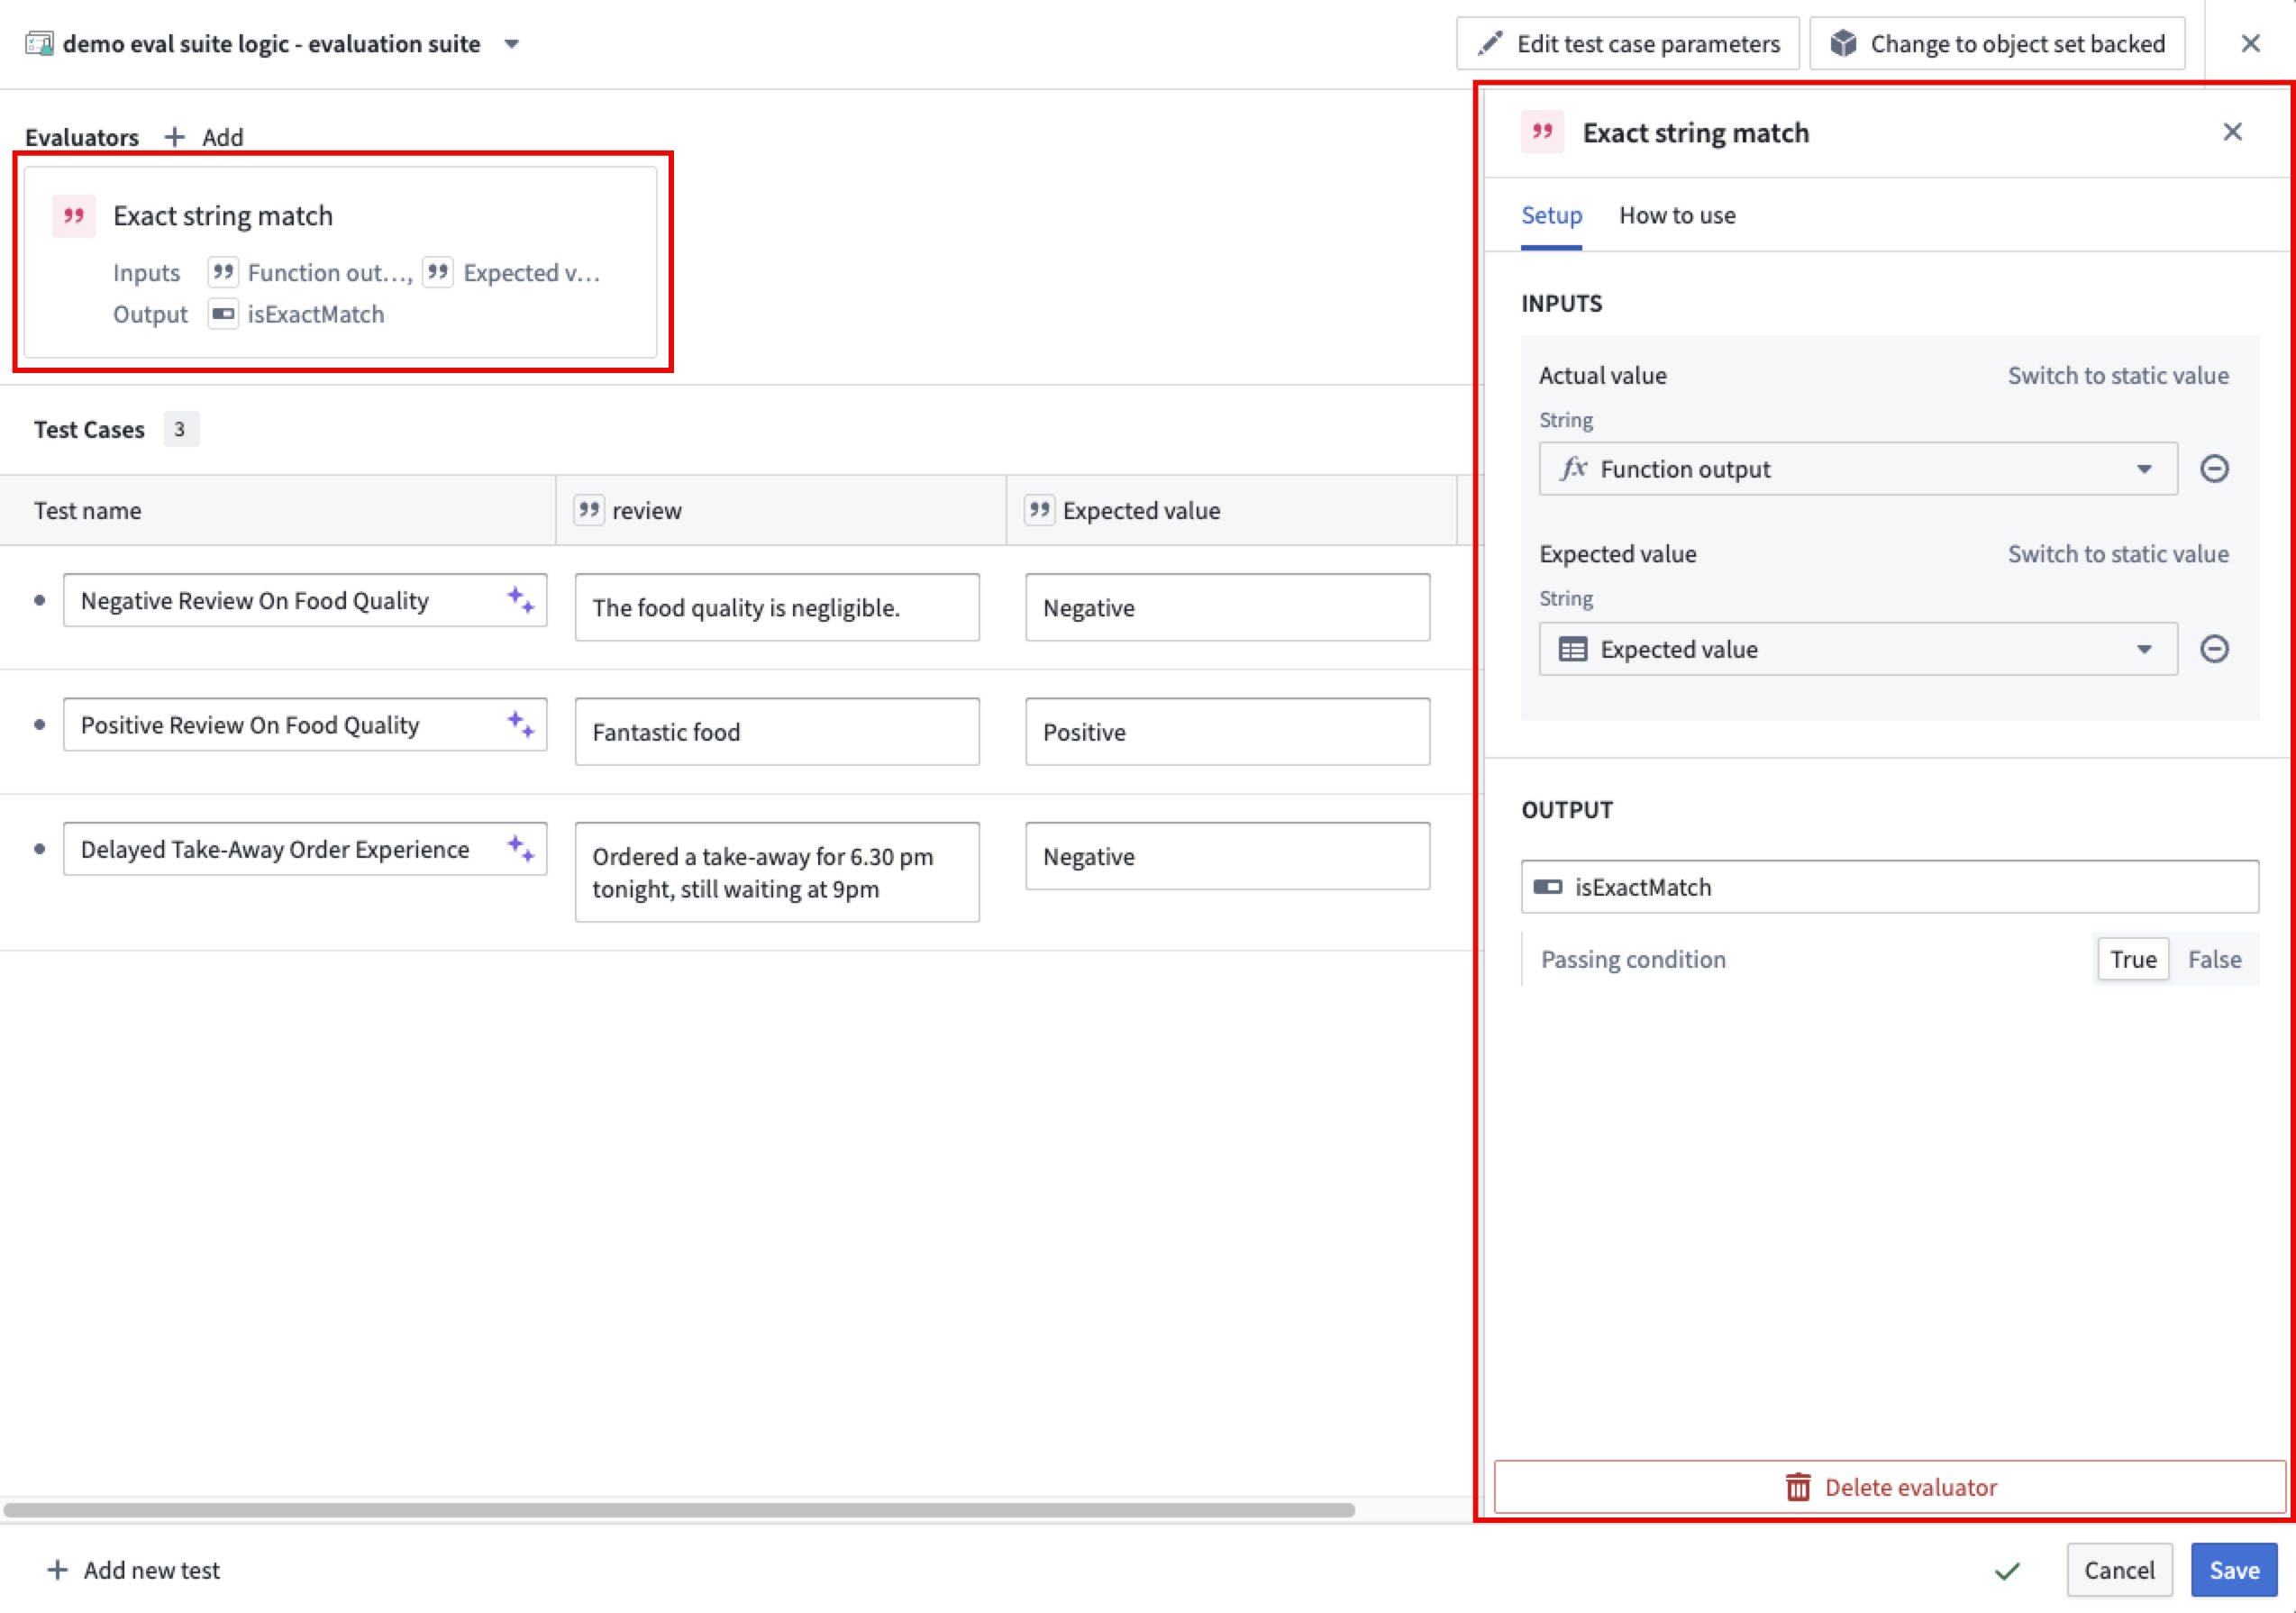
評価ツールを設定するときは、メトリクスごとに目標を定義できます。ブールメトリクスの場合は、合格条件を真または偽に設定します。数値メトリクスの場合は、ゴールを増加(値が大きいほど良い)または減少(値が小さいほど良い)に設定します。また、境界値を含む合格しきい値を定義することもできます。
- 増加のゴールの場合は、最小合格しきい値を設定します(たとえば、「スコアが10以上であること」)。
- 減少のゴールの場合は、最大合格しきい値を設定します(たとえば、「スコアが0.05以下であること」)。
ブールメトリクスは、合格条件と一致すると合格します。数値メトリクスは、しきい値を満たすと合格します。しきい値のない数値メトリクスは、テストケースの合否に影響しません。いずれかの反復でいずれかのメトリクスが不合格になると、テストケースは不合格になります。1つ以上のメトリクスが合格し、不合格のメトリクスがなければ、テストケースは合格になります。合格または不合格になるメトリクスがない場合、テストケースは正常に実行されましたとしてマークされます。

組み込み評価ツール
組み込み評価関数には、次のようなものがあります。
- ブール値の完全一致: 実際のブール値が期待されるブール値と完全に等しいかどうかを確認します。
- ブール配列の完全一致: 2つのブール配列に同じ要素が含まれているかどうかを確認します。デフォルトでは比較時に順序が考慮されますが、これは設定で変更できます。
- 文字列の完全一致: 実際の文字列が期待される文字列と完全に一致するかどうかを確認します。デフォルトでは大文字と小文字を区別し、空白も含めて照合しますが、これは設定で変更できます。
- 文字列配列の完全一致: 2つの文字列配列に同じ要素が含まれているかどうかを確認します。デフォルトでは比較時に順序を考慮し、大文字と小文字を区別し、空白も含めますが、これは設定で変更できます。
- 正規表現の一致: 実際の文字列が期待される正規表現と一致するかどうかを確認します。正規表現は文字列全体と一致する必要があります。
- レーベンシュタイン距離: 2つの系列間の差異を測定する文字列の指標です。一方の単語をもう一方に変換するために必要な1文字単位の編集(挿入、削除、置換)の最小回数を計算します。
- 文字列長: 実際の文字列の文字数を整数として返します。長さが制限内に収まることを確認するには、メトリクスに合格しきい値を設定します。
- キーワードチェッカー: 指定したすべてのキーワードが実際のテキストに含まれているかどうかを確認します。照合時に大文字と小文字を区別するかどうかを選択できます。
- オブジェクトの完全一致: 実際のオブジェクトが期待されるオブジェクトと完全に等しいかどうかを確認します。
- オブジェクトセットに含まれる: 実際のオブジェクトが対象のオブジェクトセット内のいずれかのオブジェクトと完全に等しいかどうかを確認します。
- オブジェクトセットのサイズ範囲: 指定したオブジェクトセットのサイズが期待される範囲内にあるかどうかを確認します。
- 整数範囲: 実際の値が期待値の範囲内にあるかどうかを確認します。整数のみがサポートされます。
- 数値の完全一致: 2つの数値が完全に等しいかどうかを確認します。Integer、Long、Float、Double、Short のデータ型をサポートします。必要に応じて許容偏差を設定できます。
- 数値配列の完全一致: 2つの数値配列に同じ要素が含まれているかどうかを確認します。Integer、Long、Float、Double、Short のデータ型をサポートします。デフォルトでは比較時に順序が考慮されますが、これは設定で変更できます。
- 浮動小数点数範囲: 実際の値が期待値の範囲内にあるかどうかを確認します。パラメーターとしてすべての数値データ型がサポートされます。
- 日時範囲: 実際の値が期待値の範囲内にあるかどうかを確認します。
DateとTimestampの値のみがサポートされます。 - 日時の完全一致: 実際の
DateまたはTimestampの値が期待値と完全に等しいかどうかを確認します。必要に応じて許容偏差をミリ秒単位で設定できます。 - 汎用完全一致: 実際の値が期待値と同一かどうかを確認します。数値データ型は比較のために型変換されます(たとえば、Integer は同じ値の Double と一致する場合があります)。日付型とタイムスタンプ型も同様です。オブジェクトとオブジェクトセットは参照によって、構造体とマップは順序を問わないキーと値のペアによって、リストは順序付きの要素によって、モデルは識別子とパラメーターによって比較されます。使用するデータ型に固有の評価ツールがある場合は、比較オプションをきめ細かく設定でき、型安全性も高いため、その評価ツールを使用してください。
- LLM-as-a-judge: LLM を使用して、指定された値に対してユーザー定義の条件が成り立つかどうかを評価します。条件を満たす場合は
true、それ以外の場合はfalseを返します。実際の値として、参照型(オブジェクトロケーター、オブジェクト RID、オブジェクトセット、モデル)以外の任意のデータ型を受け付けます。明確で検証可能な表明として記述された条件パラメーターと、評価用のモデルが必要です。推論を表示をオフにしない限り、モデルの推論がデバッグ出力として返されます。 - ROUGE スコア: 実際の(生成された)テキストの表現が期待される(対象の)テキストとどの程度重複しているかを測定します。要約や翻訳などのタスクに特に役立ちます。
precision、recall、f-measureをそれぞれ0~1のスケールで返し、スコアが高いほど対象との一致度が高いことを示します。ROUGE の種類(rouge1、rouge2、rouge3、rougeL、rougeLsum)を選択します。また、ステマーを使用をオンにすると接尾辞が異なる単語を照合でき、要約を分割をオンにするとrougeLsumで改行の代わりに句読点で文を分割できます。
カスタム評価関数
カスタム評価関数では、以前に公開された関数を選択できます。Code Repositories で記述された Functions on Objects や、ほかの AIP Logic 関数を使用できます。カスタム評価関数は、メトリクスとしてブール型または数値データ型の値を1つ以上返す必要があります。また、1つの評価関数から、ブール型または数値データ型で構成される struct を返すことで、複数のメトリクスを返すこともできます。struct には文字列フィールドを含めることもでき、診断用のデバッグ出力としてデバッグ表示に表示されます。
評価スイートを作成した後の評価スイートの実行設定について、詳しくはこちらをご覧ください。