注: 以下の翻訳の正確性は検証されていません。AIPを利用して英語版の原文から機械的に翻訳されたものです。
Compute Module を元にしたモデル
Compute Module を元にしたモデルでは、Compute Module 内で大規模言語モデルサーバーをホストし、AIP のファーストクラスモデルとして登録できます。登録したモデルは、Palantir が提供するモデルや REST API を通じて登録したモデルと同様に、すべての対応アプリケーションのモデルセレクターに表示されます。
この方法は、主に次の2つのシナリオに適しています。
- 独自のコンピューティング環境でモデルをセルフホストする: Compute Module を元にしたモデルを使用すると、データ主権の確保、オンプレミスまたはエアギャップ環境へのデプロイ、コスト管理、新しくリリースされたモデルへの早期アクセスを目的として、独自の GPU 上でオープンソースモデルやカスタムモデルを実行できます。
- カスタムプロキシまたはフェデレーションレイヤーを構築する: Compute Module を元にしたモデルを使用すると、API 形式の再マッピング、プロンプトの挿入、外部プロバイダーに送信する前のデータの墨消し、または単一の登録済みモデルを介した複数のプロバイダーへのリクエストの振り分けを行えます。
前提条件
Compute Module アプリケーションをモデルソースとして登録する前に、次の要件を満たす必要があります。
-
対応するプロバイダー API 形式でサービスを提供する: コンテナは、対応するプロバイダー API 形式のいずれかに準拠した API を公開する必要があります。vLLM や Ollama などの推論サーバーは、デフォルトで対応する API を公開します。
-
アプリケーションポートを設定する: モデルサーバーがリッスンするポートを指定する
application.portラベルを Dockerfile に追加する必要があります。たとえば、LABEL application.port='8000'です。コンテナに関する一般的なガイダンスについては、Compute Module のコンテナに関するドキュメントを参照してください。
-
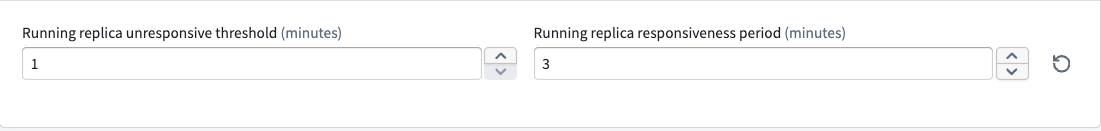
最小レプリカ数を1つ以上に設定する: Compute Module の最小レプリカ数を1つ以上に設定します。詳細については、最小レプリカ数に関するドキュメントを参照してください。
モデルを登録して使用する
モデルを登録するには、エンロールメント管理者である必要があります。
Compute Module が稼働したら、Control Panel でモデルとして登録します。
-
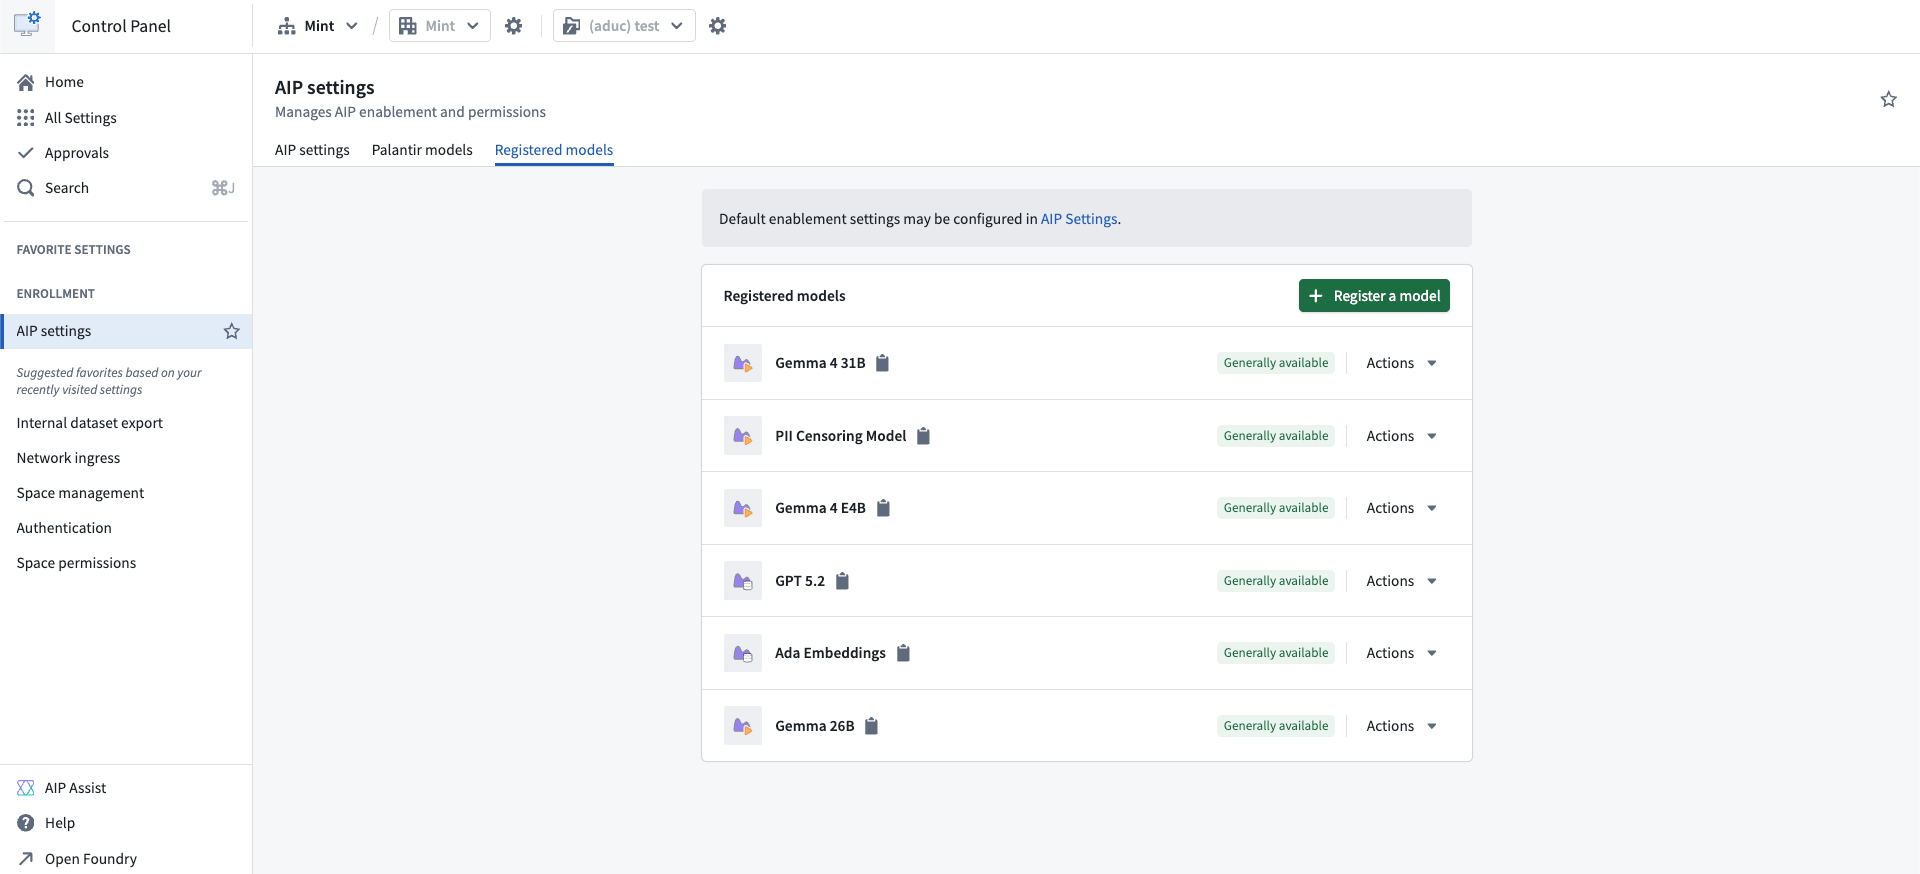
AIP の設定拡張機能に移動し、登録済みモデルタブを選択します。
-
モデルを登録を選択します。
-
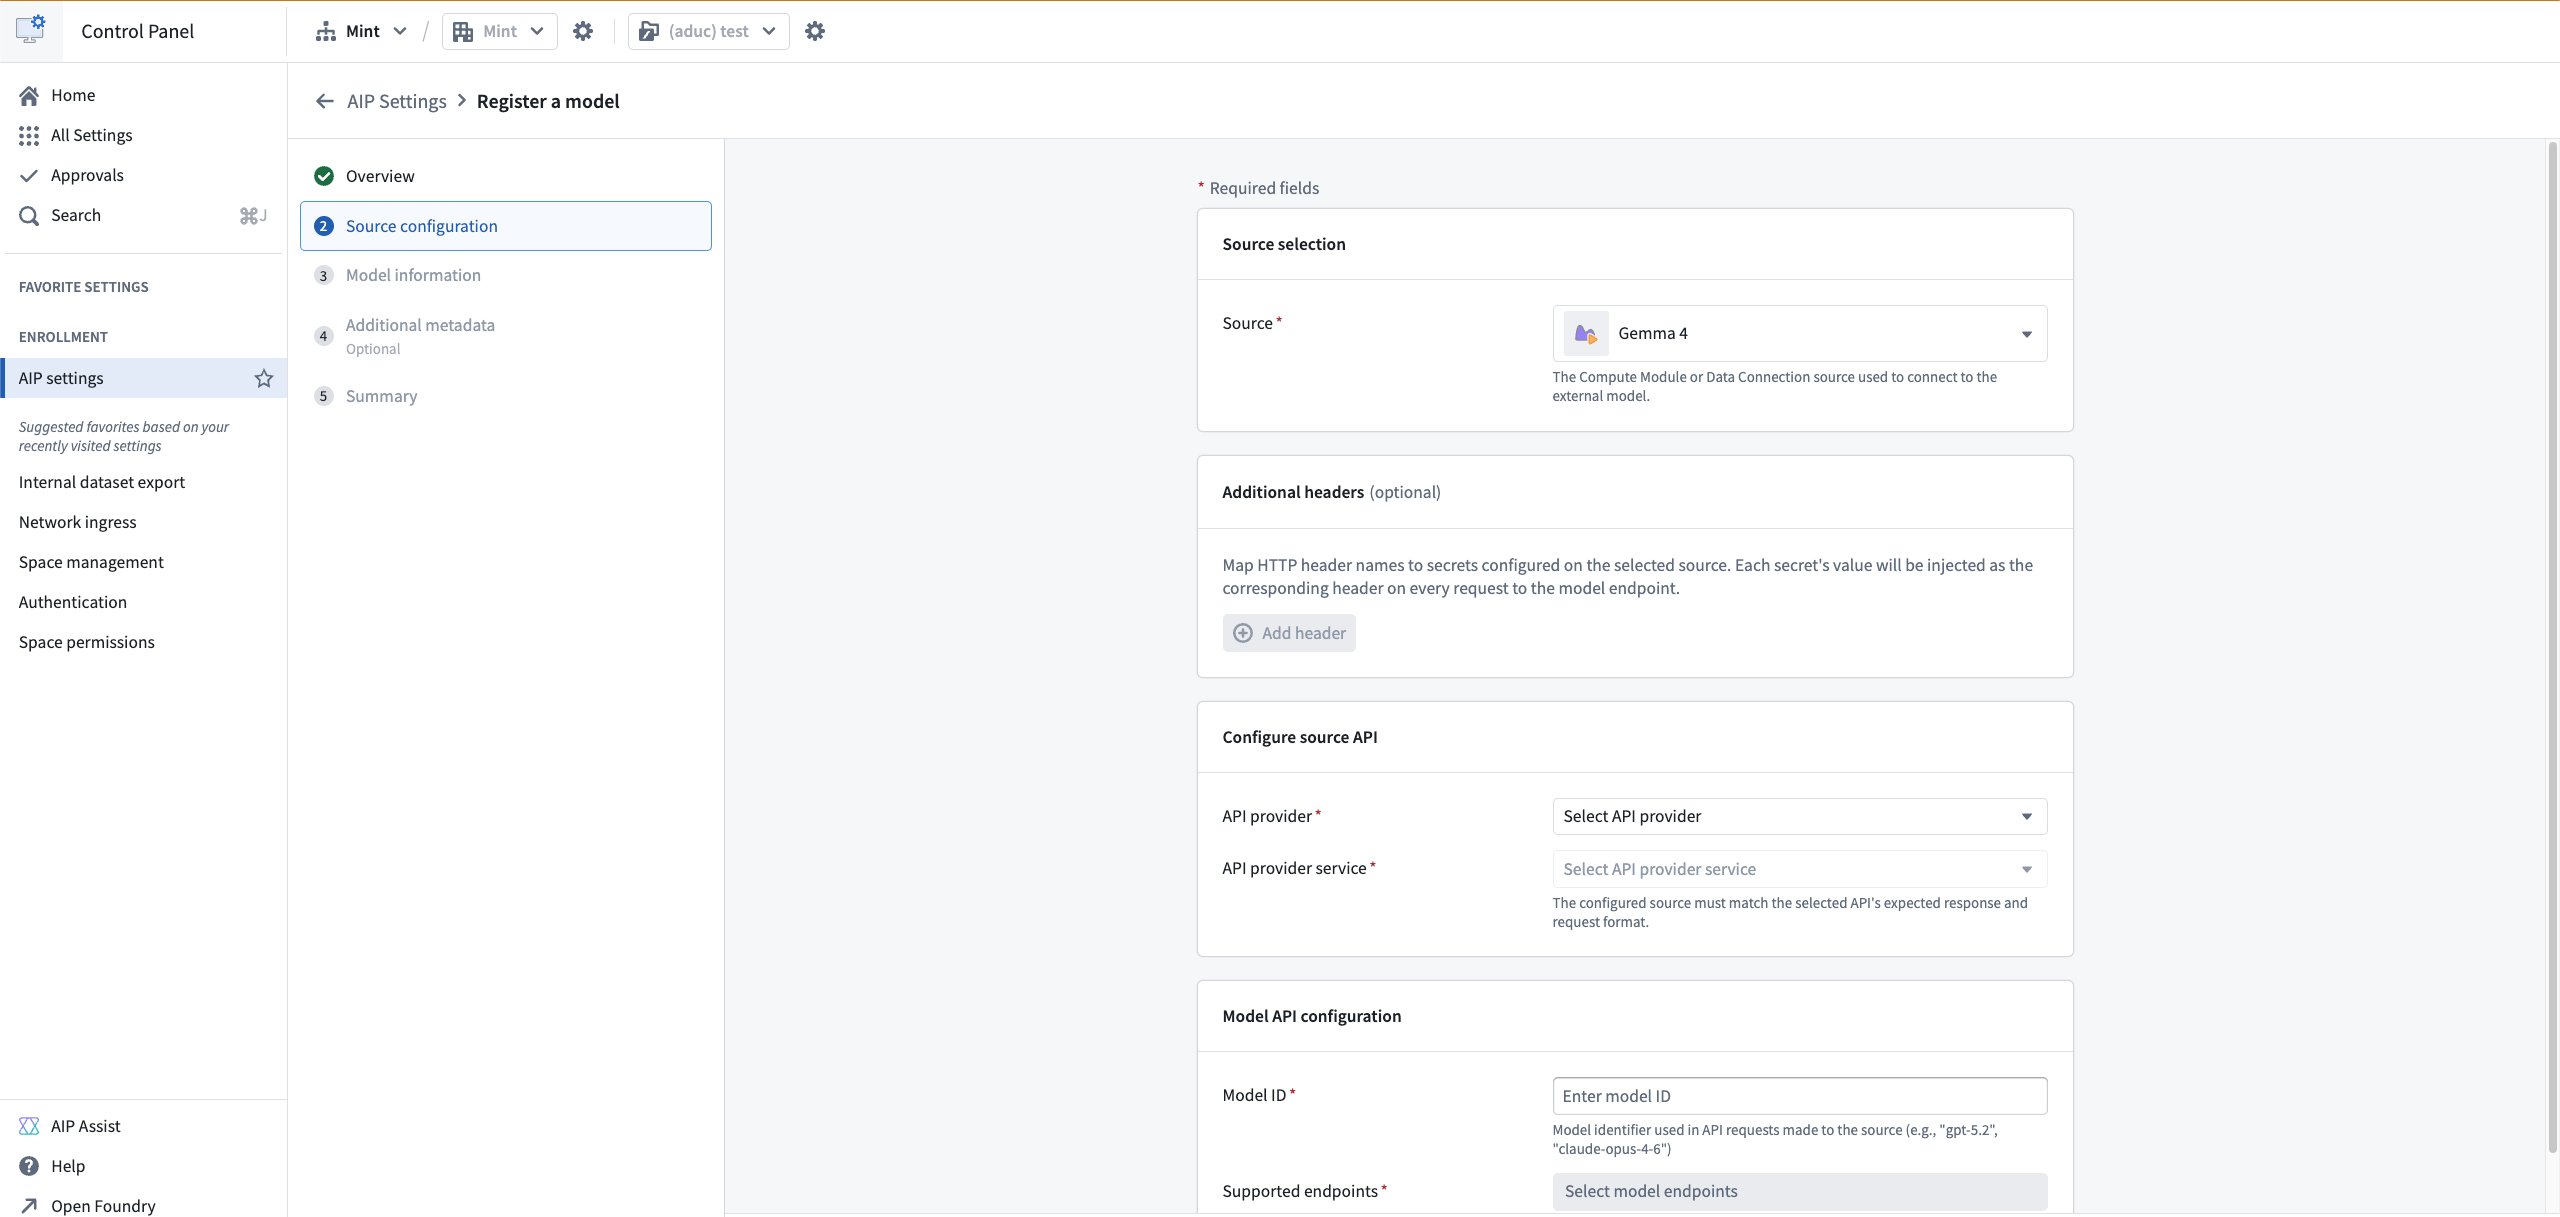
ソースとして Compute Module を選択します。
-
モデルIDを設定します。推論サーバーで使用するモデル名など、モデルサーバーが想定する識別子を設定します。
-
モデルの機能を定義します。推論、構造化出力、ツール呼び出しを有効にすると、AI FDE と AIP Analyst がモデルを使用できるようになります。
-
必要に応じて、モデルのデータアクセスポリシーを設定します。このポリシーを設定しない場合は、エンロールメントのポリシーが適用されます。モデル固有のポリシーは、エンロールメントのポリシーを完全に置き換えます。必須マーキングで LLM のデータアクセスを制御する方法を参照してください。
-
モデルのレート制限を定義します。エンロールメントとユーザーのレート制限の詳細については、登録済みモデルでサポートされる機能を参照してください。
-
エンロールメント全体または特定のユーザーグループに対して、登録済みモデルへのアクセスを有効にします。
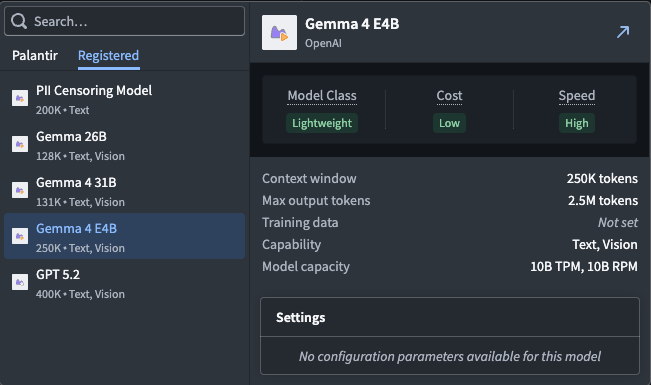
これで、登録したモデルがすべての対応アプリケーションのモデルセレクターに表示されます。
次のステップ
Compute Module を元にしたモデルを登録したら、その Compute Module を使用して AIP でモデルをセルフホストするか、プロキシまたはフェデレーションレイヤーを構築することができます。