注: 以下の翻訳の正確性は検証されていません。AIPを利用して英語版の原文から機械的に翻訳されたものです。
登録済みの LLM を使用する [レガシー]
このページでは、レガシーの関数インターフェース方式で登録した LLM の使用方法を説明します。この方式に代わり、2026年3月からは登録済みモデルの実装が推奨されています。関数インターフェース方式は TypeScript v1 にのみ適用され、TypeScript v2 に相当する方式はないため、このページの TypeScript の例では TypeScript v1 関数 API を使用しています。登録済みモデルを使用する場合、モデルは AIP アプリケーション全体のモデルセレクターで自動的に利用可能になり、追加の手順は不要です。
このページでは、Palantir プラットフォームで登録済みの LLM を使用する方法を詳しく説明します。LLM の登録方法については、関数インターフェースを使用して LLM を登録するを参照してください。
AIP Logic
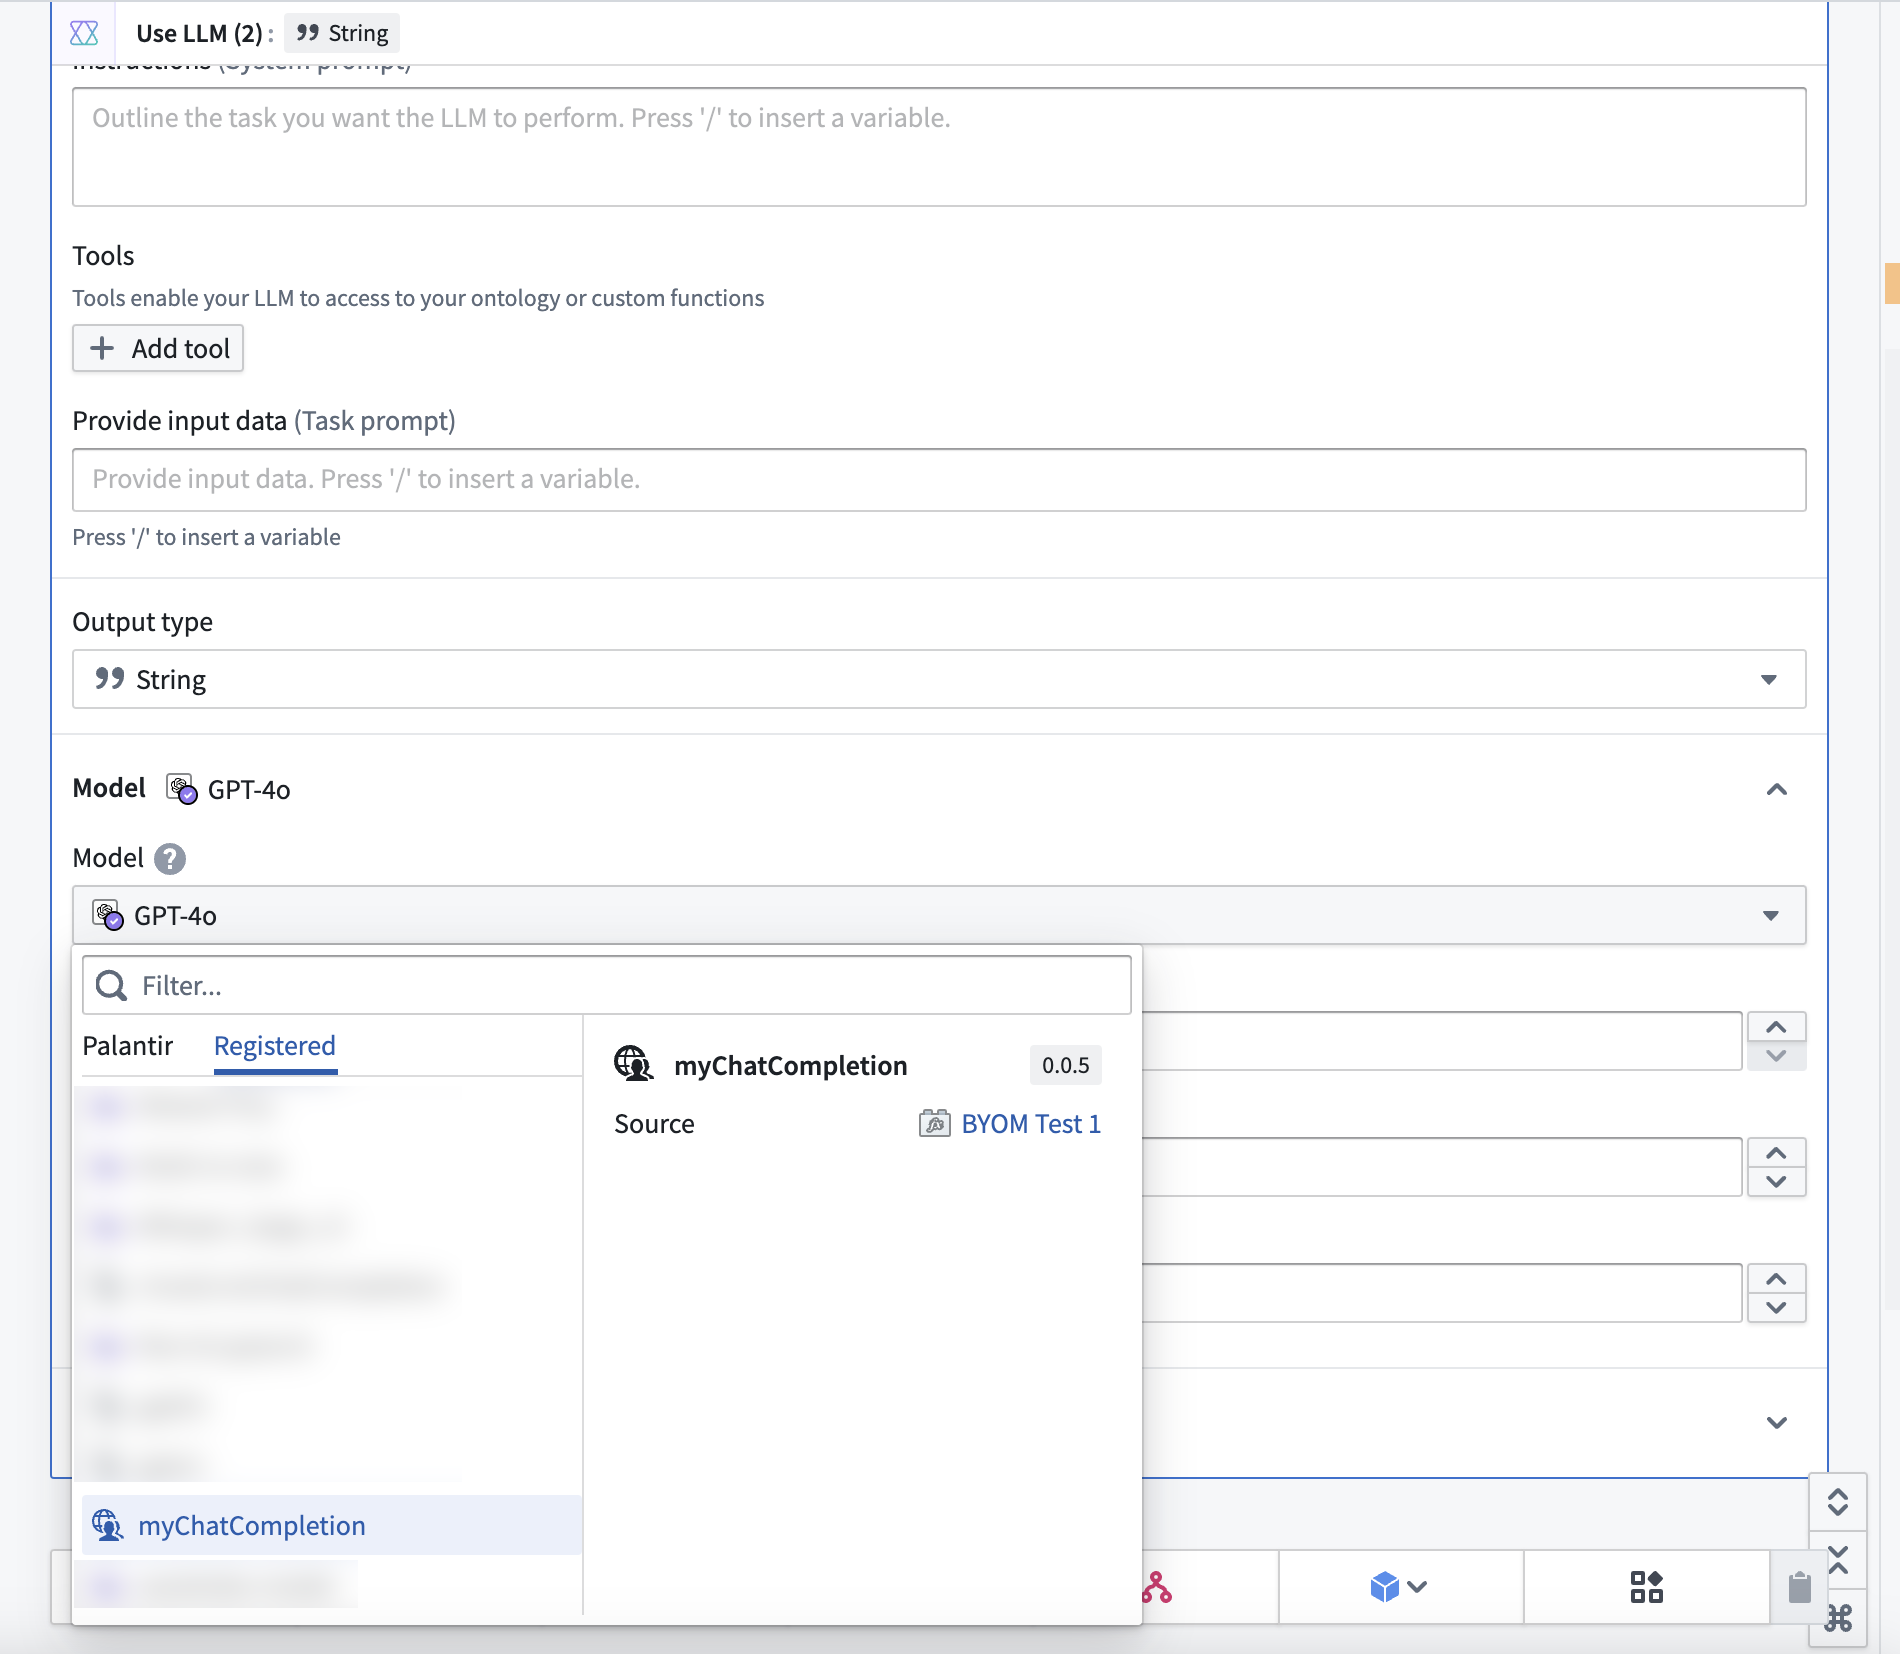
AIP Logic で関数をネイティブに使用できます。使用するには、通常どおり LLM を使用ボードを選択し、モデルのドロップダウンで登録済みタブを選択して、関数を選択します。
Pipeline Builder [ベータ版]
Pipeline Builder の LLM は開発のベータ版段階にあり、お使いのエンロールメントでは利用できない場合があります。開発が進む中で機能が変更される場合があります。
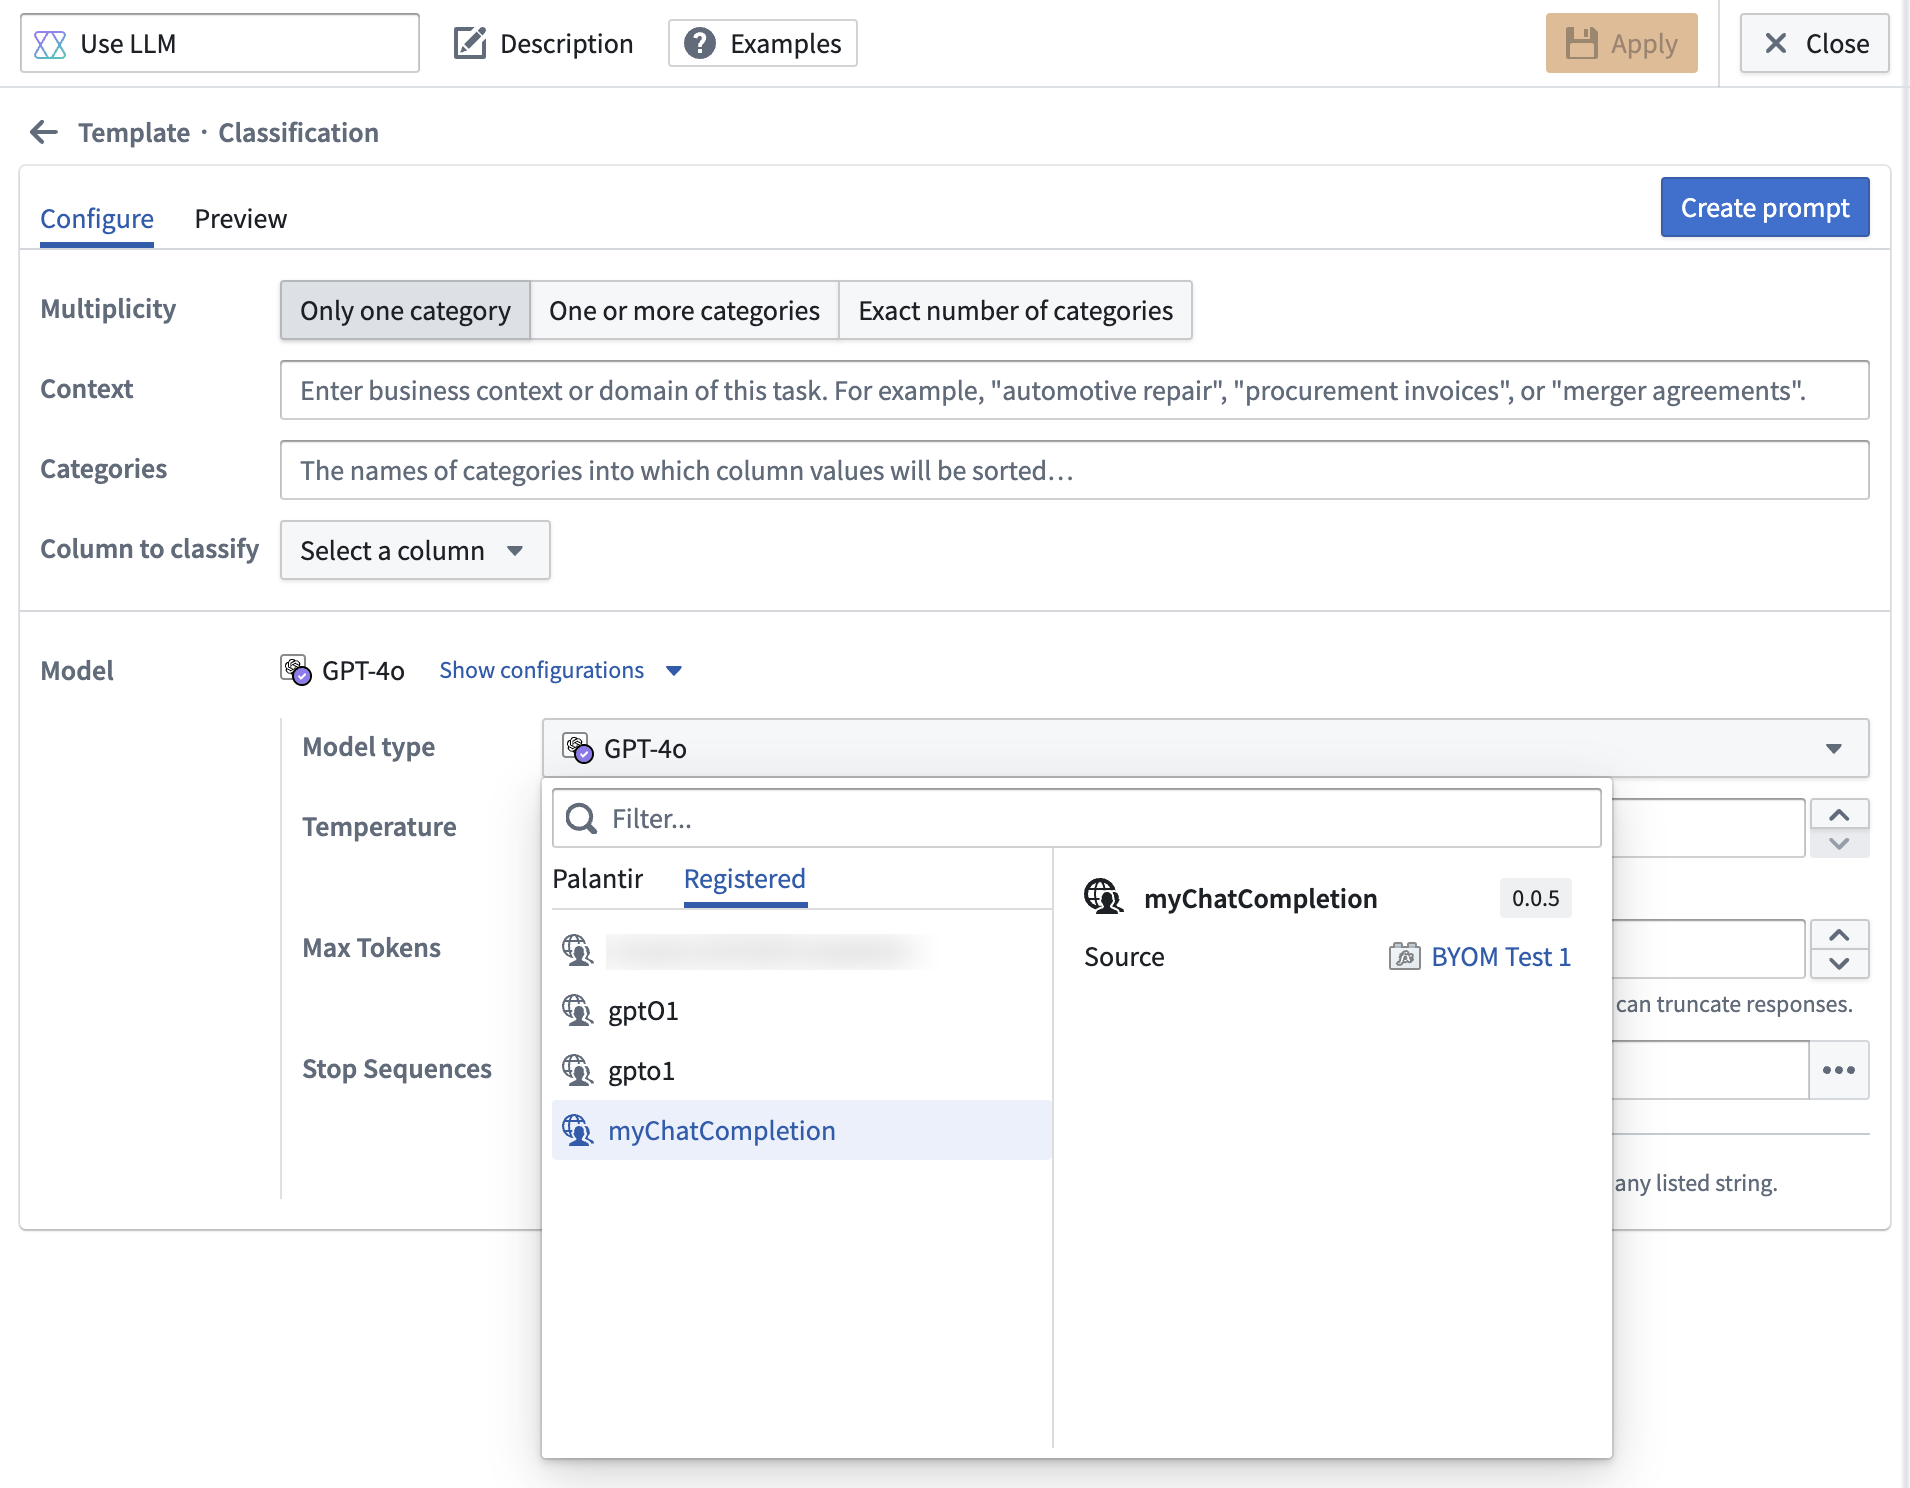
Pipeline Builder の LLM データ加工で関数をネイティブに使用できます。使用するには、通常どおり LLM を使用データ加工を選択し、モデルセクションで設定を表示を展開します。モデルタイプのドロップダウンで登録済みタブを選択し、LLM を選択します(以下の例では myChatCompletion と表示されています)。
Webhook を設定せずに使用する
Pipeline Builder の BYOM ワークフローはまだ Webhook をサポートしていないため、代わりにソースからの直接エグレスを使用して外部システムを呼び出すことができます。ただし、外部システム用の REST ソースが設定されている必要があります。まず関数インターフェースを使用して LLM を登録し、ソースの Webhook を設定するセクションはスキップします。
REST ソースを用意したら、ChatCompletion 関数インターフェースを使用して TypeScript 関数を記述できます。この手順は、TypeScript 関数で LLM を登録するドキュメントの第2部の手順とおおむね同じですが、Webhook を使用しない場合、リポジトリのインポートとコードは少し異なります。
まず、ソースをインポートし、サイドバーで ChatCompletion 関数インターフェースを開きます。

次に、関数シグネチャに @ChatCompletion と @ExternalSystems デコレーターを実装します。
Copied!1 2 3 4 5 6 7 8 9 10 11 12 13 14import { ExternalSystems } from "@foundry/functions-api"; import { MySourceApiName} from "@foundry/external-systems/sources"; import { ChatCompletion } from "@palantir/languagemodelservice/contracts"; import { FunctionsGenericChatCompletionRequestMessages, GenericChatMessage, ChatMessageRole, GenericCompletionParams, FunctionsGenericChatCompletionResponse } from "@palantir/languagemodelservice/api"; @ExternalSystems({sources: [MySourceApiName]}) @ChatCompletion() public async myFunction( messages: FunctionsGenericChatCompletionRequestMessages, params: GenericCompletionParams ): Promise<FunctionsGenericChatCompletionResponse> { // todo: ここに関数のロジックを実装します }
最後に、外部でホストされているモデルを呼び出す関数ロジックを実装します。
Copied!1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41import { ExternalSystems } from "@foundry/functions-api"; import { MySourceApiName} from "@foundry/external-systems/sources"; import { ChatCompletion } from "@palantir/languagemodelservice/contracts"; import { FunctionsGenericChatCompletionRequestMessages, GenericChatMessage, ChatMessageRole, GenericCompletionParams, FunctionsGenericChatCompletionResponse } from "@palantir/languagemodelservice/api"; @ExternalSystems({sources: [MySourceApiName]}) @ChatCompletion() public async myFunction( messages: FunctionsGenericChatCompletionRequestMessages, params: GenericCompletionParams ): Promise<FunctionsGenericChatCompletionResponse> { // ソースの URL にアクセスできます const url = MySourceApiName.getHttpsConnection().url; // また、ソースに保存されたシークレットの復号済みの値にもアクセスできます const token = MySourceApiName.getSecret("additionalSecretMySecretApiName"); // 入力メッセージを処理するために、fetch メソッドで外部へのリクエストを行います。 // ここには認証に必要なシークレットも含められます。 const response = await MySourceApiName.fetch( url + '/api/path/to/external/endpoint', { method: 'GET', headers: {"Authorization": "Bearer ${token}"} }); const responseJson = await response.json(); if (isErr(responseJson)) { throw new UserFacingError("Error from external system."); } // 外部システムが返すレスポンスの形式によっては、レスポンスからこの情報を抽出する方法を調整する必要があります。 return { completion: responseJson.value.output.choices[0].message.content ?? "No response from AI.", tokenUsage: { promptTokens: responseJson.value.output.usage.prompt_tokens, maxTokens: responseJson.value.output.usage.total_tokens, completionTokens: responseJson.value.output.usage.completion_tokens, } } }
ここで、関数インターフェースを使用して LLM を登録するドキュメントのテストのセクションに戻り、次の手順を続けることができます。
- ライブプレビューで関数をテストします。
- バージョンにタグを付けてリリースします。
- ビルダーパイプラインを作成します。
- LLM を使用モデルピッカーのユーザー提供モデルタブから、関数ベースのモデルを選択します。
レート制限エラーを伝播する
ChatCompletion 関数にエラータイプを定義すると、レート制限エラーを伝播して、AIP Logic や Pipeline Builder などの下流のアプリケーションで自動的に再試行できるようになります。
これらのエラーを正しく伝播するように関数を設定するには、次の手順が必要です。
- 関数に
ChatCompletionErrorエラータイプを宣言します。 RateLimitExceededエラーを返します。
関数に ChatCompletionError タイプを宣言する
ChatCompletion インターフェースには、ChatCompletionError というエラータイプがすでに定義されており、次のようにインポートして実装に使用できます。
Copied!1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16// index.ts import { FunctionsResult } from "@foundry/functions-api"; import { ChatCompletion, ChatCompletionError } from "@palantir/languagemodelservice/contracts/ChatCompletion"; import { FunctionsGenericChatCompletionRequestMessages, GenericCompletionParams, FunctionsGenericChatCompletionResponse } from "@palantir/languagemodelservice/api"; @ChatCompletion() public myFunction( messages: FunctionsGenericChatCompletionRequestMessages, params: GenericCompletionParams, ): FunctionsResult<FunctionsGenericChatCompletionResponse, ChatCompletionError> { // TODO: 本体を実装します }
RateLimitExceeded エラーを返す
関数に ChatCompletionError エラータイプを宣言すると、以下のコードスニペットのようにレート制限エラーを返すことができます。
Copied!1return FunctionsResult.err("LanguageModel:RateLimitExceeded", { retryAfterMillis: 20000 });
retryAfterMillis フィールドでは、呼び出し元が関数を再試行するまでに待機すべき時間(ミリ秒)を指定できます。
AIP Logic と Pipeline Builder はどちらも、ジッターを伴う指数バックオフの再試行戦略を実装しています。つまり、関数を再試行する前に、指数関数的に増加する時間にランダムな追加時間を加えた時間だけ待機します。この戦略は、クライアントが繰り返しレート制限に達するのを防ぐとともに、リクエストの急増を避けるのに役立ちます。
このチュートリアルで説明している OpenAI の例では、設定済みの REST ソースにリモートリクエストを送信し、ステータスコードが 429 のエラーレスポンスを捕捉して伝播できます。OpenAI のエラーコードに関するドキュメント ↗に記載されているとおり、ステータスコード 429 はレート制限エラーレスポンスを示します。以下に実装例を示します。
Copied!1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78import { ExternalSystems, FunctionsResult } from "@foundry/functions-api"; import { OpenAI } from "@foundry/external-systems/sources"; import { ChatCompletion, ChatCompletionError } from "@palantir/languagemodelservice/contracts/ChatCompletion"; import { ChatMessageRole, FunctionsGenericChatCompletionRequestMessages, FunctionsGenericChatCompletionResponse, GenericChatMessage, GenericCompletionParams, } from "@palantir/languagemodelservice/api"; export class MyFunctions { @ChatCompletion() @ExternalSystems({ sources: [OpenAI] }) public async myFunction( messages: FunctionsGenericChatCompletionRequestMessages, params: GenericCompletionParams, ): Promise<FunctionsResult<FunctionsGenericChatCompletionResponse, ChatCompletionError>> { // OpenAI に fetch 呼び出しを行います const apiKey = OpenAI.getSecret("additionalSecretAPIKey"); const baseUrl = OpenAI.getHttpsConnection().url; const response = await fetch(`${baseUrl}/v1/chat/completions`, { method: "POST", headers: new Headers({ "Authorization": `Bearer ${apiKey}`, "Content-Type": "application/json", }), body: JSON.stringify({ model: "gpt-4o", messages: convertMessages(messages), }), }); // OK レスポンスを処理します if (response.ok) { const result = await response.json(); return FunctionsResult.ok({ completion: result.choices[0].message.content ?? "No response from OpenAI.", tokenUsage: { promptTokens: result.usage.prompt_tokens, completionTokens: result.usage.completion_tokens, maxTokens: result.usage.total_tokens, }, }); } // 429 レート制限レスポンスを処理します if (response.status === 429) { return FunctionsResult.err("LanguageModel:RateLimitExceeded", { retryAfterMillis: 20000 }); } // その他のエラーを処理します ... } } function convertMessages( messages: FunctionsGenericChatCompletionRequestMessages, ): Array<{ role: string; content: string; }> { return messages.map((genericChatMessage: GenericChatMessage) => { return { role: convertRole(genericChatMessage.role), content: genericChatMessage.content }; }); } function convertRole(role: ChatMessageRole): "system" | "user" | "assistant" { switch (role) { case "SYSTEM": return "system"; case "USER": return "user"; case "ASSISTANT": return "assistant"; default: throw new Error(`Unsupported role: ${role}`); } }