注: 以下の翻訳の正確性は検証されていません。AIPを利用して英語版の原文から機械的に翻訳されたものです。
基本概念
従来の抽出
従来の抽出設定は、PDF メタデータ抽出、光学文字認識(OCR)検出、レイアウト検出など、大規模言語モデルに基づかないアルゴリズムを使用します。AIP Document Intelligence のこれらの設定は、メディアアイテム変換エンドポイントを元にしています。
AIP Document Intelligence でのドキュメント抽出用メディア変換の使用について詳しくはこちら。
前処理
より複雑なドキュメントを扱うユースケースでは、VLM と前処理手法を組み合わせることで、高い効果が得られることが実証されています。設定 > 生成 AI で、ドキュメントの前処理をオンにします。ドキュメントの前処理では、基本的にドキュメントに対して従来の OCR(光学文字認識)を実行し、ドキュメントのページ自体に加えてその出力を VLM に渡すことで、モデルがドキュメントを適切に分析するためのコンテキストを増やします。
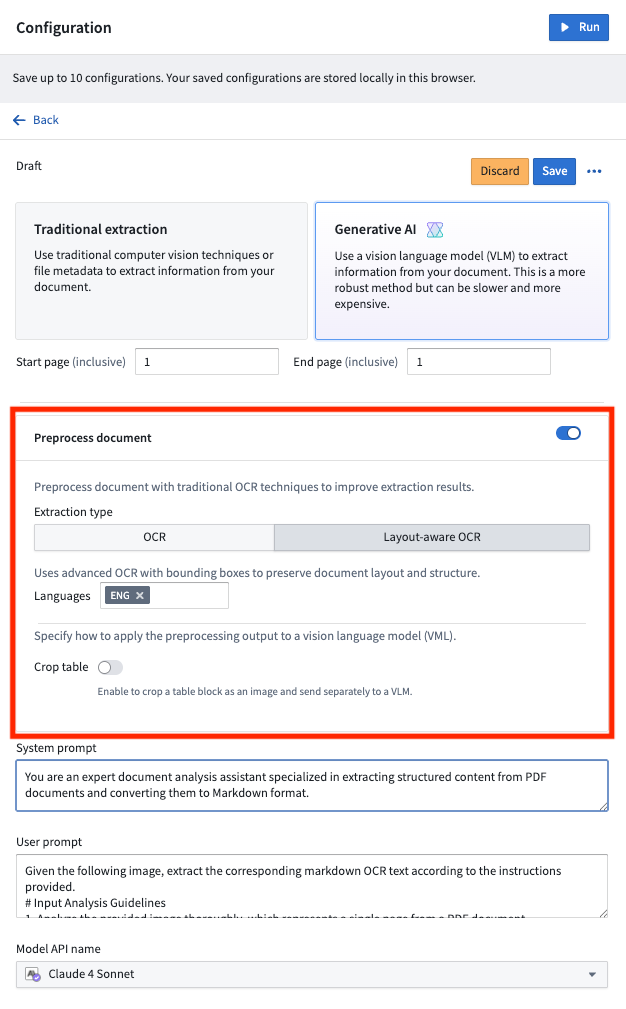
評価
現在、抽出の評価を実行できるのは、お使いのエンロールメントで Anthropic Claude 4 Sonnet が利用可能な場合のみです。
抽出戦略を実行するたびに、選択した VLM を評価者として活用する定性的な評価基準を表示できます。プロンプトは、戦略によってテーブルやヘッダーなどがどの程度適切に抽出されたかを含む、さまざまな観点を1(最低)から5(最高)までで評価するように細かく調整されています。評価を活用すると、さまざまなプロンプトや戦略を試しながら、すばやく改善を繰り返して判断できます。
デプロイ方法
特定の戦略に満足できたら、バッチパイプラインにデプロイして、より広範なデータセットに対して実行することも、ページ単位の抽出を行う Python 関数としてデプロイすることもできます。ページ単位の関数を使用すると、オントロジーを利用し、ユースケースの要件に合わせた構造を持つ独自の抽出ワークフローを作成できます。
Python トランスフォーム
戦略を Python トランスフォームのリポジトリテンプレートにエクスポートできます。このテンプレートは完全に動的で、データセットの RID/パス、モデルの RID/パス、カスタムプロンプト、選択した設定はすべて自動的に設定されます。ビルドをトリガーする前に、この内容を確認することを推奨します。
Python 関数

プラットフォーム内のガイドに沿って進め、生成されたコードスニペットを使用して、抽出戦略を使用する Python 関数リポジトリを設定します。これらの関数は、一度に1ページを抽出します。Automate などのツールで独自のオーケストレーション戦略を使用し、オントロジーに合わせてこのワークフローをカスタマイズします。