注: 以下の翻訳の正確性は検証されていません。AIPを利用して英語版の原文から機械的に翻訳されたものです。
任意のデータ保存
ワークブック内の各トランスフォームについて、結果をデータセットとして保存するかどうかを選択できます。
データセットとして保存するかどうかを選択する
デフォルトでは、新しいトランスフォームはデータセットとして保存されません。保存するには、ロジックペインのトグルを使用します。
トランスフォームを未保存から保存済みに変更すると、以前保存したデータセットに再リンクされます。以前保存したデータセットが存在しない場合は、新しいデータセットが作成されます。

これらのスクリーンショットでは、NYC Taxi & Limousine Commission ↗ のオープンソースデータを使用しています。
複数のトランスフォームの保存設定を一度に変更するには、左側の一括エディターを使用します。

保存されるトランスフォームには、青い水平バーが表示されます。
実行モデル
ノードを実行すると、そのノードの上流にある未保存のすべてのノードのロジックも実行されます。下の図では、保存済みトランスフォーム C を実行すると、未保存トランスフォーム A のロジックも実行されます。

未保存トランスフォーム A のコードを変更して実行せずに、保存済みトランスフォーム C を実行すると、保存済みトランスフォーム C の結果にはロジックの変更が反映されます。
未保存トランスフォーム D を実行すると、保存済みトランスフォーム C が Foundry データセットから読み込まれ、未保存トランスフォーム B のロジックが実行されます。

保存済みトランスフォーム C のトグルを切り替え、データセットとして保存しない設定にしたとします。未保存トランスフォーム D を実行すると、上流にある3個のトランスフォームすべてのロジックが実行されます。

この場合、この一連の変換を実行する際、最終的な目的が未保存トランスフォーム D の結果を表示することであれば、上流にある3個の未保存トランスフォームをプレビューする必要はありません。未保存トランスフォーム D を実行すると、4個のトランスフォームすべての最新のロジックと、インポートしたデータセットの最新のトランザクションが使用されます。
よくある質問
トランスフォームをデータセットとして保存すべきなのはどのような場合ですか?
トランスフォームの計算負荷が非常に高く、多くのほかのトランスフォームの上流で使用される場合は、パフォーマンスの低下を防ぐために、データセットとして保存することを検討してください。
トランスフォームの結果をワークブックの外部(たとえば、別の Code Workbook や Contour 分析)で使用する場合は、トランスフォームの結果をデータセットとして保存してください。
トランスフォームで関数を非決定的に計算する場合(たとえば、row_number 関数や現在時刻を取得する関数を使用する場合)は、データセットを Foundry に保存してください。これにより、下流のトランスフォームで、データセットに書き込まれた結果そのものが使用されることが保証されます。
ワークブックに未保存のノードが長く連なっている場合は、中間ノードを保存して、ワークブックの中間状態を定期的に保存することを推奨します。
ノードをプレビューすべきなのはどのような場合ですか?
一般的には、一連のトランスフォームを作成する際にプレビュー機能を使用して、その正しさを検証し、結果をプレビューします。一連の変換をコード化した後は、プレビュー機能を使用する理由は少なくなります。
未保存のトランスフォームが Data Lineage に表示されないのはなぜですか?
Code Workbook の未保存のトランスフォームは論理ブロックであり、プロジェクト内のリソースではありません。Data Lineage を探索すると、データセットには、実行するすべてのコードが表示されます。これには、保存済みトランスフォームの上流にある未保存のトランスフォームのコードも含まれます。
たとえば、このワークブックには、未保存のトランスフォームが1個と保存済みのトランスフォームが1個含まれています。
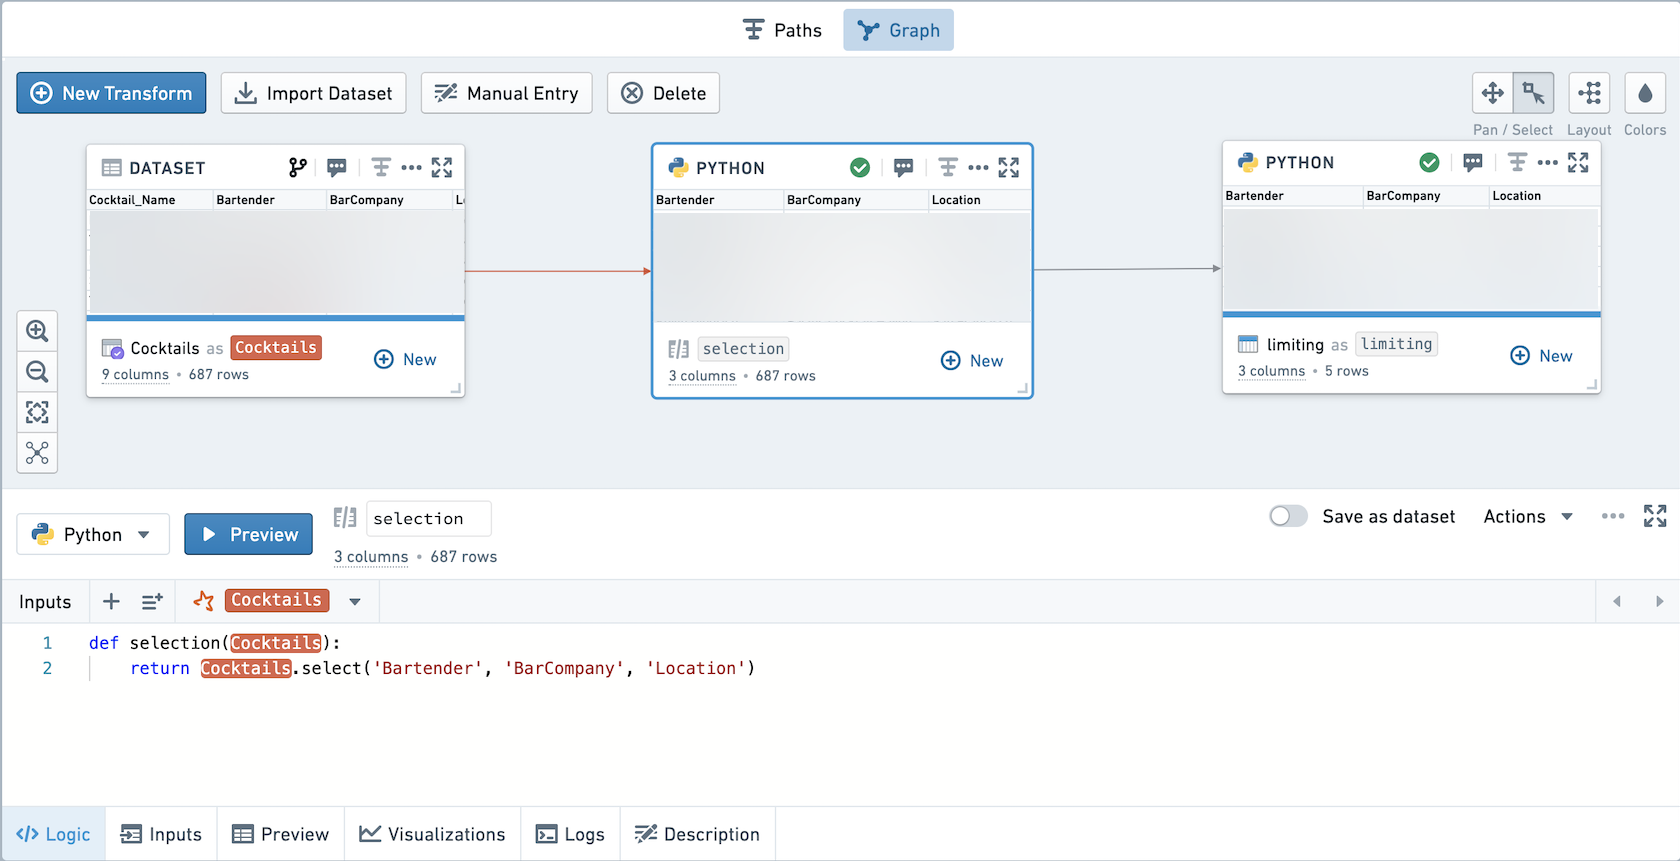
Data Lineage を探索をクリックすると、以下のように、selection トランスフォームのコードが limiting トランスフォームのコードの前に追加されて表示されます。

任意のデータ保存はパフォーマンスとリソース使用量にどのような影響を与えますか?
Code Workbook では当初、各トランスフォームを Foundry データセットとして保存する実行モデルを使用していました。現在の実行モデルでは、トランスフォームをデータセットとして保存するかどうかを選択でき、その選択はパフォーマンスとリソース使用量に影響します。
スケジュールされたビルド
以前の実行モデルで、スケジュールされたビルドを実行していたとします。新しい実行モデルでも、すべてのトランスフォームを引き続き保存する場合、パフォーマンスは以前と同じままです。
中間トランスフォームの一部を Foundry データセットとして保存する必要がないと判断し、保存しない設定にすると、パイプラインの実行速度は確実に向上します。これは、これらのノードの中間結果を Foundry に書き込む必要がなくなるためです。また、場合によっては、Spark のクエリプランナーが下流の計算をさらに最適化するのにも役立ちます。
対話的な使用
対話的に使用する場合、以前の実行モデルでは、プレビュー結果と書き込み結果の両方が計算されていました。任意の保存を使用すると、未保存のノードではプレビューのみが計算され、保存されるノードでは書き込みのみが計算されます。そのため、重複する処理がなくなり、同じワークブックを実行しても、新しい実行モデルでは以前の実行モデルより使用するリソースが少なくなります。
対話的に使用する場合、任意の保存がパフォーマンスに与える影響はより複雑です。計算負荷が非常に高いトランスフォーム(たとえば、大規模な結合)を含むワークフローでは、下流のトランスフォームを実行するたびに大規模な結合を再計算しないよう、結合を保存することを検討してください。
いずれの場合も、トランスフォームを保存しない設定にすると、Foundry に書き込まないため、ストレージ容量を節約できます。