注: 以下の翻訳の正確性は検証されていません。AIPを利用して英語版の原文から機械的に翻訳されたものです。
Contour における非決定性
非決定論的なウィンドウ関数
ウィンドウ関数で ROW_NUMBER、FIRST、LAST、LEAD、LAG、NTILE、ARRAY_AGG、または ARRAY_AGG_DISTINCT を使用する場合は、非決定性に注意してください。列 A でパーティションを分割し、列 B で並べ替える場合を考えます。列 A の値が同じ行の中に、列 B の値も同じ行が複数ある場合、これらのウィンドウ関数の結果は非決定論的になる可能性があります。つまり、同じ入力データとロジックでも、異なる結果が生成される可能性があります。
式ボードでこれらの式を使用すると、ウィンドウ関数の ORDER BY 句が決定論的であることを確認するよう求める警告が表示されます。
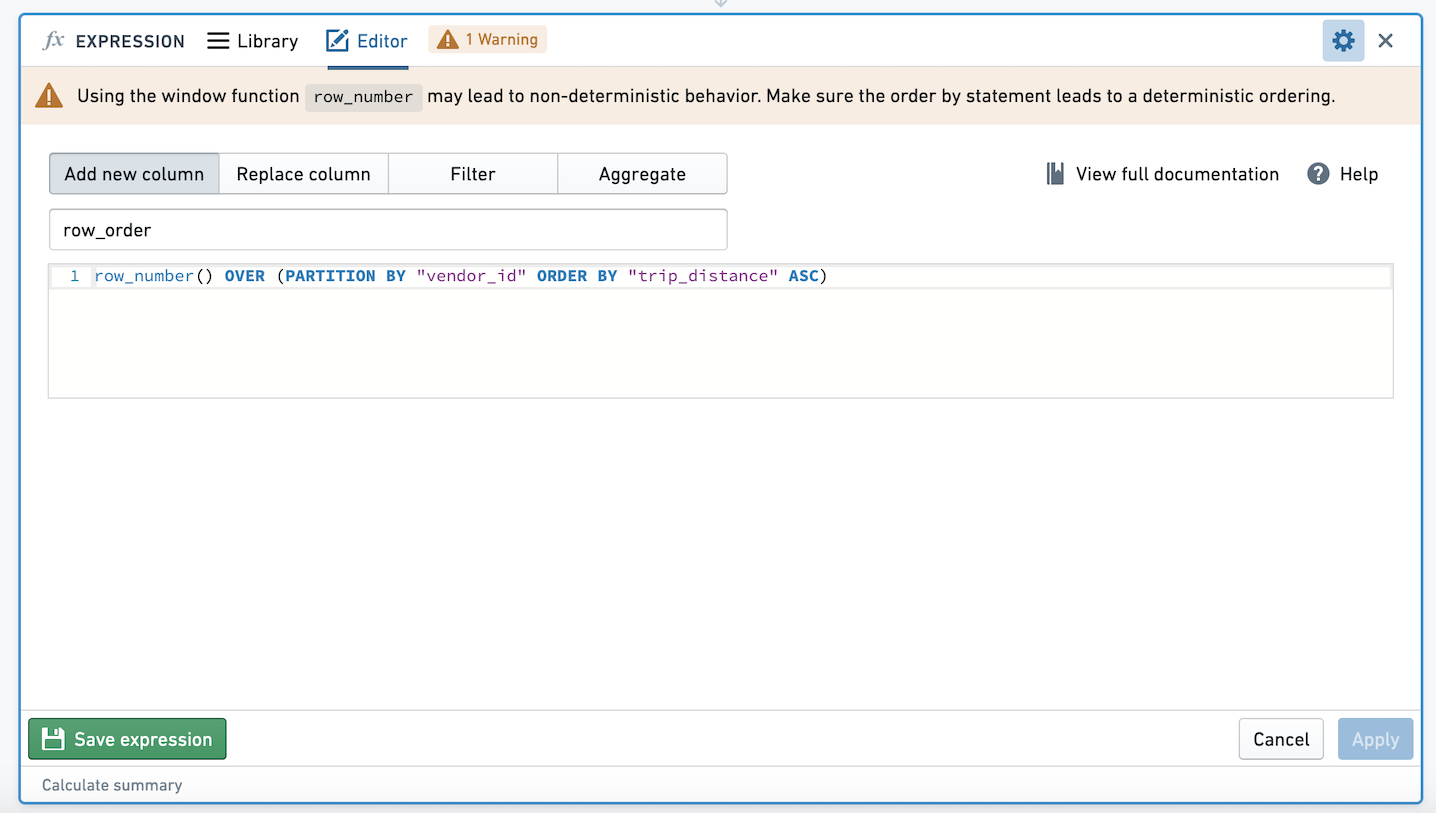
次のデータを使った例を考えます。
| 名前 | 科目 | 成績 |
|---|---|---|
| Aaron | 数学 | 95 |
| Burt | 数学 | 95 |
| Chrissy | 数学 | 80 |
| Angelica | 理科 | 77 |
| Burt | 理科 | 81 |
| Charlie | 理科 | 66 |
科目ごとに成績順で学生に順位を付けるため、式 ROW_NUMBER() OVER (PARTITION BY "class" ORDER BY "grade" DESC) を使って新しい列 rank を追加します。
次の結果になります。
| 名前 | 科目 | 成績 | 順位 |
|---|---|---|---|
| Aaron | 数学 | 95 | 1 |
| Burt | 数学 | 95 | 2 |
| Chrissy | 数学 | 80 | 3 |
| Angelica | 理科 | 77 | 2 |
| Burt | 理科 | 81 | 1 |
| Charlie | 理科 | 66 | 3 |
ただし、次の結果になることもあります。
| 名前 | 科目 | 成績 | 順位 |
|---|---|---|---|
| Aaron | 数学 | 95 | 2 |
| Burt | 数学 | 95 | 1 |
| Chrissy | 数学 | 80 | 3 |
| Angelica | 理科 | 77 | 2 |
| Burt | 理科 | 81 | 1 |
| Charlie | 理科 | 66 | 3 |
Aaron と Burt の数学の成績が同じであるため、rank 列は非決定論的です。この列を決定論的にするには、式の ORDER BY 句に「name」列を追加します:ROW_NUMBER() OVER (PARTITION BY "class" ORDER BY "grade" DESC, "name" ASC)。この式では、成績が同じ行の順位を name 列で決めるため、常に次の結果になります。
| 名前 | 科目 | 成績 | 順位 |
|---|---|---|---|
| Aaron | 数学 | 95 | 1 |
| Burt | 数学 | 95 | 2 |
| Chrissy | 数学 | 80 | 3 |
| Angelica | 理科 | 77 | 2 |
| Burt | 理科 | 81 | 1 |
| Charlie | 理科 | 66 | 3 |
その他の非決定論的な関数
上記のウィンドウ関数以外に、CURRENT_DATE、CURRENT_TIMESTAMP、CURRENT_UNIX_TIMESTAMP、および MONOTONICALLY_INCREASING_ID 関数も非決定論的です。
CURRENT_DATE、CURRENT_TIMESTAMP、および CURRENT_UNIX_TIMESTAMP の値は、パスの更新時にのみ計算されます。たとえば、1日目に CURRENT_DATE を使って新しい列を作成し、2日目に分析に戻った場合、新しい列には引き続き前日の日付が表示されます。
Double 列の集計
Spark の計算は分散処理であるため、算術演算におけるオペランドの順序は非決定論的です(たとえば、1+2 と 2+1)。この非決定論的な順序により、入力のデータ型が double の場合、集計の出力が非決定論的になることがあります。つまり、Double の集計では、入力が同じでも計算ごとに結果が異なる可能性があります。この差は、たとえば0.000001のように非常に小さいものです。
たとえば、Double 列の mean や variance を求めると、非決定論的な列になります。非決定論的な列に対して操作(たとえば、絞り込み)を実行した結果も非決定論的になります。
分析で Double 列の mean、sum、stddev、variance、corr、または sum_distinct を求めると、非決定論的な列が作成されます。
次の例を考えます。
Double 列 pickup_latitude があるとします。ピボットテーブルで、Contour は Double 列 pickup_latitude の平均を求めます。ピボット後のデータに切り替えると、非決定論的な列が作成されます。
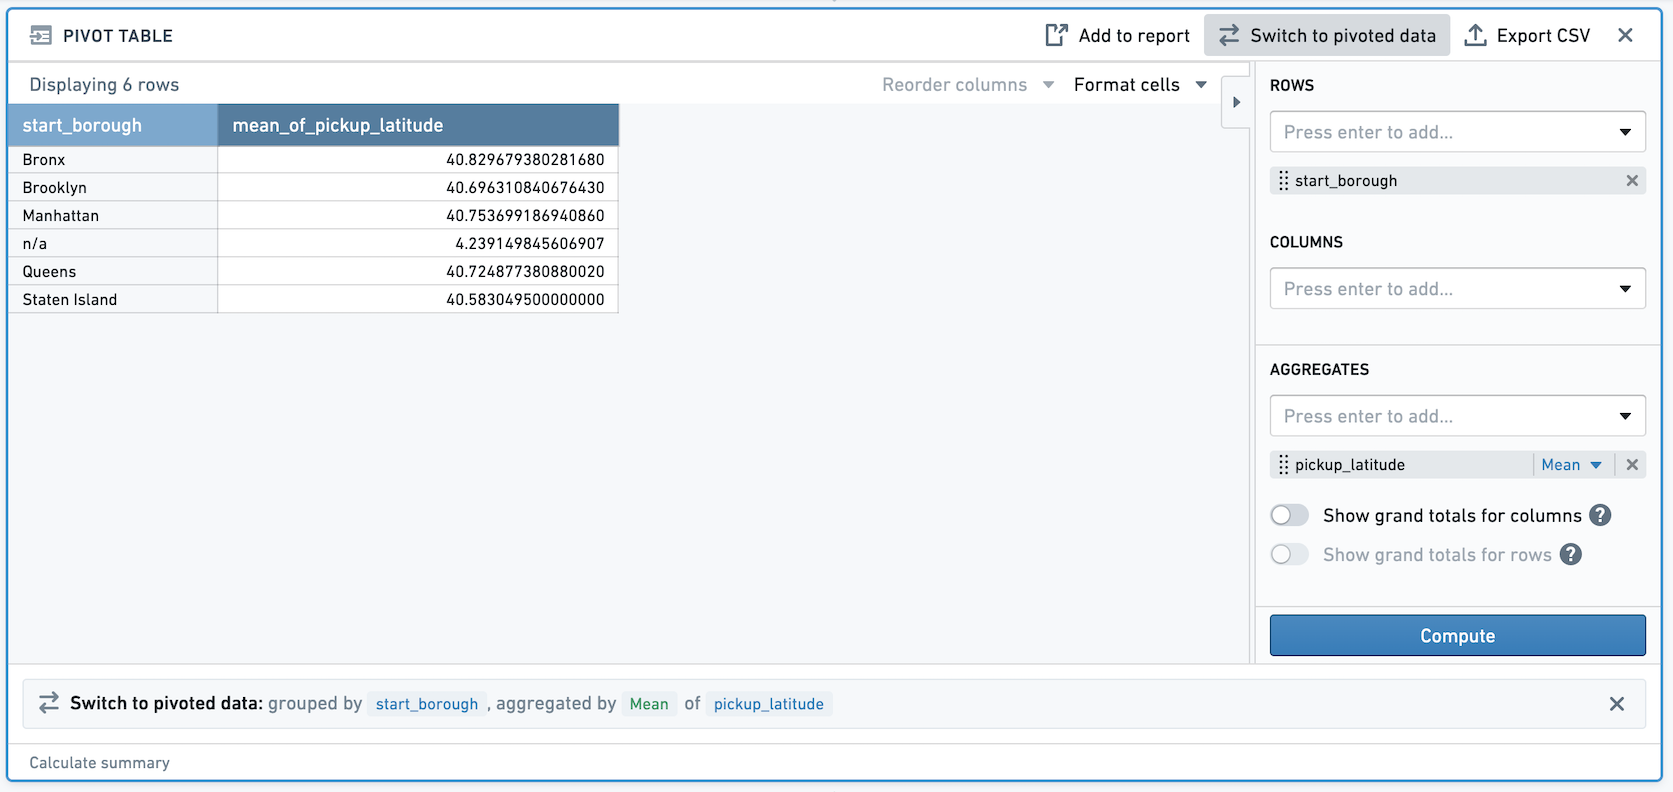
次に、新しく作成された列で絞り込むと、このフィルターの結果は非決定論的になります。たとえば、上のスクリーンショットでは、Staten Island の pickup_latitude の平均は40.5830495です。この値で絞り込むと、1行が残ります。
ただし、このパスを再計算すると、平均値がごくわずかに変わるため、絞り込み後にその行が表示されなくなる可能性があります。非決定論的な列では、完全一致フィルター(たとえば、平均 = 40.5830495での絞り込み)の使用を避けることを推奨します。また、非決定論的な列を結合キーとして使用しないことも推奨します。
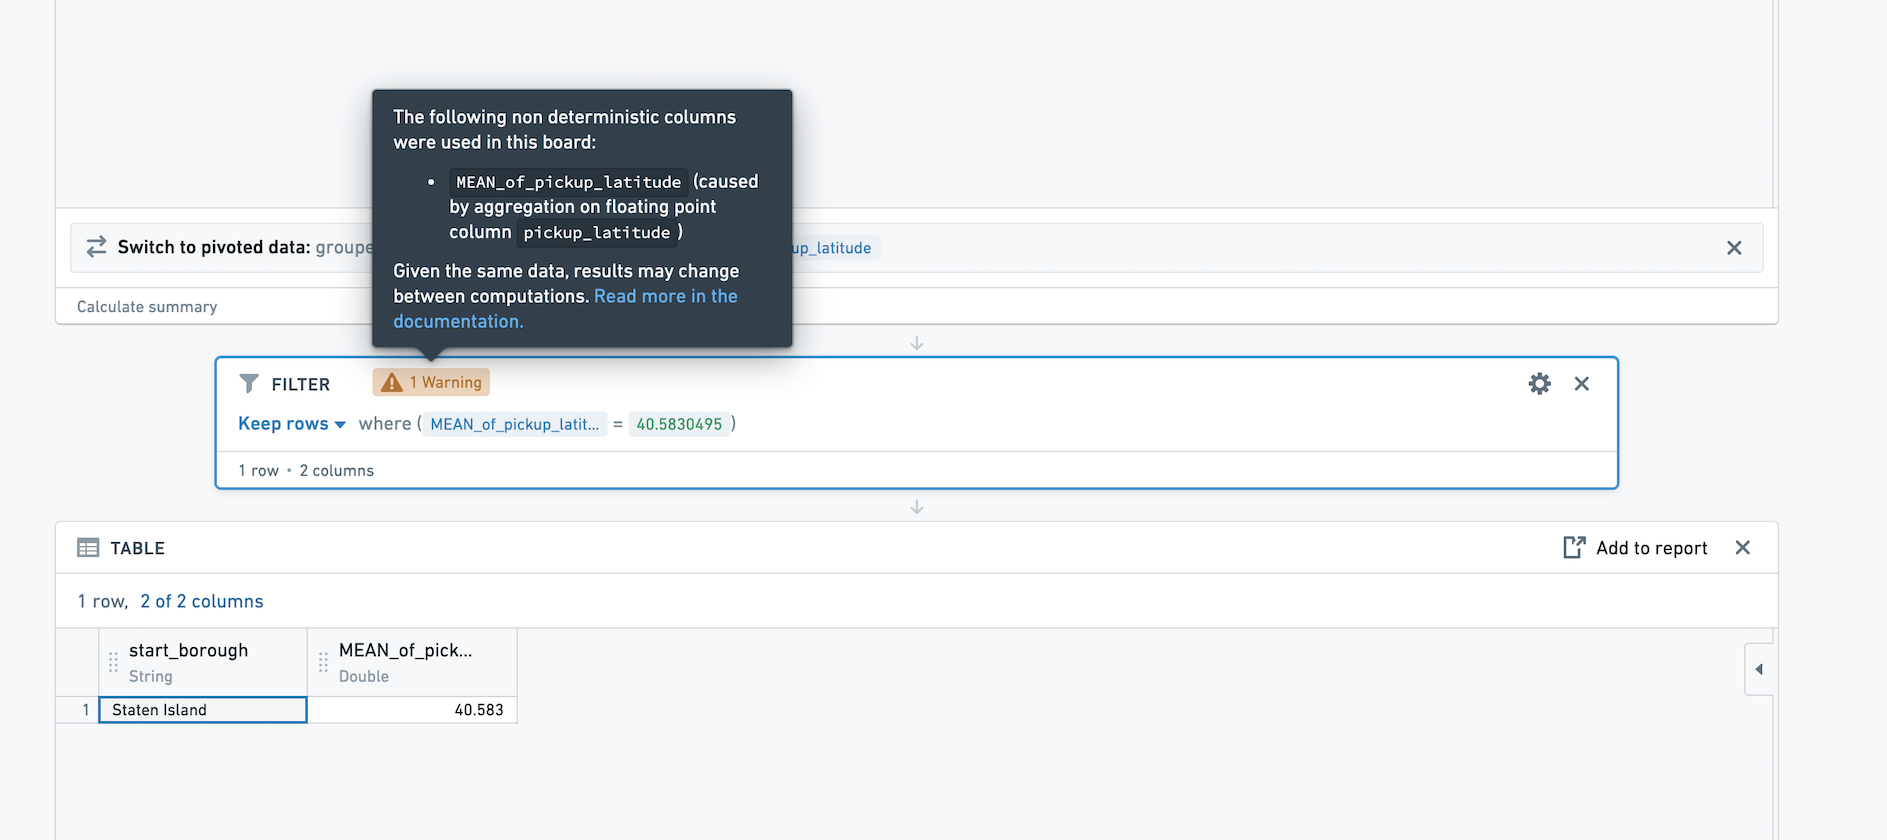
Contour で非決定論的な列に対して操作(たとえば、その列での絞り込み)を実行すると、操作を実行するボードに警告が表示されます。警告には、どの集計が非決定論的な列のソースであるかが示されます。
非決定性の診断
分析が非決定論的であることを示す兆候の1つは、行数の不一致です。たとえば、分析に概要ボードを挿入し、行数を変更しない一連の変換を実行した後、別の概要ボードを追加したとします。2個の概要ボードの行数が一致しない場合は、それより前のパスに非決定論的な操作がないかを調べる必要があります。非決定論的な関数や Double の集計を使用したときに UI に表示される警告に注意してください。