注: 以下の翻訳の正確性は検証されていません。AIPを利用して英語版の原文から機械的に翻訳されたものです。
メディア
関数を使用すると、TypeScript v2、Python、TypeScript v1 でメディアにアクセスし、変更できます。TypeScript v2 と Python は、Media データ型を使用してメディアを読み取り、アップロード、変換し、オントロジー編集とオントロジー SDK を通じたメディアのアップロードをサポートします。TypeScript v1 関数は、外部ライブラリーを使用せずにさまざまな種類のメディアを扱うための組み込み操作を備えた MediaItem データ型を提供します。
現在、標準で用意されていない操作が必要な場合は、外部ライブラリーを使用するか、独自のカスタムコードを記述する必要があると考えられます。関数リポジトリへの依存関係の追加について、詳しくはこちら。
TypeScript v2 と Python
オントロジー編集関数を使用して、メディアをアップロードし、オントロジー内にオブジェクトを作成します。アップロード後は、オブジェクトからメディアファイルを読み取り、ダウンロードして、アプリケーションで使用できます。Foundry のメディアセットについて、詳しくはこちら。
TypeScript v2 と Python の関数では、オントロジーにメディアをアップロードして Media インスタンスを取得することで、オントロジー編集を構築できます。Media データ型は MediaReference をラップし、内容の取得、メタデータの取得、オブジェクトへのメディアのアタッチを行うための高レベルの操作を公開します。Media を使用してオントロジー編集を構築することも、既存のメディアをパラメーターとして関数に渡すこともできます。
関数の入力または出力タイプとして使用する
関数では、Media を入力として受け取り、uploadMedia でデータをアップロードして一時的なメディアを作成したり、オブジェクトの Media Reference プロパティから Media を取得したりできます。また、一時的にアップロードしたものでも、オブジェクトの Media Reference プロパティから取得したものでも、関数は Media データ型を返すことができます。関数内では、Media のバイト内容やメタデータを取得したり、オントロジー編集を通じてオントロジーオブジェクトにアタッチしたりできます。TypeScript v2 と Python はどちらも、高レベルのメタデータフィールド(mediaType、sizeBytes、path。Python では snake_case)またはメディアの種類に固有の完全なメタデータを取得できます。
ライブプレビューは、メディアパラメーターを受け取る関数をサポートします。Media Reference を手動で入力する代わりに、メディアセットを検索し、その場で項目を選択できます。
Copied!1 2 3 4 5import type { Media } from "@osdk/client"; export default async function echoMedia(media: Media): Promise<Media> { return media; }
Copied!1 2 3 4 5 6 7from functions.api import function, Media # Media 型は foundry_sdk_runtime からもインポートできます # from foundry_sdk_runtime.media import Media @function def echo_media(media: Media) -> Media: return media
メディアをアップロードする
オントロジー SDK の uploadMedia(TypeScript v2)および client.ontology.media.upload_media(Python)ヘルパーを使用して、関数内で生のバイトをアップロードします。どちらも Media を返します。これを使用して、オントロジー編集でオントロジーオブジェクトのメディアプロパティを編集したり、関数から返したりできます。
Copied!1 2 3 4 5 6 7 8 9 10 11 12 13 14 15import type { Client, Media } from "@osdk/client"; import { uploadMedia } from "@osdk/functions"; export default async function uploadMediaItem( client: Client, body: string, fileName: string, ): Promise<Media> { const blob = new Blob([body], { type: "text/plain" }); const media: Media = await uploadMedia( client, { data: blob, fileName } ); return media; }
Copied!1 2 3 4 5 6 7 8 9 10 11 12from ontology_sdk import FoundryClient from foundry_sdk_runtime.media import Media from functions.api import function @function def upload_media(body: str, media_set_filename: str) -> Media: client = FoundryClient() media: Media = client.ontology.media.upload_media( body=body.encode("utf8"), filename=media_set_filename, ) return media
Copied!1 2 3 4 5 6 7 8 9 10 11 12 13from ontology_sdk import FoundryClient from foundry_sdk_runtime.media import Media from functions.api import function @function async def upload_media(body: str, media_set_filename: str) -> Media: client = FoundryClient() media_coroutine = client.ontology.media.async_upload_media( body=body.encode("utf8"), filename=media_set_filename, ) # media_coroutine は await 可能です。 return await media_coroutine
アップロードしたメディアは、オントロジーオブジェクトの Media Reference プロパティに設定しない限り、一時的なものです。オントロジー編集が適用されると、メディアはオントロジーオブジェクトのプロパティに永続化されます。
オントロジー編集関数でメディアをアップロードする
関数内でメディアをアップロードした場合でも、関数への入力として Media を受け取った場合でも、Media パラメーターを使用して、既存のオントロジーオブジェクトのメディアプロパティを更新したり、新しいオントロジーオブジェクトを作成したりできます。
Copied!1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19// TypeScript オントロジー SDK 2.16 以降を使用していることを確認してください import type { Client, Media } from "@osdk/client"; import { Aircraft } from "@ontology-sdk/sdk"; import type { Edits } from "@osdk/functions"; import { createEditBatch, uploadMedia } from "@osdk/functions"; async function uploadTextToNewPlane(client: Client): Promise<Edits.Object<Aircraft>[]> { const batch = createEditBatch<Edits.Object<Aircraft>>(client); const blob = new Blob(["Hello, world"], { type: "text/plain" }); const media: Media = await uploadMedia( client, { data: blob, fileName: "/planes/aircraft.txt" } ); batch.create(Aircraft, { myMediaProperty: media, /* ... */ }); return batch.getEdits(); } export default uploadTextToNewPlane;
Copied!1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21# Python オントロジー SDK 2.198 以降を使用していることを確認してください from ontology_sdk import FoundryClient from ontology_sdk.ontology.objects import Aircraft from functions.api import function, OntologyEdit from foundry_sdk_runtime.media import Media @function(edits=[Aircraft]) def upload_text_to_new_plane() -> list[OntologyEdit]: client = FoundryClient() edits = client.ontology.edits() media: Media = client.ontology.media.upload_media( body="Hello, world".encode("utf8"), filename="/planes/aircraft.txt", ) edits.objects.Aircraft.create( pk = "primary_key", my_media_property=media, # ... ) return edits.get_edits()
TypeScript オントロジー SDK ジェネレーターのバージョン 2.20 より前では、uploadMedia は MediaReference を返していました。バージョン 2.20 以降では、uploadMedia は Media を返します。これは、基となる MediaReference をラップし、fetchContents、fetchMetadata、getMediaReference() などの高レベルの操作を公開します。Media を createEditBatch 操作に直接渡すことができます。
アクションタイプで Media Reference パラメーターを渡す
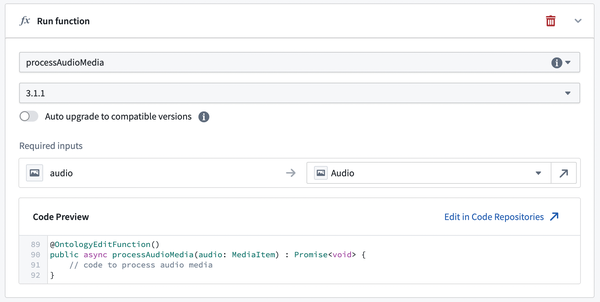
Media Reference 型のアクションパラメーターは、関数にパラメーターとして渡すことができます。
以下のスクリーンショットは、アクションがその処理を実行する関数にメディアパラメーターを渡す様子を示しています。
メディアのオントロジー SDK 操作
以下のメソッドは、upload_media から返されるインスタンスや、オブジェクトタイプの Media プロパティとして公開されるインスタンスを含め、どの Media インスタンスでも使用できます。
メディアのバイトデータを取得する
Media に保存された生データにアクセスできます。メソッドのシグネチャは次のとおりです。
Copied!1 2 3 4 5 6 7 8 9 10 11 12 13 14fetchContents(): Promise<Response>; // Response は JavaScript Fetch API の標準インターフェースです // https://developer.mozilla.org/en-US/docs/Web/API/Response const mediaContents: Response = await myAircraft.myMediaProperty.fetchContents(); if (mediaContents.ok) { const mediaMimeType = mediaContents.headers.get("Content-Type"); // Blob は JavaScript の標準データ型で、不変の生データを持つファイルのようなオブジェクトを表します。 // https://developer.mozilla.org/en-US/docs/Web/API/Blob // https://developer.mozilla.org/en-US/docs/Web/API/Response/blob const mediaBlob: Blob = await mediaContents.blob(); }
Copied!1 2 3 4 5 6get_media_content(self) -> BytesIO: ... from io import BytesIO # https://docs.python.org/3/library/io.html#io.BytesIO raw_data: BytesIO = my_aircraft.my_media_property.get_media_content()
メディアのメタデータを取得する
Media のメタデータを取得できます。
Copied!1 2 3 4 5 6fetchMetadata(): Promise<MediaMetadata>; // 使用例: const mediaMetadata = await myAircraft.myMediaProperty.fetchMetadata(); const sizeBytes = mediaMetadata.sizeBytes; const mediaType = mediaMetadata.mediaType;
Copied!1 2 3 4 5 6 7from foundry_sdk_runtime.media import MediaMetadata # 使用例: media_metadata: MediaMetadata = my_aircraft.my_media_property.get_media_metadata() path = media_metadata.path size_bytes = media_metadata.size_bytes media_type = media_metadata.media_type
どちらの言語でも、メディアの種類に応じた完全なメタデータを取得できます。このメタデータには、ドキュメントのページ数や画像の寸法およびバンドなど、その種類にのみ適用されるフィールドが含まれます。TypeScript v2 は fetchFullMetadata を、Python は get_media_full_metadata を公開します。それぞれが MediaFullMetadata を返し、その itemMetadata(Python では item_metadata)はメディアの種類を判別する判別可能なユニオン型です。
種類に固有のフィールドにアクセスするには、まずユニオン型を絞り込みます。TypeScript v2 では、文字列の判別子 itemMetadata.type を確認します。Python では、バリアントのクラスとともに isinstance を使用するか、item_metadata.type を確認します。
Copied!1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17// fetchFullMetadata には @osdk/client 2.56.0 以降を使用していることを確認してください。 fetchFullMetadata?(): Promise<MediaFullMetadata>; // ほかのバリアントには "audio"、"video"、"spreadsheet"、"model3d"、"dicom"、 // "email"、"untyped" があります。型定義の全体を参照してください。 // https://github.com/palantir/osdk-ts/blob/main/packages/api/src/object/Media.ts const fullMetadata = await myAircraft.myMediaProperty.fetchFullMetadata?.(); const itemMetadata = fullMetadata?.itemMetadata; if (itemMetadata?.type === "document") { const pageCount = itemMetadata.pages; const title = itemMetadata.title; } else if (itemMetadata?.type === "imagery") { const dimensions = itemMetadata.dimensions; const bands = itemMetadata.bands; }
Copied!1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22get_media_full_metadata(self) -> MediaFullMetadata: ... # ほかのバリアントには AudioMediaItemMetadata、VideoMediaItemMetadata、 # SpreadsheetMediaItemMetadata、Model3dMediaItemMetadata、DicomMediaItemMetadata、 # EmailMediaItemMetadata、UntypedMediaItemMetadata があります。スキーマの全体を参照してください。 # https://github.com/palantir/foundry-platform-python/blob/develop/docs/v2/MediaSets/models/MediaItemMetadata.md from foundry_sdk.v2.media_sets.models import ( DocumentMediaItemMetadata, ImageryMediaItemMetadata, ) from foundry_sdk_runtime.media import MediaFullMetadata full_metadata: MediaFullMetadata = my_aircraft.my_media_property.get_media_full_metadata() item = full_metadata.item_metadata if isinstance(item, DocumentMediaItemMetadata): page_count = item.pages title = item.title elif isinstance(item, ImageryMediaItemMetadata): dimensions = item.dimensions bands = item.bands
TypeScript v2 では、外部で実装された Media が引き続きコンパイルできるように、fetchFullMetadata は Media インターフェースの任意のメンバーになっています。オントロジー SDK が返すすべての Media はこのメソッドを実装しているため、上記のように ?.() を使用して安全に呼び出せます。
TypeScript v2 は、unknown バリアントも定義しています。インストール済みの SDK バージョンでまだモデル化されていないメディアの種類をプラットフォームが返した場合、itemMetadata はこのバリアントを使用し、itemMetadata.raw は確認できるように元のペイロードを保持します。型を絞り込むには、@osdk/client をアップグレードします。unknown バリアントは、任意のファイル形式を受け入れるメディアセットのプラットフォーム型である untyped バリアントとは異なります。
メディアを変換する
メディア変換はベータ版の開発段階にあります。開発が進むにつれて、機能が変更される可能性があります。
メディアアイテムを変換(画像の回転、サイズ変更、再エンコード、PDF ページの切り出しやレンダリング、OCR の実行など)し、結果を待つことができます。変換ジョブが送信され、完了するまでポーリングされると、変換されたコンテンツが返されます。
TypeScript v2 では、変換は試験的なヘルパーとして @osdk/api/unstable を通じて公開されています。Python では、生成された FoundryClient で client.ontology.media.transform_and_wait を呼び出します。非同期版の async_transform_and_wait は同じ引数を受け取り、await できます。
Copied!1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40// transformAndWait には @osdk/api 2.55.0 以降を使用していることを確認してください。 // 2.55.0 より前のバージョンでは、このヘルパーは // __EXPERIMENTAL__NOT_SUPPORTED_YET__transformAndWait としてエクスポートされ、"mediaReference" // 引数を、以下に示す "media" 引数の代わりに受け取っていました。 // // MediaTransformation は判別可能なユニオン型です。 // 各バリアント(`$image`、`$video`、`$audio`、`$documentToText`、`$documentToImage`、`$documentToDocument`、`$audioToText` など)は // 変換の種類を選択し、それぞれ独自のエンコーディングと操作のフィールドを持ちます。 // バリアントと操作の全体については、MediaTransformation の型定義を参照してください。 // https://github.com/palantir/osdk-ts/blob/main/packages/api/src/experimental/MediaTransformation.ts import { transformAndWait, type MediaTransformation } from "@osdk/api/unstable"; import type { Client, Media } from "@osdk/client"; import { uploadMedia } from "@osdk/functions"; export default async function rotateImage( client: Client, media: Media, ): Promise<Media> { const transformation: MediaTransformation = { $image: { $encoding: "jpg", $operations: [{ $rotate: { $angle: "DEGREE_180" } }], }, }; const result: Response = await client(transformAndWait).transformAndWait({ media, transformation, options: { pollIntervalMs: 3000, pollTimeoutMs: 30000 }, }); if (!result.ok) { // 変換に失敗しました。詳細は result.status / result.text() を確認してください。 throw new Error(`Transformation failed with status ${result.status}`); } // 関数が Media を返すように、変換後のバイト列を再アップロードします。 return uploadMedia(client, { data: await result.blob(), fileName: "rotated.jpg" }); }
Copied!1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35from foundry_sdk.v2.media_sets.models import ( ImageTransformation, JpgFormat, RotateImageOperation, ) from foundry_sdk_runtime.errors import ( MediaTransformationFailedError, MediaTransformationTimeoutError, ) from foundry_sdk_runtime.media import Media from functions.api import function from ontology_sdk import FoundryClient @function(beta=True) def image_transform(document: Media) -> Media: client = FoundryClient() transformation = ImageTransformation( encoding=JpgFormat(), operations=[RotateImageOperation(angle="DEGREE_180")], ) try: transformed_bytes: bytes = client.ontology.media.transform_and_wait( media_reference=document.get_media_reference(), transformation=transformation, poll_interval_seconds=3.0, poll_timeout_seconds=30.0, ) except MediaTransformationFailedError: # 変換ジョブが FAILED ステータスを報告しました。 raise except MediaTransformationTimeoutError: # ジョブが完了する前に poll_timeout_seconds が経過しました。 raise # 関数が Media を返すように、変換後のバイト列を再アップロードします。 return client.ontology.media.upload_media(body=transformed_bytes, filename="rotated.jpg")
例:PDF の各ページに対して OCR を実行し、境界ボックスを出力する
このワークフローは、PDF(メディアセットにアップロードされたもの、またはオブジェクトにアタッチされたもの)を受け取り、すべてのページで OCR を実行して hOCR 出力を要求します。hOCR は、検出されたすべての単語と行に bbox 属性を持つ HTML なので、同じレスポンスから認識されたテキストとその境界ボックス座標の両方を抽出できます。transform_and_wait の各呼び出しは1ページ分のバイトデータを返します。ドキュメント全体を処理するには、呼び出しを繰り返します。
Copied!1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39import { transformAndWait, type MediaTransformation } from "@osdk/api/unstable"; import type { Client, Media } from "@osdk/client"; import type { Integer } from "@osdk/functions"; export default async function ocrPdfPages( client: Client, media: Media, pageCount: Integer, ): Promise<string[]> { const runTransformation = client(transformAndWait).transformAndWait; const pageResults: string[] = []; for (let pageNumber = 0; pageNumber < pageCount; pageNumber++) { const transformation: MediaTransformation = { $documentToText: { $operation: { $ocrOnPage: { $pageNumber: pageNumber, $parameters: { $outputFormat: { $hocr: {} }, $languages: [{ $language: "ENG" }], }, }, }, }, }; const result = await runTransformation({ media, transformation, options: { pollTimeoutMs: 120_000 }, }); if (!result.ok) { throw new Error(`OCR failed on page ${pageNumber}: ${result.status}`); } pageResults.push(await result.text()); } return pageResults; }
Copied!1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46from foundry_sdk.v2.media_sets.models import ( DocumentMediaItemMetadata, DocumentToTextTransformation, OcrHocrOutputFormat, OcrLanguageWrapper, OcrOnPageOperation, OcrParameters, ) from foundry_sdk_runtime.media import Media from functions.api import function from ontology_sdk import FoundryClient @function(beta=True) def ocr_pdf_pages(document: Media) -> list[bytes]: """PDF のすべてのページで OCR を実行し、ページごとに hOCR のバイト列を返します。 各 hOCR ドキュメントには、検出された単語、行、 段落の `bbox` 属性が含まれます。任意の HTML パーサーでパースすると、1回の処理でテキストと 境界ボックスの両方を復元できます。 """ client = FoundryClient() metadata = document.get_media_full_metadata().item_metadata if not isinstance(metadata, DocumentMediaItemMetadata) or metadata.pages is None: raise ValueError("Expected a PDF document with a known page count") media_reference = document.get_media_reference() page_results: list[bytes] = [] for page_number in range(metadata.pages): transformation = DocumentToTextTransformation( operation=OcrOnPageOperation( page_number=page_number, parameters=OcrParameters( output_format=OcrHocrOutputFormat(), languages=[OcrLanguageWrapper(language="ENG")], ), ), ) hocr_bytes: bytes = client.ontology.media.transform_and_wait( media_reference=media_reference, transformation=transformation, poll_timeout_seconds=120.0, ) page_results.append(hocr_bytes) return page_results
情報量の多いページでは、OCR の実行時間がデフォルトの関数タイムアウトを大幅に超えることがあります。関数の実行タイムアウトを設定するには、公開済み関数を管理するを参照してください。
例:PDF ページを画像としてレンダリングし、範囲を切り出す
各ページの視覚的なレンダリングが必要なワークフロー(下流での画像注釈、埋め込み、表示など)では、$documentToImage と $renderPage を使用して、特定のページの PNG/JPG 画像を取得します。PDF の一部の範囲を独立した PDF ドキュメントとして抽出するには、$documentToDocument と $slicePdfRange を使用します。以下の各関数は、Media を返せるように、変換されたバイトデータを再アップロードします。各関数は独立したモジュールであり、登録された関数はモジュールの export default です。
1ページを PNG 画像としてレンダリングします。
Copied!1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24import { transformAndWait, type MediaTransformation } from "@osdk/api/unstable"; import type { Client, Media } from "@osdk/client"; import { uploadMedia } from "@osdk/functions"; export default async function renderFirstPageAsPng( client: Client, media: Media, ): Promise<Media> { const transformation: MediaTransformation = { $documentToImage: { $encoding: "png", $operation: { $renderPage: { $pageNumber: 0, $width: 1200 } }, }, }; const result = await client(transformAndWait).transformAndWait({ media, transformation, }); if (!result.ok) { throw new Error(`Render failed: ${result.status}`); } // 関数が Media を返すように、レンダリングしたページを再アップロードします。 return uploadMedia(client, { data: await result.blob(), fileName: "page.png" }); }
Copied!1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23from foundry_sdk.v2.media_sets.models import ( DocumentToImageTransformation, PngFormat, RenderPageOperation, ) from foundry_sdk_runtime.media import Media from functions.api import function from ontology_sdk import FoundryClient @function(beta=True) def render_first_page_as_png(document: Media) -> Media: """PDF のページ0を幅 1200px の PNG としてレンダリングし、Media として返します。""" client = FoundryClient() transformation = DocumentToImageTransformation( encoding=PngFormat(), operation=RenderPageOperation(page_number=0, width=1200), ) rendered_png: bytes = client.ontology.media.transform_and_wait( media_reference=document.get_media_reference(), transformation=transformation, ) # 関数が Media を返すように、レンダリングしたページを再アップロードします。 return client.ontology.media.upload_media(body=rendered_png, filename="page.png")
ページ範囲を切り出して新しい PDF ドキュメントにします。
Copied!1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30import { transformAndWait, type MediaTransformation } from "@osdk/api/unstable"; import type { Client, Media } from "@osdk/client"; import { uploadMedia } from "@osdk/functions"; export default async function sliceFirstTenPages( client: Client, media: Media, ): Promise<Media> { const transformation: MediaTransformation = { $documentToDocument: { $encoding: "pdf", $operation: { $slicePdfRange: { $startPageInclusive: 0, $endPageExclusive: 10, $strictlyEnforceEndPage: false, }, }, }, }; const result = await client(transformAndWait).transformAndWait({ media, transformation, }); if (!result.ok) { throw new Error(`Slice failed: ${result.status}`); } // 関数が Media を返すように、切り出した PDF を再アップロードします。 return uploadMedia(client, { data: await result.blob(), fileName: "slice.pdf" }); }
Copied!1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27from foundry_sdk.v2.media_sets.models import ( DocumentToDocumentTransformation, PdfFormat, SlicePdfRangeOperation, ) from foundry_sdk_runtime.media import Media from functions.api import function from ontology_sdk import FoundryClient @function(beta=True) def slice_first_ten_pages(document: Media) -> Media: """入力 PDF のページ0~9を含む新しい PDF を Media として返します。""" client = FoundryClient() transformation = DocumentToDocumentTransformation( encoding=PdfFormat(), operation=SlicePdfRangeOperation( start_page_inclusive=0, end_page_exclusive=10, strictly_enforce_end_page=False, # 10ページ未満のドキュメントを許容します ), ) sliced_pdf: bytes = client.ontology.media.transform_and_wait( media_reference=document.get_media_reference(), transformation=transformation, ) # 関数が Media を返すように、切り出した PDF を再アップロードします。 return client.ontology.media.upload_media(body=sliced_pdf, filename="slice.pdf")
例:検出された境界ボックスで各ページに注釈を付ける
視覚的なデバッグ出力(OCR で検出された境界ボックスを重ねて描画した、各 PDF ページのレンダリング)を生成するには、各ページに対して3つの変換を連結します。各ページを画像としてレンダリングし、同じページに対して OCR を実行して、単語と行の境界ボックスを取得します。次に、レンダリングされた画像を再アップロードし、画像注釈操作で注釈を付けます。ページ数は完全なメタデータから取得するため、TypeScript v2 では fetchFullMetadata、Python では get_media_full_metadata を使用して読み取ります。各ステップでは、前のステップのバイトデータを新たにアップロードして、次のステップに渡します。この関数は、注釈を付けた各ページを再アップロードするため、ページごとに1個の Media を返します。
Copied!1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94import { transformAndWait, type MediaTransformation } from "@osdk/api/unstable"; import type { Client, Media } from "@osdk/client"; import { uploadMedia } from "@osdk/functions"; export default async function annotatePdfWithOcrBoxes( client: Client, media: Media, ): Promise<Media[]> { const runTransformation = client(transformAndWait).transformAndWait; // 完全なメタデータを使ってページ数を調べます。 const fullMetadata = await media.fetchFullMetadata?.(); const itemMetadata = fullMetadata?.itemMetadata; if (itemMetadata?.type !== "document" || itemMetadata.pages == null) { throw new Error("Expected a PDF document with a known page count"); } const annotatedPages: Media[] = []; for (let pageNumber = 0; pageNumber < itemMetadata.pages; pageNumber++) { const renderTransformation: MediaTransformation = { $documentToImage: { $encoding: "png", $operation: { $renderPage: { $pageNumber: pageNumber, $width: 1200 } }, }, }; const ocrTransformation: MediaTransformation = { $documentToText: { $operation: { $ocrOnPage: { $pageNumber: pageNumber, $parameters: { $outputFormat: { $hocr: {} }, $languages: [{ $language: "ENG" }], }, }, }, }, }; // 1. ページを PNG としてレンダリングし、同じページで OCR を実行します。どちらも // 同じソースドキュメントを読み取り、互いに独立しているため、同時に実行できます。 const [renderResult, ocrResult] = await Promise.all([ runTransformation({ media, transformation: renderTransformation }), runTransformation({ media, transformation: ocrTransformation, options: { pollTimeoutMs: 120_000 }, }), ]); if (!renderResult.ok || !ocrResult.ok) { throw new Error(`Page ${pageNumber} failed to render or OCR`); } // 2. hOCR をパースし、画像のピクセル単位で境界ボックスを取得します。 // parseHocrBoundingBoxes ヘルパーはここでは省略しています。例の下の注記を参照してください。 const boxes = parseHocrBoundingBoxes(await ocrResult.text()); // 3. レンダリングした PNG を一時的なメディアアイテムとして再アップロードします。 const renderedMedia = await uploadMedia(client, { data: await renderResult.blob(), fileName: `page-${pageNumber}.png`, }); // 4. メディア変換を使って、レンダリングしたページに注釈を付けます。 const annotateTransformation: MediaTransformation = { $image: { $encoding: "png", $operations: [{ $annotate: { $annotations: boxes.map(({ label, boundingBox }) => ({ $geometry: { $boundingBox: boundingBox }, $label: label, })), }, }], }, }; const annotatedResult = await runTransformation({ media: renderedMedia, transformation: annotateTransformation, }); if (!annotatedResult.ok) { throw new Error(`Annotation failed on page ${pageNumber}`); } // 5. 関数が Media を返すように、注釈を付けたページを再アップロードします。 annotatedPages.push(await uploadMedia(client, { data: await annotatedResult.blob(), fileName: `page-${pageNumber}-annotated.png`, })); } return annotatedPages; }
Copied!1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94from foundry_sdk.v2.media_sets.models import ( AnnotateImageOperation, Annotation, BoundingBox, BoundingBoxGeometry, DocumentMediaItemMetadata, DocumentToImageTransformation, DocumentToTextTransformation, ImageTransformation, OcrHocrOutputFormat, OcrLanguageWrapper, OcrOnPageOperation, OcrParameters, PngFormat, RenderPageOperation, ) from foundry_sdk_runtime.media import Media from functions.api import function from ontology_sdk import FoundryClient @function(beta=True) def annotate_pdf_with_ocr_boxes(document: Media) -> list[Media]: """PDF のすべてのページをレンダリングし、各ページで OCR を実行してテキストの境界ボックスを見つけ、 レンダリングした画像に描画し、ページごとに注釈付きの Media を1個返します。""" client = FoundryClient() media_reference = document.get_media_reference() # 完全なメタデータを使ってページ数を調べます。 metadata = document.get_media_full_metadata().item_metadata if not isinstance(metadata, DocumentMediaItemMetadata) or metadata.pages is None: raise ValueError("Expected a PDF document with a known page count") annotated_pages: list[Media] = [] for page_number in range(metadata.pages): # 1. ページを PNG としてレンダリングします。 rendered_png: bytes = client.ontology.media.transform_and_wait( media_reference=media_reference, transformation=DocumentToImageTransformation( encoding=PngFormat(), operation=RenderPageOperation(page_number=page_number, width=1200), ), ) # 2. 同じページで hOCR モードの OCR を実行し、単語単位の境界ボックスを取得します。 hocr_bytes: bytes = client.ontology.media.transform_and_wait( media_reference=media_reference, transformation=DocumentToTextTransformation( operation=OcrOnPageOperation( page_number=page_number, parameters=OcrParameters( output_format=OcrHocrOutputFormat(), languages=[OcrLanguageWrapper(language="ENG")], ), ), ), poll_timeout_seconds=120.0, ) # 3. hOCR をパースし、画像のピクセル単位で境界ボックスを取得します。 # parse_hocr_bounding_boxes ヘルパーはここでは省略しています。例の下の注記を参照してください。 boxes: list[tuple[str, BoundingBox]] = parse_hocr_bounding_boxes(hocr_bytes) # 4. レンダリングした PNG を一時的なメディアアイテムとして再アップロードします。 rendered_media = client.ontology.media.upload_media( body=rendered_png, filename=f"page-{page_number}.png" ) # 5. Media の変換を使って、レンダリングしたページに注釈を付けます。 annotated_bytes: bytes = client.ontology.media.transform_and_wait( media_reference=rendered_media.get_media_reference(), transformation=ImageTransformation( encoding=PngFormat(), operations=[ AnnotateImageOperation( annotations=[ Annotation( geometry=BoundingBoxGeometry(bounding_box=box), label=label, ) for label, box in boxes ], ), ], ), ) # 6. 関数が Media を返すように、注釈を付けたページを再アップロードします。 annotated_pages.append( client.ontology.media.upload_media( body=annotated_bytes, filename=f"page-{page_number}-annotated.png" ) ) return annotated_pages
Copied!1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96import asyncio from foundry_sdk.v2.media_sets.models import ( AnnotateImageOperation, Annotation, BoundingBox, BoundingBoxGeometry, DocumentMediaItemMetadata, DocumentToImageTransformation, DocumentToTextTransformation, ImageTransformation, OcrHocrOutputFormat, OcrLanguageWrapper, OcrOnPageOperation, OcrParameters, PngFormat, RenderPageOperation, ) from foundry_sdk_runtime.media import Media from functions.api import function from ontology_sdk import FoundryClient @function(beta=True) async def annotate_pdf_with_ocr_boxes(document: Media) -> list[Media]: """PDF のすべてのページをレンダリングし、各ページで OCR を実行して注釈を付け、ページごとに Media を1個返します。""" client = FoundryClient() media_reference = document.get_media_reference() metadata = document.get_media_full_metadata().item_metadata if not isinstance(metadata, DocumentMediaItemMetadata) or metadata.pages is None: raise ValueError("Expected a PDF document with a known page count") async def annotate_page(page_number: int) -> Media: # ページの PNG としてのレンダリングと、同じページの OCR を同時に実行します。 # どちらの変換も同じソースドキュメントを読み取り、互いに独立しているため、 # asyncio.gather により、順番にではなく並列でポーリングできます。 rendered_png, hocr_bytes = await asyncio.gather( client.ontology.media.async_transform_and_wait( media_reference=media_reference, transformation=DocumentToImageTransformation( encoding=PngFormat(), operation=RenderPageOperation(page_number=page_number, width=1200), ), ), client.ontology.media.async_transform_and_wait( media_reference=media_reference, transformation=DocumentToTextTransformation( operation=OcrOnPageOperation( page_number=page_number, parameters=OcrParameters( output_format=OcrHocrOutputFormat(), languages=[OcrLanguageWrapper(language="ENG")], ), ), ), poll_timeout_seconds=120.0, ), ) # hOCR のパースによる境界ボックスの取得(同期版の例を参照)と、 # レンダリングした PNG の一時的なメディアアイテムとしての再アップロードを同時に実行します。 boxes, rendered_media = await asyncio.gather( async_parse_hocr_bounding_boxes(hocr_bytes), client.ontology.media.async_upload_media( body=rendered_png, filename=f"page-{page_number}.png", ), ) # Media の変換を使って、レンダリングしたページに注釈を付けます。 annotated_bytes: bytes = await client.ontology.media.async_transform_and_wait( media_reference=rendered_media.get_media_reference(), transformation=ImageTransformation( encoding=PngFormat(), operations=[ AnnotateImageOperation( annotations=[ Annotation( geometry=BoundingBoxGeometry(bounding_box=box), label=label, ) for label, box in boxes ], ), ], ), ) # 関数が Media を返すように、注釈を付けたページを再アップロードします。 return await client.ontology.media.async_upload_media( body=annotated_bytes, filename=f"page-{page_number}-annotated.png", ) # すべてのページを同時に処理します。 return list(await asyncio.gather(*(annotate_page(p) for p in range(metadata.pages))))
hOCR のパース用ヘルパーは、どちらの例でも省略しています。任意の HTML パーサーを使用して、class="ocrx_word" 要素とその title="bbox X1 Y1 X2 Y2 ..." 属性を抽出できます。Python では、lxml や BeautifulSoup などのパーサーを使用し、一致した各要素を BoundingBox(left=X1, top=Y1, width=X2-X1, height=Y2-Y1) に変換します。TypeScript v2 では、一致した各要素を { $left: X1, $top: Y1, $width: X2-X1, $height: Y2-Y1 } に変換します。
TypeScript v1
TypeScript v1 は、関数内でのメディアのアップロードに対応していません。以下の例では、既存のメディアをオントロジーの編集に渡す方法と、オブジェクトタイプのメディアプロパティを操作する方法を説明します。
Foundry は、TypeScript v1 関数の実行時に厳格なメモリー制限を適用します。このメモリー制限を超えないように、操作するメディアファイルは 20 MB 未満にしてください。
オブジェクトに既存のメディアを設定する
オントロジー編集関数を使用して、既存のメディアアイテムをオブジェクトにアタッチします。
Copied!1 2 3 4 5 6 7 8 9 10 11 12 13import { OntologyEditFunction, MediaItem } from "@foundry/functions-api"; import { Aircraft } from "@foundry/ontology-api"; export class MyFunctions { @OntologyEditFunction() public async setExistingMediaToObject( aircraft: Aircraft, mediaItem: MediaItem ): Promise<void> { // 渡された MediaItems を使ったオントロジーの編集に対応しています aircraft.myMediaProperty = mediaItem; } }
オブジェクトタイプのメディアアイテムパラメーター
次の例は、オブジェクトタイプの Media Reference プロパティに対する isAudio メディア操作を示しています。
Copied!1MediaItem.isAudio(objectType.mediaReferenceProperty)
未加工メディアデータを読み取る
オブジェクトの Media Reference プロパティを選択すると、メディアアイテムにアクセスできます。メソッドのシグネチャは次のとおりです。
Copied!1 2 3// Blob は JavaScript の標準データ型で、不変の生データを持つファイルのようなオブジェクトを表します。 // https://developer.mozilla.org/en-US/docs/Web/API/Blob readAsync(): Promise<Blob>;
メディアのメタデータを取得する
メディアアイテムのメタデータにアクセスできます。メソッドのシグネチャは次のとおりです。
Copied!1getMetadataAsync(): Promise<IMediaMetadata>;
型ガード
TypeScript v1 の型ガードを使用すると、特定のメディア形式に固有の機能にアクセスできます。メディアアイテムのメタデータでは、次の型ガードを使用できます。
isAudioMetadata()isDicomMetadata()isDocumentMetadata()isImageryMetadata()isSpreadsheetMetadata()isUntypedMetadata()isVideoMetadata()
たとえば、画像の型ガードを使用して、画像固有のメタデータフィールドを抽出できます。
Copied!1 2 3 4 5const metadata = await myObject.mediaReference?.getMetadataAsync(); if (isImageryMetadata(metadata)) { const imageWidth = metadata.dimensions?.width; ... }
メディアアイテムの名前空間でも型ガードを使用でき、形式固有のメディアアイテムのより多くのメソッドにアクセスできます。ここで使用できる型ガードは次のとおりです。
MediaItem.isAudio()MediaItem.isDicom()MediaItem.isDocument()MediaItem.isImagery()MediaItem.isSpreadsheet()MediaItem.isVideo()
ドキュメント固有の操作
テキスト抽出
ドキュメントからテキストを抽出するには、光学文字認識(OCR)を使用するか、メディアアイテムの埋め込みテキストを抽出できます。
機械生成された PDF では、光学文字認識(OCR)を使用するよりも、PDF にデジタルで埋め込まれたテキストを抽出する方が高速であるか、精度が高い、またはその両方である場合があります。以下は、テキスト抽出の使用例です。
Copied!1extractTextAsync(options: IDocumentExtractTextOptions): Promise<string[]>;
TypeScript v1 を使用する場合は、必要に応じて次の項目をオブジェクトとして指定できます。
startPage:0始まりの開始ページ(この値を含む、空でも可)endPage:0始まりの終了ページ(この値を含まない、空でも可)。
startPage と endPage の両方を空にした場合、ドキュメントのすべてのページのテキストが返されます。
機械生成ではない PDF では、テキストの抽出に OCR メソッドを使用するのが最適です。
Copied!1ocrAsync(options: IDocumentOcrOptions): Promise<string[]>;
必要に応じて、次の項目を TypeScript オブジェクトとして指定できます。
startPage:0始まりの開始ページ(この値を含む)。endPage:0始まりの終了ページ(この値を含まない)。languages:認識する言語のリスト(空でも可)。scripts:認識する文字体系のリスト(空でも可)。outputType:出力タイプをtextまたはhocrとして指定します。
メディア形式固有の操作にアクセスするには、型ガードを使用する必要があることに留意してください。以下は、isDocument() 型ガードを使用して OCR によるテキスト抽出を実行する例です。
Copied!1 2 3 4 5 6 7 8 9 10 11 12import { MediaItem } from "@foundry/functions-api"; import { ArxivPaper } from "@foundry/ontology-api"; @Function() public async firstPageText(paper: ArxivPaper): Promise<string | undefined> { if (MediaItem.isDocument(paper.mediaReference)) { const text = (await paper.mediaReference.ocrAsync({ endPage: 1, languages: [], scripts: [], outputType: 'text' }))[0]; return text; } return undefined; }
音声固有の操作
文字起こし
音声メディアアイテムは、transcribe メソッドを使用した文字起こしに対応しています。シグネチャは次のとおりです。
Copied!1transcribeAsync(options: IAudioTranscriptionOptions): Promise<string>;
文字起こしの実行方法を指定するため、必要に応じて次の項目を渡すことができます。
language:文字起こしする言語。TranscriptionLanguage列挙型を使用して渡します。performanceMode:より経済的またはより高性能のモードで文字起こしを実行します。TranscriptionPerformanceMode列挙型を使用して渡します。outputFormat:typeがplainTextNoSegmentData(プレーンテキスト)またはpttmlのオブジェクトを渡して、出力形式を指定します。pttmlは TTML に似た ↗ 形式で、データ型がplainTextNoSegmentDataの場合、オブジェクトはブールパラメーターaddTimestampsも受け取ります。
文字起こしのオプションを指定する例です。
Copied!1 2 3 4 5 6 7 8 9 10 11 12 13 14 15import { Function, MediaItem, TranscriptionLanguage, TranscriptionPerformanceMode } from "@foundry/functions-api"; import { AudioFile } from "@foundry/ontology-api"; @Function() public async transcribeAudioFile(file: AudioFile): Promise<string|undefined> { if (MediaItem.isAudio(file.mediaReference)) { return await file.mediaReference.transcribeAsync({ language: TranscriptionLanguage.ENGLISH, performanceMode: TranscriptionPerformanceMode.MORE_ECONOMICAL, outputFormat: {type: "plainTextNoSegmentData", addTimestamps: true} }); } return undefined; }