注: 以下の翻訳の正確性は検証されていません。AIPを利用して英語版の原文から機械的に翻訳されたものです。
ドキュメント処理
このページでは、PDF ドキュメントや画像からデータを抽出する際に役立つ考慮事項をいくつか説明します。
データ抽出
このページでは、Pipeline Builder を使用してセマンティック検索用に PDF をパースするための基本的なガイドと、テキストコンテンツのみがある場合に Workshop アプリケーションで情報を表示するための推奨事項を紹介します。
セマンティック検索は、PDF に対して使用できる強力なツールです。特に、コンテンツを小さな「チャンク」に分割して個別に埋め込みを生成すると、ユーザーやワークフローが、通常はアクセスしにくい重要な情報を見つけやすくなります。PDF には、見過ごされがちな非構造化の知識が膨大に含まれていることを考えると、これは特に有用です。
使用するには、PDF を Foundry にアップロードし、テキストを抽出してチャンクに分割し、それらのチャンクを検索します。その検索結果とともに対応する PDF を横に表示することで、ユーザーが信頼できる元の情報と照合して検証できます。
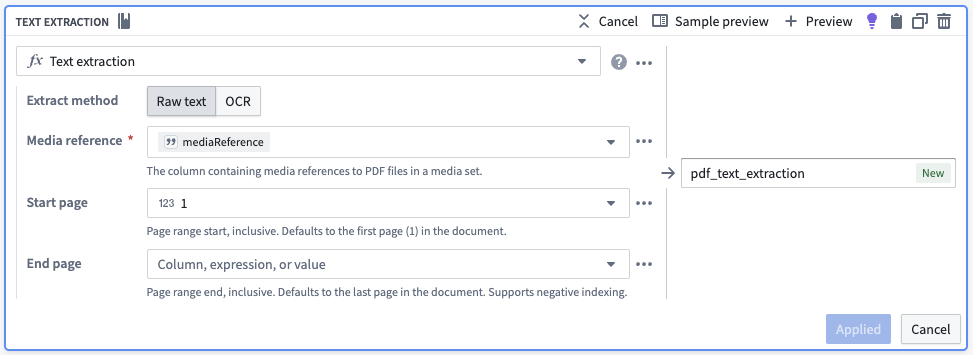
PDF をインポートしてテキストを抽出するには、以下の手順に沿って進めます。
- PDF をメディアセットとしてインポートします。
- メディアセットを Pipeline Builder に追加します。
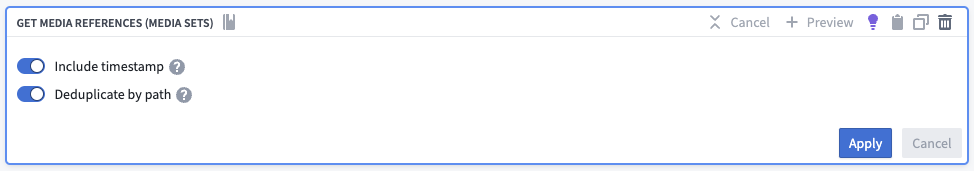
- Media Reference を取得ボードを使用します。
- テキスト抽出ボードを使用します。
チャンク化
このページでは、セマンティック検索のワークフローに基本的なチャンク化戦略を組み込む方法を説明します。このコンテキストにおけるチャンク化とは、大きなテキストを小さなテキストに分割することです。埋め込みモデルにはテキストの最大入力長があり、さらに重要な点として、小さなテキストは検索時に意味的な違いがより明確になるため、チャンク化には利点があります。チャンク化は、PDF のような大きなドキュメントをパースする際によく使用されます。
主な目的は、長いテキストを小さな「チャンク」に分割し、それぞれに対応するオントロジーオブジェクトを元のオブジェクトにリンクすることです。
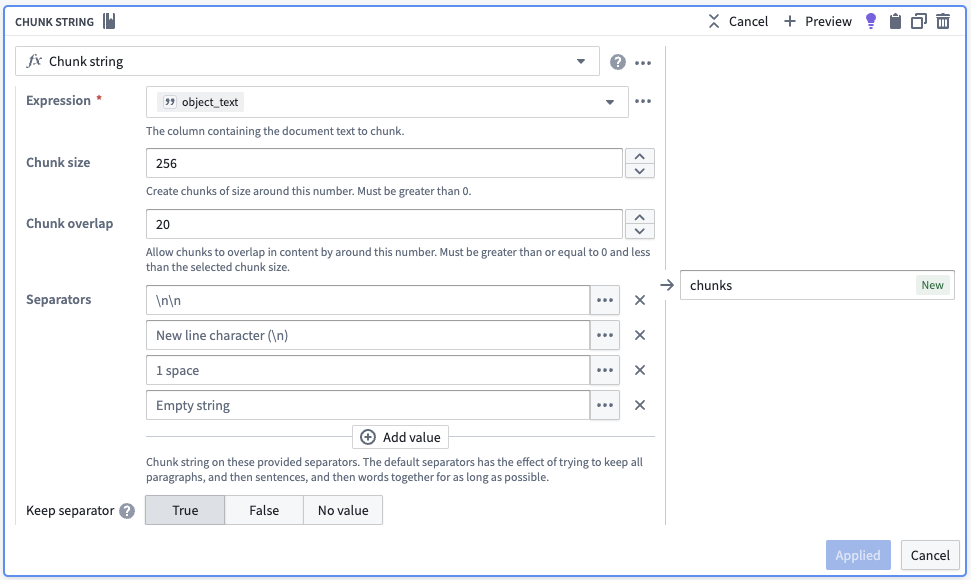
チャンク化は、Pipeline Builder の文字列をチャンク化ボードで実行します。データ加工メニューからボードを追加し、次の引数を設定します。
- 式: チャンクに分割するテキスト列です。
- チャンクサイズ: 各チャンクのおおよその文字数です。
- チャンクの重複: 各チャンクが前のチャンクと共有する文字数です。チャンクの境界をまたいでコンテキストを保持するのに役立ちます。
- 区切り文字: ボードがテキストの分割に使用する、優先順位順に並べた区切り文字のリストです。ボードはまず優先順位が最も高い区切り文字で分割し、チャンクがまだチャンクサイズを超えている場合にのみ、次の区切り文字に進みます。
引数の完全なリファレンスについては、Chunk string 関数のドキュメントを参照してください。
チャンク化の例
まず、Pipeline Builder でコードを使用せずに基本的なチャンク化戦略を実現する方法を示します。より高度な戦略については、パイプラインの一部としてコードリポジトリを使用することを推奨します。
説明のために、object_id と object_text の2列を持つ、単純な2行のデータセットを使用します。理解しやすいように、以下の object_text の例は意図的に短くしています。
| object_id | object_text |
|---|---|
| abc | gold ring lost |
| xyz | fast cars zoom |
まず、文字列をチャンク化ボードを使用します。このボードは、object_text を小さな部分に分割した配列を含む列を追加します。ボードは重複や区切り文字など、さまざまなチャンク化の方法に対応しており、各意味概念の一貫性と独自性を維持できます。
以下の文字列をチャンク化ボードのスクリーンショットは、ユースケースに合わせて変更できる単純な戦略を示しています。以下の設定では、サイズが約256文字のチャンクを返そうとします。具体的には、各チャンクがチャンクサイズ以下になるまで、ボードは優先順位が最も高い区切り文字でテキストを分割します。優先順位が最も高い区切り文字でそれ以上分割できず、一部のチャンクがまだ大きすぎる場合は、次の区切り文字に進みます。これを、すべてのチャンクがチャンクサイズ以下になるか、使用できる区切り文字がなくなるまで繰り返します。最後に、ボードは特定した各チャンクについて、次のチャンクが前のチャンクの末尾20文字を含む重複部分を持つようにします。
| object_id | object_text | chunks |
|---|---|---|
| abc | gold ring lost | [gold,ring,lost] |
| xyz | fast cars zoom | [fast,cars,zoom] |
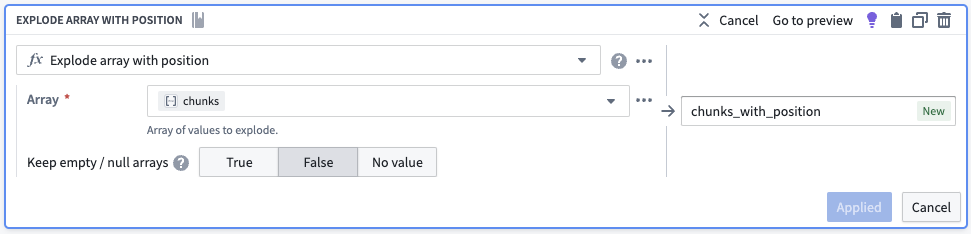
次に、配列の各要素をそれぞれ別の行にします。位置付きで配列を展開ボードを使用して、データセットを6行のデータセットに変換します。各行の新しい列(以下を参照)は、配列内の位置と配列内の要素という2つのキーと値のペアを持つ構造体(マップ)です。
| object_id | object_text | chunks | chunks_with_position |
|---|---|---|---|
| abc | gold ring lost | [gold,ring,lost] | {position:0, element} |
| abc | gold ring lost | [gold,ring,lost] | {position:1, element} |
| abc | gold ring lost | [gold,ring,lost] | {position:2, element} |
| xyz | fast cars zoom | [fast,cars,zoom] | {position:0, element} |
| xyz | fast cars zoom | [fast,cars,zoom] | {position:1, element} |
| xyz | fast cars zoom | [fast,cars,zoom] | {position:2, element} |
そこから、位置と要素をそれぞれ別の列に取り出します。
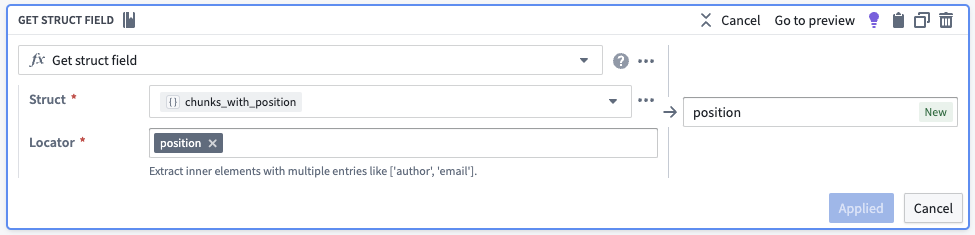
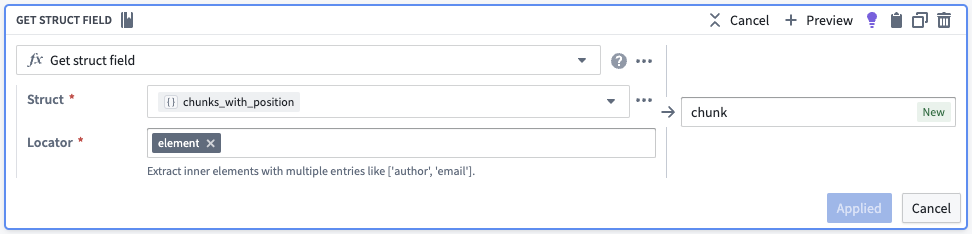
| object_id | object_text | chunks | chunks_with_position | position | chunk |
|---|---|---|---|---|---|
| abc | gold ring lost | [gold,ring,lost] | {position:0, element} | 0 | gold |
| abc | gold ring lost | [gold,ring,lost] | {position:1, element} | 1 | ring |
| abc | gold ring lost | [gold,ring,lost] | {position:2, element} | 2 | lost |
| xyz | fast cars zoom | [fast,cars,zoom] | {position:0, element} | 0 | fast |
| xyz | fast cars zoom | [fast,cars,zoom] | {position:1, element} | 1 | cars |
| xyz | fast cars zoom | [fast,cars,zoom] | {position:2, element} | 2 | zoom |
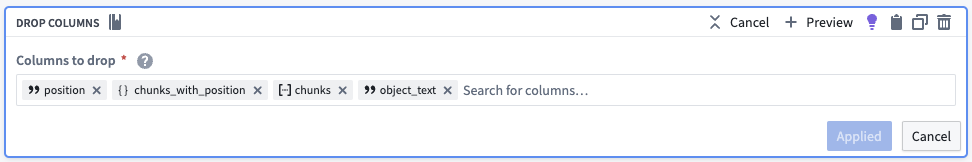
各チャンクの一意の識別子を作成するには、配列内でのチャンクの位置を文字列に変換し、元のオブジェクトIDに連結します。不要な列も削除します。
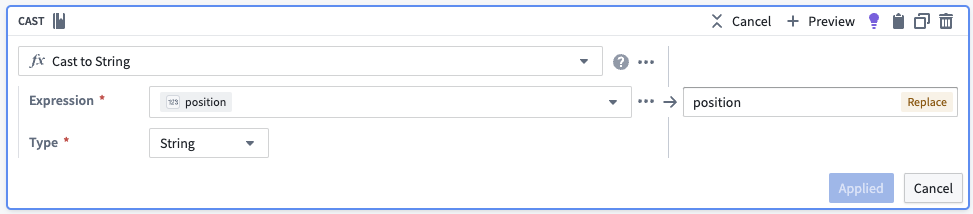
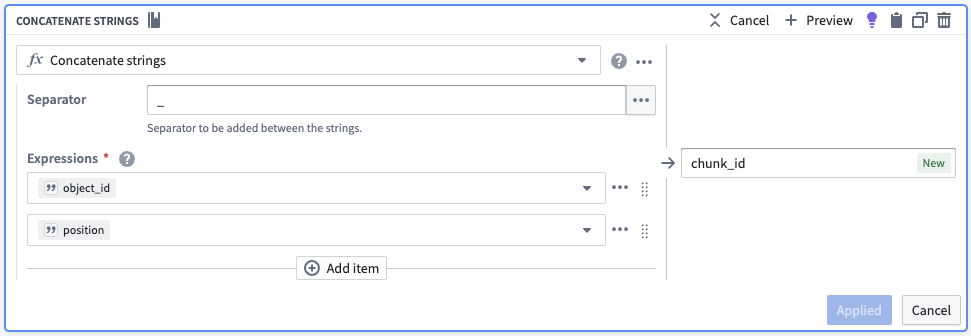
| object_id | chunk | chunk_id |
|---|---|---|
| abc | gold | abc_0 |
| abc | ring | abc_1 |
| abc | lost | abc_2 |
| xyz | fast | xyz_0 |
| xyz | cars | xyz_1 |
| xyz | zoom | xyz_2 |
これで、6個の異なるチャンクを表す6行ができました。各行には、リンク用の object_id、新しい主キーとなる chunk_id、セマンティック検索ワークフローの説明に従って埋め込みを生成する chunk があります。結果は、次のテーブルになります。
| object_id | chunk | chunk_id | embedding |
|---|---|---|---|
| abc | gold | abc_0 | [-0.7,...,0.4] |
| abc | ring | abc_1 | [0.6,...,-0.2] |
| abc | lost | abc_2 | [-0.8,...,0.9] |
| xyz | fast | xyz_0 | [0.3,...,-0.5] |
| xyz | cars | xyz_1 | [-0.1,...,0.8] |
| xyz | zoom | xyz_2 | [0.2,...,-0.3] |