注: 以下の翻訳の正確性は検証されていません。AIPを利用して英語版の原文から機械的に翻訳されたものです。
Spark の詳細を理解する
Apache Spark ↗ は、Foundry のデータ統合レイヤーで最もよく使用される実行エンジンです。パイプラインのパフォーマンス特性を理解し、最適化する方法を見つけるには、Spark でコードがどのように実行されているかを詳しく理解することが重要です。Foundry は、Spark でのジョブのパフォーマンスを表示し、理解するための統合ツールを提供しています。このページでは、利用可能な Spark の詳細の概要と、その意味について説明します。
Spark の詳細にアクセスする
Foundry でビルドされたデータセットの Spark の詳細を表示するには、次の手順に従います。
- ビルドレポートを表示します。
- データセットプレビューまたは Data Lineage で、履歴タブを選択し、リスト内の個別のビルドを選択してから、Build レポートを表示を選択します。
- すべてのビルドの画面では、リスト内のビルドを選択するだけです。
- ジョブを選択します。ビルドは1個以上のジョブで構成され、ガントチャートの下にあるリストに表示されます。リストからジョブを選択し、Spark の詳細ボタンを選択します。
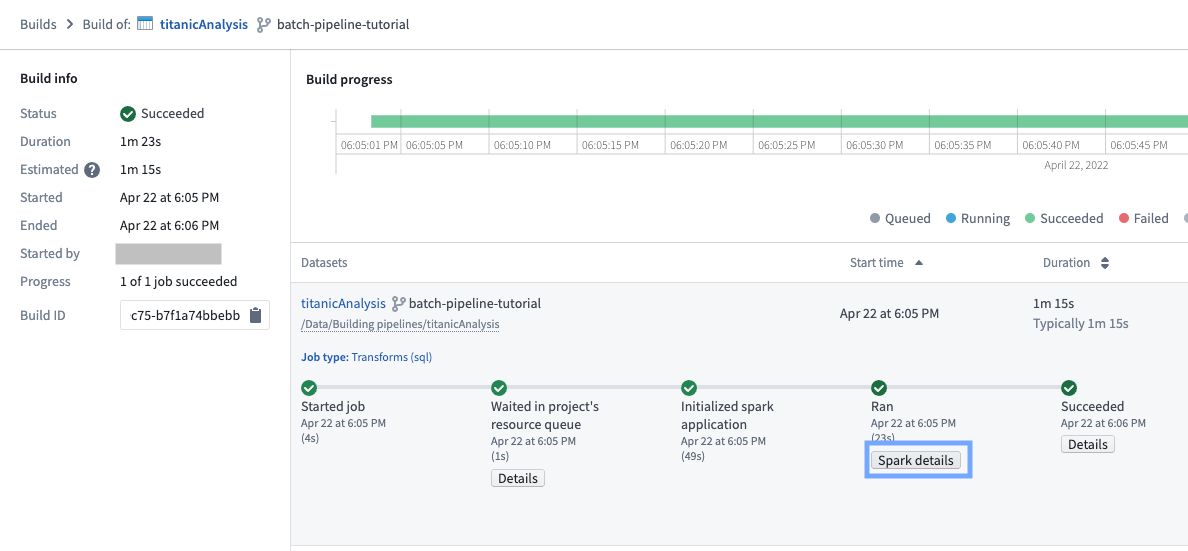
Spark の詳細ページには、Spark でのジョブの実行に関する情報が表示されます。各ジョブについて、以下に示すさまざまなカテゴリーの情報が表示されます。

概要タブ
概要タブには、ジョブに関する次の情報が表示されます。
ジョブの概要メトリクス
- すべてのタスクの合計実行時間: すべてのステージにおけるすべてのタスクの実行時間の合計
- ジョブにかかった時間: Spark の計算にかかった時間(最初のステージの開始から最後のステージの完了までの時間)
この2つのメトリクスから、次の式で並列度を計算できます。
Total runtime across all tasks / Job duration
比率が1に近い場合、並列度が低いことを示します。
-
ディスク流出: すべてのステージで、エグゼキューターの RAM からディスクに移動されたデータのサイズ。
- これは、データがエグゼキューターのメモリーに収まらない場合に発生します。ディスクへの書き込みとディスクからの読み取りは低速な操作であるため、ジョブでディスク流出が発生すると、処理速度が大幅に低下します。実行されている計算の種類によっては、ディスク流出によってエグゼキューターのメモリーが不足し、ジョブが失敗することもあります。
- 大規模なデータセットでは、ディスク流出が発生することが想定されます。
-
シャッフル書き込み: ジョブのすべてのステージでシャッフルされたデータ量。
- シャッフルとは、Spark のステージ間およびパーティション間でデータを移動する処理です。たとえば、結合の計算(どのテーブルもブロードキャストされていない場合)、集計、再パーティション分割を行う際に発生します。
- シャッフルはネットワーク I/O とディスク I/O の両方を発生させるため、ジョブの実行時間の大部分を占めることがあります。
- そのため、パフォーマンスの高い Spark ジョブを記述するうえで重要な目標は、シャッフルを最小限に抑えることです。たとえば、ブロードキャストできる結合が実際にブロードキャストされていることを確認する、下流のジョブで同じキーによる結合や集計が頻繁に行われる可能性のあるデータセットでバケット化を活用する(このデータセットに対する下流のシャッフルを回避するため)、不要な再パーティション分割のステップを避ける、といった方法があります。
ステージの実行タイムラインとステージ間の依存関係
ジョブの開始時に、Spark はトランスフォームのコードを解釈して実行計画を作成します。この計画は、相互に依存関係を持つステージとして表現できます。次のグラフは、ステージの実行タイムラインを示しています。

通常、左端のステージは入力の読み込みを表し、右端のステージは出力の書き込みを表します。 上の例では、ステージ28、30、31、32、33、35の実行に長い時間がかかっているため、このジョブの実行時間を最適化する対象として適しています。
ステージ28、30、31、33、35は並列で実行できます。つまり、これらのステージ間には依存関係がありません。ただし、ステージ32は、それ以前のすべてのステージが完了するまで開始されません。これは次のことを意味します。
- 待ち時間は max_runtime(28, 30, 31, 33, 35) によって決まるため、ステージ35の実行時間を短縮しても、大きな改善にはつながりません。そのため、目に見える改善を得るには、これらすべてのステージを高速化する必要があります。
- ステージ32は、ジョブ全体の所要時間の約35%を占めるため、このジョブのボトルネックです。
タスクの並列度チャート
タスクの並列度チャートは、リソースがどの程度効率よく使用されているかを理解するのに役立ちます。ステージの並列度を時間の経過に沿って表示します。ジョブの並列度と同様に、ステージの並列度は次の式で計算できます。
Total runtime of tasks in the stage / Stage duration
タスクの並列度チャートの時間軸は、上のステージのガントチャートと共通になっているため、相関関係を簡単に特定できます。

上のチャートでは、ステージ32の並列度がほぼ1です。これは、このステージで行われる処理のほぼすべてが1個の(非常に長い)タスクで実行されており、計算が分散されていなかったことを示しています。
完全に分散されたジョブは、次のようになります。

ステージの詳細
特定のステージが失敗する理由や、実行速度が遅い理由を理解するには、より詳しい情報が役立つことがあります。ただし、Spark はコードをステージに変換する際にそのリネージを公開しないため、ステージの処理内容から元のコードや物理実行計画まで自動的にたどることは、現時点ではできません。
それでも、ステージの概要から、失敗したステージや実行時間の長いステージについてある程度調査できます。

タスクの半数は2秒未満で完了していますが、より注目すべきなのは最大実行時間です。1個のタスクが、ステージの合計実行時間の約63%を占めています。これは、このステージがボトルネックであり、ほぼすべての処理が1個のタスクで実行されているという、前のチャートから読み取れる内容と一致しています。
さらに詳しく調べるには、ステージの詳細に移動できます。

ここには、このステージで実行されたタスクのサンプルと、ステージ自体に関連するメトリクスが表示されます。
タスク22267-0は1時間16分かかっており、最も遅いタスクです。実際、このタスクは8100万行を処理しているのに対し、ほかのタスクは1万~70万行を処理しています。この偏りの兆候は次のとおりです。
- 大量のディスク流出:ほかのタスクが0であるのに対して190 GB
- エグゼキューターの大きなピークメモリー使用量:ほかのタスクが1 GB であるのに対して4.5 GB
エグゼキュータータブ

エグゼキュータータブでは、Spark ジョブのドライバーまたはエグゼキューターから、スタックトレースやメモリーヒストグラムなどのメトリクスを取得します。これらのメトリクスは、Spark ジョブのパフォーマンスの問題をデバッグするときに役立ちます。
スナップショットボタンを選択すると、実行中のジョブから Java スタックトレース、またはドライバーのみのメモリーヒストグラムを取得します。ジョブは実行中の状態である必要があります(ジョブが完了すると、これらのメトリクスを収集できなくなります)。
スタックトレースを使用すると、Spark ジョブの各スレッドがその時点で何を実行しているかを確認できます。たとえば、ジョブがハングしているように見える場合(つまり、進行が期待されるときに進行していない場合)、スタックトレースを取得すると、その時点で何が実行されているかがわかることがあります。
メモリーヒストグラムは、現在ヒープ上にある Java オブジェクトの数と、メモリー上でのサイズ(バイト単位)を表示します。メモリーの使用状況を理解するときや、メモリー関連の問題をデバッグするときに役立ちます。
メトリクスの取得は、実行中のジョブのパフォーマンスに影響する可能性があります。これらのメトリクスを収集するには、JVM が追加の処理を行う必要があります。たとえば、メモリーヒストグラムを取得すると、ガベージコレクションが実行されます。