注: 以下の翻訳の正確性は検証されていません。AIPを利用して英語版の原文から機械的に翻訳されたものです。
Foundry Streaming のコンピュート使用量
Foundry Streaming は、高スループットかつ低遅延のコンピュート形態です。新しく到着するメッセージを継続的に待ち受け、ユーザー定義のロジックを適用して、パイプラインの次の段階に送信します。
Foundry のストリームは、分散並列ワーカーベースのアーキテクチャを採用しています。並列ワーカーにはそれぞれ、担当するストリーミングジョブ専用のリソースが割り当てられます。ストリームに必要なリソース量は、アクティブなストリームの最大スループットと、処理するメッセージの総数に応じて増加します。
コンピュートの測定方法
ストリーミングのコンピュート使用量は、次の2種類に分かれます。
-
ライブ処理コンピュート: ライブデータに対してユーザー定義のトランスフォームを実行する処理です。このソースの種類は「streaming」と呼ばれます。
-
アーカイブコンピュート: ストリーミングレイヤーから Foundry のストレージレイヤーにデータを移動する処理です。アーカイブコンピュートはバッチ処理であり、「transform」として表示されます。
Foundry の使用量に対して支払う場合、デフォルトの streaming_usage_rate は 0.5 です。これは、ライブデータに対してユーザー定義のトランスフォームを実行する際のレートです。Palantir とエンタープライズ契約を結んでいる場合は、コンピュート使用量の計算を進める前に Palantir の担当者にお問い合わせください。
Foundry のストリームのライブ処理コンピュートは、実時間での実行期間全体にわたって使用するコンピュート秒数で測定されます。したがって、ストリーミングジョブで使用するコンピュートリソース(vCPU、メモリー、並列化など)が多くなるほど、ジョブのコストは増加します。ジョブの実行時間が長いほど、使用するコンピュート量も増加します。ストリームは継続的に実行してデータを処理し続けるように設計されているため、ユーザーが終了するまでコンピュートを使用し続けます。
ストリームのリソースは静的に割り当てられます。ストリームの実行中は、実時間の1秒あたりに一定のコンピュート秒数を使用します。また、ストリームはピーク時の需要に対応するように調整されることが多いため、ストリームのコンピュート使用量はデータ量の変動による影響を受けません。ストリームは、データが流れていない場合でもコンピュート秒数を使用します。
ストリームの使用量は、1つのジョブマネージャーと多数のタスクマネージャーが使用する総秒数の合計として計算できます。各並列ワーカーのコンピュートリソースは同一です。
ジョブマネージャーのコンピュート秒数は、次のように計算します。
max(num_vCPU, gib_ram / 7.5) * streaming_usage_rate * stream_duration_seconds
タスクマネージャーのコンピュート秒数は、次のように計算します。
max(num_vCPU, gib_ram / 7.5) * streaming_usage_rate * stream_duration_seconds * (num_parallel_task_managers + 1)compute_seconds = job_manager compute_seconds + task_manager_compute_seconds
コンピュート使用量の計算に使用する値については、メモリー対コア比率などの説明で詳しくはこちらをご覧ください。
アーカイブジョブは、各ストリームと並列して実行されるバッチ処理ジョブです。アーカイブジョブは、ストリームのホットストレージレイヤーから定期的にデータを読み込み、Foundry ストレージに移動して、堅牢な永続化と履歴の追跡を実現します。アーカイブジョブにはストリーム自体と同じ低遅延の要件がないため、スケジュールに従って実行され、アーカイブ対象のデータがある場合にのみコンピュートを使用します。
アーカイブジョブの使用量は、1つの Spark ドライバーに基づいており、次の式で計算できます。
compute_seconds = max(num_vcpu, gib_ram / 7.5) * num_seconds- アーカイブジョブは小規模です。アーカイバーは常に、1 vCPU と 4 GiB の RAM という控え目なプロファイルで実行されます。
Foundry Streaming の使用量を調査する
ストリームの総使用量を表示するには、まず Resource Management アプリケーションに移動します。次に、リソース別の使用量セクションでストリームを見つけ、詳細を選択してデータセットごとの使用量を表示します。
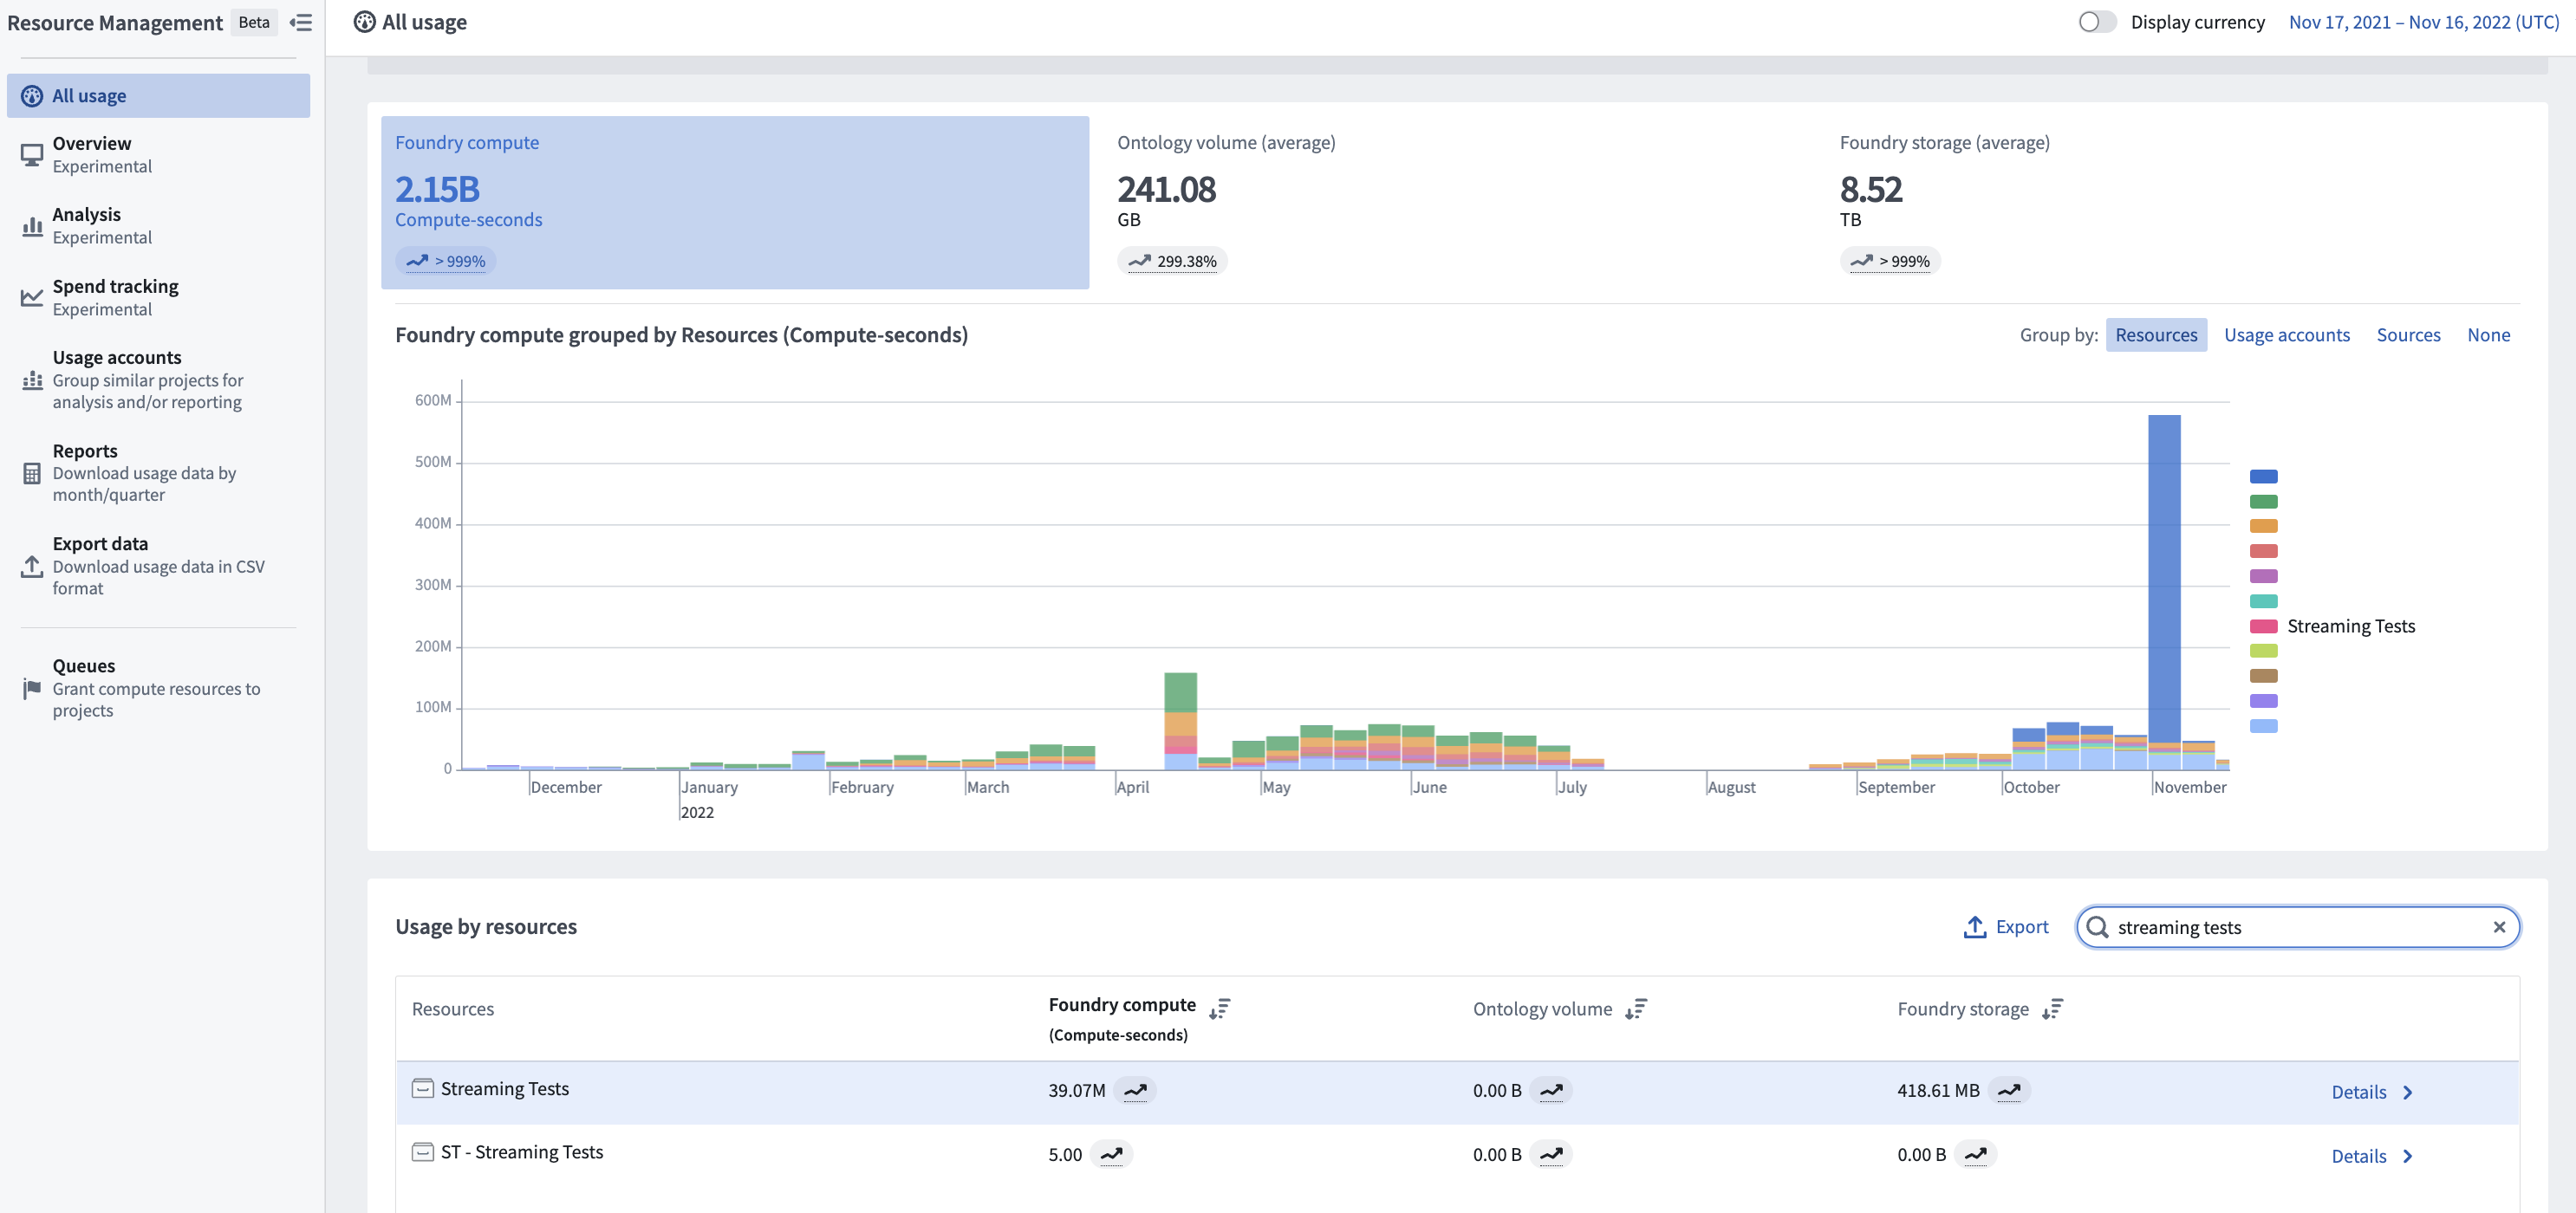
ストリームのコストは、そのストリームが生成するチェックポイントデータセットに帰属します。このデータセットは、ストリームの処理に関する永続的な使用量の記録として機能します。このデータセットのストリーミング使用量は、Resource Management アプリケーションの「streaming」カテゴリーに分類されます。
ストリームを実行すると、ユーザーが停止するまで継続して実行されます。ユーザーがストリームを停止すると、その実行がデータセットの履歴タブに表示されます。個々のストリームのプロファイルを調査して、過去のストリーム実行のパフォーマンスとコンピュート使用量を確認できます。
履歴アーカイブを実行するたびに、そのコンピュートメトリクスが Builds アプリケーションに公開されます。Builds アプリケーションを使用して、実行された各アーカイブのリソース割り当てを調査します。
使用量を左右する要因を理解する
ストリームの使用量を左右する主な要因は、ストリーム自体が占有するコンピュートリソースの量です。この場合、コンピュートリソースには、タスクマネージャーあたりの vCPU 数、パーティションあたりの RAM の GiB 数、ストリームのパーティション数が含まれます。これらのリソースはストリームのプロファイルで設定され、ストリームの実行期間中は維持されます。
- ストリームのリソースは、受信ストリームのピークスループットに対応できるように割り当てる必要があります。受信するメッセージの量が、コンピュートリソースで効率的に処理できる量を超えると、ストリームの処理が遅れます。
- ストリームが使用するリソースを変更するには、リソースプロファイルを変更してストリームを再起動する必要があります。
- アーカイブジョブのコンピュート使用量は、ストリームを流れるデータ量に応じて増加します。アーカイブジョブは、前回のアーカイブ以降のすべてのデータを読み込みます。データがストリーミングされていない場合、アーカイブジョブのコンピュート使用量はゼロになります。アーカイブジョブは、ストリームがアクティブな間、10分ごとに実行されます。
Foundry Streaming で使用量を管理する
特定のワークフローでストリーミングを選択すべき場合と、バッチを選択すべき場合を理解することが重要です。ストリーミングは、秒単位の低遅延と常時のコンピュートを必要とするワークフロー向けに設計されています。データを数分ごとに処理してもよい場合は、小規模なマイクロバッチジョブを検討してください。マイクロバッチジョブは、ストリームと同じ量のデータを送信できますが、コンピュート秒数のコストが低くなる一方で、データの遅延は大幅に増加します。
- ストリームのサイズは、実行ごとに使用する総コンピュート秒数に大きく影響します。ストリームには、期待される最大同時負荷を処理するのに十分なリソースを設定する必要があります。
- ピーク負荷に対応しつつ、リソースを過剰に割り当てないようにストリームのサイズを選択することが重要です。そのためには、各ジョブのサイズ(vCPU とメモリー)と、ストリームのタスクマネージャーの総数を慎重に設定する必要があります。
- ストリームは停止されるまで実行され続けます。ストリーミングコンピュートのソースを注意深く監視して、必要なときにのみストリームが実行されるようにしてください。
使用量を計算する
次の例では、10分間実行される仮想的なストリームのコンピュート使用量を計算する方法を示します。ただし、ほとんどの本番ストリームは継続的に実行されます。
ストリームのプロファイル
- ジョブマネージャーの vCPU 数: 0.5
- ジョブマネージャーの gib_ram: 1
- タスクマネージャーの vCPU 数: 0.5
- タスクマネージャーの gib_ram: 2g
- 並列度: 2
- gib_ram: 4
- ストリームの実行期間:10分(600秒)
- streaming_usage_rate: 0.5
計算
- ジョブマネージャーのコンピュート秒数 = max(vCPUs, gib_ram / 7.5 gib_ram) * streaming_usage_rate * 600s = max(0.5, 0.133) * 0.5 * 600s = 150コンピュート秒
- 換算すると、1秒あたり0.25コンピュート秒、または1時間あたり900コンピュート秒です
- タスクマネージャーのコンピュート秒数 = max(vCPUs, gib_ram / 7.5 gib_ram) * (parallelism + 1) * streaming_usage_rate * 600s = max(0.5, 0.267) * 3 * 0.5 * 600s = 450コンピュート秒
- 換算すると、1秒あたり0.75コンピュート秒、または1時間あたり2700コンピュート秒です
このストリームを10分間実行した場合の総コンピュート使用量は、ジョブマネージャーが150コンピュート秒、タスクマネージャーが450コンピュート秒です。Foundry のコンピュート使用量に影響する要因について、詳しくはこちらをご覧ください。