注: 以下の翻訳の正確性は検証されていません。AIPを利用して英語版の原文から機械的に翻訳されたものです。
HyperAuto V2 のアーキテクチャ
このページでは、HyperAuto V2 のアーキテクチャについて説明します。HyperAuto V1 のアーキテクチャについては、HyperAuto V1 の概要を参照してください。
HyperAuto V2 は、データ統合ワークフローの3つの主要コンポーネントであるデータ同期、ビルダーパイプライン、オントロジーのオーケストレーションと自動化を提供し、サポートされているソースからすぐに使える出力を自動生成します。
HyperAuto はデータソースのメタデータを活用し、ソースにリアルタイムでクエリを実行することで、同期の作成方法、適用する変換ロジック、適切なオントロジーの設計方法を判断します。
HyperAuto パイプラインとは、同期からオブジェクトまで、単一の HyperAuto インスタンスが管理するすべてのリソースを指します。各パイプラインは、ユーザーが指定したソーステーブルのリストを入力として受け取り、必要に応じて Foundry に同期し、価値があり、すぐに使える出力データセットと、任意でオントロジーオブジェクトに変換します。ユーザーは個々のニーズに合わせて、ソースごとに複数の HyperAuto パイプラインを作成できます。
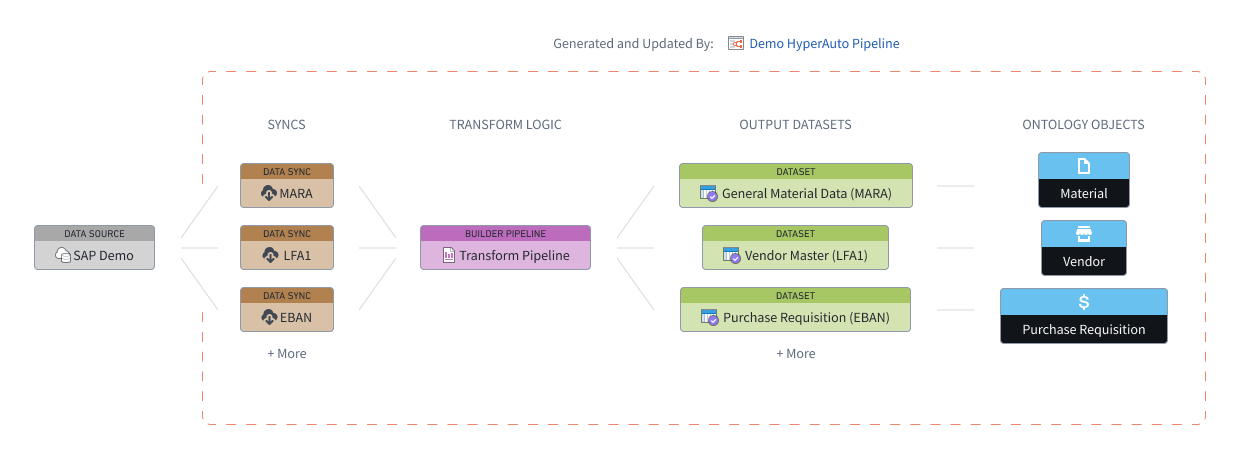
データ同期
HyperAuto は、ソースへの直接接続がない場合に静的ファイルを使用することもサポートしています。その場合、このセクションは適用されません。詳しくは、フォルダーベースの SAP ドキュメントを参照してください。
HyperAuto では、ソース上の閲覧可能なすべてのテーブルにアクセスできます。既存のデータ同期にマッピングされていないソーステーブルをユーザーが選択すると、新しいデータ同期が自動生成されます。
選択したソーステーブルに対して1個以上のデータ同期がすでに存在する場合、デフォルトでは最新の同期が選択されます。この選択は、入力設定ページで入力テーブルを設定ボタンにカーソルを合わせると変更できます。そこから、使用する別の既存の同期を選択するか、新しい同期の作成を選択します。
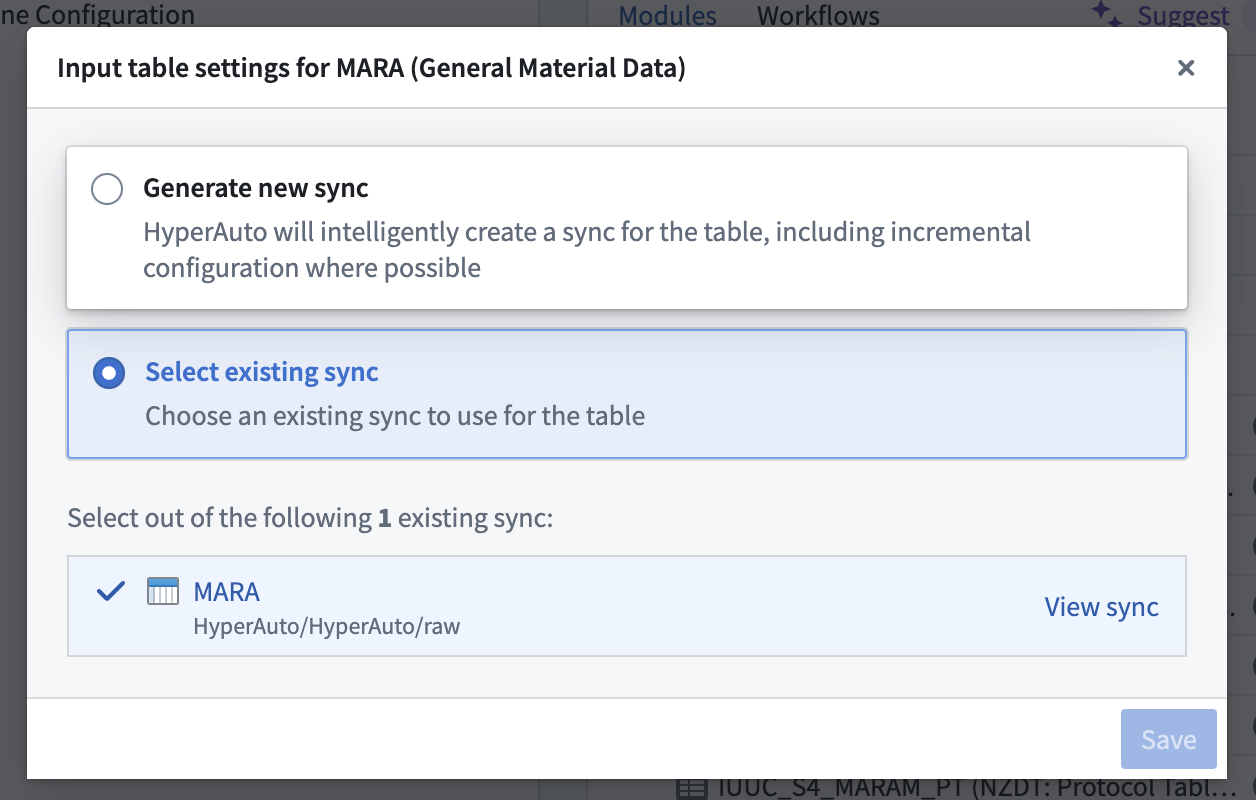
HyperAuto が新しいデータ同期を作成した場合、データの規模によっては生成に大幅に長い時間がかかることがあります。これは、ビルダーパイプラインの生成など、HyperAuto の残りの処理を行う前に、データ同期の初回実行が必要なためです。
データ変換(Pipeline Builder)
HyperAuto パイプライン内のデータ変換では、扱いにくいソースデータを、分析やアプリケーション開発ですぐに使える、クレンジングおよびエンリッチメント済みの出力に変換できます。
HyperAuto パイプラインは、Foundry 内での主要なデータ変換方法である、自動生成されたビルダーパイプラインによって実行されます。
HyperAuto は、ソースの種類とユーザーの設定に基づいて、推奨する変換ロジックを動的に生成します。ユーザーは、HyperAuto パイプラインの概要ページでパイプラインを表示を選択すると、このビルダーパイプラインを表示できます。このパイプラインの編集は、提案を通じて HyperAuto の設定を変更することで行います。
HyperAuto で利用可能な変換機能の種類は次のとおりです。
- クレンジング: ソースシステムは、データ型の誤り、null 値や空の値の不適切な処理、文字列値に含まれる不要な空白など、データの「クリーンさ」に関する一般的な問題を含むデータをエクスポートすることがよくあります。HyperAuto は、これらを含むさまざまな問題を修正するために、推奨する変換オプションを提供します。
- 名前変更: HyperAuto は、ソースのメタデータを使用して、出力テーブルと列の名前を、説明的で意味がわかりやすい名前に変更できます。人が読んでも理解しにくいことが多いスキーマをそのまま使う必要はありません。
- 結合: ソースシステムでは、たとえば「正規化された」データモデルに従う場合などに、関連情報(メタデータなど)を別のテーブルに格納することがよくあります。HyperAuto はソースのデータモデルに対する理解を活用してこれらのテーブルを結合し、分析を容易にし、オントロジーの強固な基盤となる、非正規化された豊富な出力データセットを提供します。
- フィルター処理: HyperAuto は、たとえば変更データキャプチャの入力から重複を削除するために、不要な行(重複など)を自動的に除外できます。
バッチとリアルタイムのストリーミングの両方のパイプラインモードがサポートされています。詳しくは、設定オプションを参照してください。

オントロジー
HyperAuto は、ソースのデータモデルを使用して、生成された出力データセットに基づくオントロジーを動的に生成できます。これには、オブジェクト間の意味的なリンクの定義も含まれます。
この設定を有効にすると、手動操作を行うことなく、新しい(サポートされている)ソースから、すべてが定義されたオントロジーをわずか数分で作成できます。
この機能に関心がある場合は、Palantir の担当者にお問い合わせください。
リソース管理
HyperAuto パイプラインは、作成したすべてのリソースを完全に制御するように設計されており、ユーザーはパフォーマンスの向上やバグ修正を含め、システムの改善やアップグレードによるメリットを継続的に享受できます。また、これらのパイプラインの設計により、新しい変換ステップや入力をパイプラインに追加するなど、すでに生成されたリソースの調整も容易に行えます。
基盤となるリソース(同期やビルダーパイプラインなど)への編集は、変更の競合を避けるため、必ず HyperAuto アプリケーションを通じて管理する必要があります。
必要に応じて HyperAuto パイプラインリソースを削除すると、対応するビルダーパイプラインに対する所有権が解除され、通常どおりビルダーパイプラインを直接編集できるようになります。