注: 以下の翻訳の正確性は検証されていません。AIPを利用して英語版の原文から機械的に翻訳されたものです。
HyperAuto V1 [サンセット]
HyperAuto V1 は開発ライフサイクルのサンセット段階にあり、将来廃止される予定です。引き続き完全なサポートを利用できます。新しい V1 パイプラインの作成は推奨されません。移行ドキュメントの説明に従って、HyperAuto V1 から V2 に移行してください。
HyperAuto V1(SDDI または Bellhop とも呼ばれます)は、Palantir のソースから価値創出までを自動化するスイートの最初のバージョンです。HyperAuto V2 は SAP 向けにリリースされており、このデータソースには V2 を強く推奨しますが、HyperAuto V1 も現在、次のようなソースの種類で引き続きサポートされています。
- Salesforce
- Oracle NetSuite
- SAP(V1 は推奨されません。代わりに V2 を使用してください)
HyperAuto V1 の詳細なドキュメントはプラットフォーム内で利用できます。そこでソフトウェア定義のデータ統合を表示すると、利用可能な設定オプションを確認できます。
アーキテクチャ
HyperAuto V1 は、生データのソースからオントロジーまで、最小限の労力でデータを統合できるように設計された3つのコンポーネントで構成されています。
- コネクターは、ソースシステムとの間で大規模なデータを安全かつ最適化された方法で転送できるようにします。
- ソース探索では、ガイドに従って迅速にデータを見つけることができ、「ショッピングカート」のような操作でデータ同期を一括で迅速に作成、設定できます。
- パイプラインの自動生成は、自動生成されたデータパイプラインを使用して、生データを整備された Foundry データセットとオントロジー内のオブジェクトタイプに変換します。

パイプラインの生成
パイプラインの自動生成は、一般的なソースシステムを統合するための、すぐに使えるデータパイプラインを作成します。パイプラインは、オントロジーやワークフローで使用できるようにデータを準備します。パイプライン生成には各ソースシステムに関する知識が埋め込まれているため、この機能を使用すると効率が向上し、基盤となる各ソースシステムの複雑な仕組みを完全に理解する必要がなくなります。
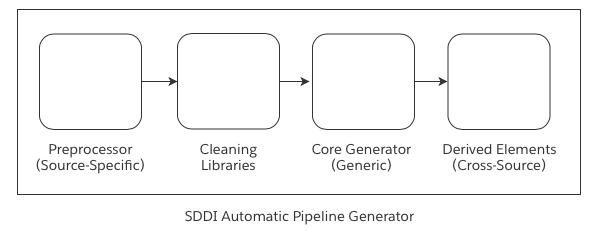
生成されたパイプラインには、4つの主要なステップが含まれます。
- ソース固有の前処理は、事前定義されたスキーマを持つメタデータのデータセットを生成します。このメタデータには、ソースシステムのデータを理解するために必要な情報が含まれます。
- クリーニングライブラリは、標準化されたデータクリーニングのステップをすべてのデータセットに適用し、システムに流入するすべてのデータでベストプラクティスが遵守されるようにします。
- コア生成は、データのエンリッチメント、列名の変更、重複排除、データのユニオンを実行し、オントロジーでの分析、レポート作成、ワークフローに使用できるデータを生成します。
- 派生要素は、高度なワークフローに対する事前定義されたサポートを提供します。これには、結合テーブル、時系列データセット、および豊富な派生情報を提供し、オントロジーにも取り込まれるエンリッチメント済みの列の生成が含まれます。

オントロジーの作成
パイプラインが自動生成された後、HyperAuto V1 はさらにオントロジーの自動生成もサポートします。これによりデータ統合プロセスが完了し、Foundry の幅広いオントロジー対応アプリケーションを活用して、データの検索、分析、さらにはデータを基盤としたアプリケーションの構築もすぐに開始できます。
