注: 以下の翻訳の正確性は検証されていません。AIPを利用して英語版の原文から機械的に翻訳されたものです。
詳細情報
このページでは、データセットに対するクエリをより最適化するために、データセットのプロジェクションが実際にどのように機能するかを詳しく説明します。プロジェクションの概要については、こちらのページを参照してください。
内部的には、プロジェクションは特定のアクセスパターンに最適化されたデータセットのコピーです。Foundry は、データセットのプロジェクションを子データセットとして保存します。これらは「プロジェクション」データセットと呼ばれます。親データセットは「正規」データセットまたは「プロジェクション対象」データセットと呼ばれます。
- プロジェクションには、特定の列が含まれます。
- プロジェクションで対応できるのは、それらの列(またはその一部)の読み取りのみです。
ビルドによって、プロジェクションはメインデータセットの最新のデータに合わせて更新されます。プロジェクションが最新でなくても、引き続き使用されます。ただし、効果があまり得られない可能性があります。
プロジェクション対象データセットが新しい SNAPSHOT トランザクションを受け取ると、下流のプロジェクションはすべて完全に古い状態となり、プロジェクションが再ビルドされるまで効果はありません。プロジェクション対象データセットが APPEND トランザクションを受け取ると、下流のプロジェクションは新しいトランザクションに対して一部のみが古い状態になります。Foundry のクエリは、新しいデータを反映した結果を生成しながら、可能であればプロジェクションの効果を活用するように書き換えられます。
- プロジェクションのビルドはブランチごとに設定されます。プロジェクションは定期的にコンパクションされ、小さいパーティションがより大きいパーティションにまとめられます。
- プロジェクションを追加しても、データセットの読み取り結果が変わることはありません。
低レベルでは、プロジェクションは次のいずれかです。
- 全体がほぼ並べ替えられたデータセット。
- ハッシュでバケット分割され、ローカルに並べ替えられたデータセット。バケット分割に使用する列と並べ替えに使用する列は異なる場合があります。
プロジェクションデータセット
プロジェクションデータセットは、Foundry データセットとして保存されます。このデータセットはリソースとしては表示されませんが、プロジェクションタブのリンクからアクセスできます。
- プロジェクションのビルドがアクティブな各ブランチには、プロジェクションデータセット内に対応するブランチがあります。
- データセットを削除すると、そのデータセットのすべてのプロジェクションが削除されます。
- Noho サービスはプロジェクションの管理に使用され、プロジェクションを設定する際にデータセットのスキーマで参照されます。
プロジェクションのビルド
プロジェクションを最新の状態に保持するため、通常の Foundry のビルドシステムを通じて非同期にビルドされます。これにより、ユーザーはビルド直後にプロジェクション対象データセットを一貫した状態で読み取れますが、プロジェクションデータセットが古い状態にならないよう、定期的にビルドする必要があります。
コンピューティングリソースの割り当てとコスト管理を柔軟に行えるようにするため、Foundry はこれらのビルドを自動的には作成しません。ビルドを設定するには、プロジェクションタブのスケジューラーウィジェットを使用します。
適切なビルド頻度について、すべてに当てはまるルールはありません。主な判断基準は、データセットのプロジェクションが作成されていない部分に対するクエリを、性能目標の範囲内で実行できる必要があるということです。たとえば、パイプラインが1時間あたり 10 GB を書き込み、フィルターを使用した読み取りで性能目標を満たすにはスキャンするデータ量を 100 GB 以下にする必要があると判断した場合、少なくとも10時間ごとにプロジェクションがビルドされるようにしてください。
Spark プロファイル
プロジェクションは自動スケーリングの仕組みを使用して、プロジェクションのビルドに適したエグゼキューター数を決定します。プロジェクションのビルドに失敗するか、時間がかかりすぎる場合を除き、Spark プロファイルを手動で調整する必要はありません。
コスト
Foundry は、プロジェクションに関連するすべてのコスト(たとえば、ストレージやコンピューティング)を、 メインデータセットのプロジェクトに計上します。
プロジェクションのコンパクション
コンパクションは、プロジェクションに対して行われる主要なメンテナンス操作です。これは、並べ替え済みの小さいファイルを大量にまとめて、並べ替え済みのより大きいファイルにする処理を指します。コンパクションは、プロジェクションのビルド処理の一部として、プロジェクションに対して自動的に行われます。
コンパクションによって、読み取り性能はメインデータセットの入力トランザクション数に依存しなくなります。これにより、プロジェクションは、インクリメンタルに頻繁に書き込まれるデータセットやストリーミングデータセットの読み取りを高速化できます。プロジェクションのビルドは、通常よりも時間がかかることがあります。これは通常、コンパクションによるものです。
プロジェクションのクエリプランニング
クエリに対応できるプロジェクションが利用可能な場合、メインデータセットの書き込み方法がそのクエリにより適していても、常にメインデータセットより先にプロジェクションが選択されます。これにより、クエリプランニングの動作が大幅に単純化されます。
プロジェクションを選択する
以下のクエリでは、クエリプランニング時に各プロジェクションに次の優先順位が割り当てられます。
- 列に対するフィルター: より多くの列で並べ替えられたプロジェクションが優先され、全体が並べ替えられたプロジェクションは、
ローカルに並べ替えられたプロジェクションよりも優先されます。たとえば、フィルターが
x = 1 AND y = 2の場合、プロジェクションは 次の優先順位で選択されます。- 列
xとyで全体が並べ替えられているもの - 列
xとyでローカルに並べ替えられているもの(バケット分割に使用する列は任意) - 列
xで全体が並べ替えられているもの - 列
xでローカルに並べ替えられているもの(バケット分割に使用する列は任意)
- 列
- 列での結合: 結合列と完全に一致する列の組み合わせでバケット分割されたプロジェクションが優先されます。
- 結合とフィルター: たとえば、クエリが列
Fで絞り込み、列Jで結合する場合、プロジェクションは 次の優先順位で選択されます。- J でバケット分割され、列
Fでローカルに並べ替えられたプロジェクション - 列
Fで全体が並べ替えられたプロジェクション - 列
Fでローカルに並べ替えられたプロジェクション(列J以外の任意の列でバケット分割) - 列
Jでバケット分割されたプロジェクション(列F以外でローカルに並べ替え)
- J でバケット分割され、列
これらの優先順位は、通常、フィルターによって十分に絞り込めるため、結合よりもフィルターに対して最適化したほうがよいという考え方を反映しています。ただし、必ずしもそうとは限りません。
保持
プロジェクションは、自動メンテナンスの一環として、コンパクションされたファイルを定期的にビルドします。コンパクションは古いデータファイルをより大きいファイルに置き換えますが、置き換えられたファイルは古いトランザクションに残る場合があります。これらのトランザクションを削除する保持ポリシーがない場合、プロジェクションのビルドが実行されるにつれて、置き換えられたファイルがディスク容量を消費し続ける可能性があります。
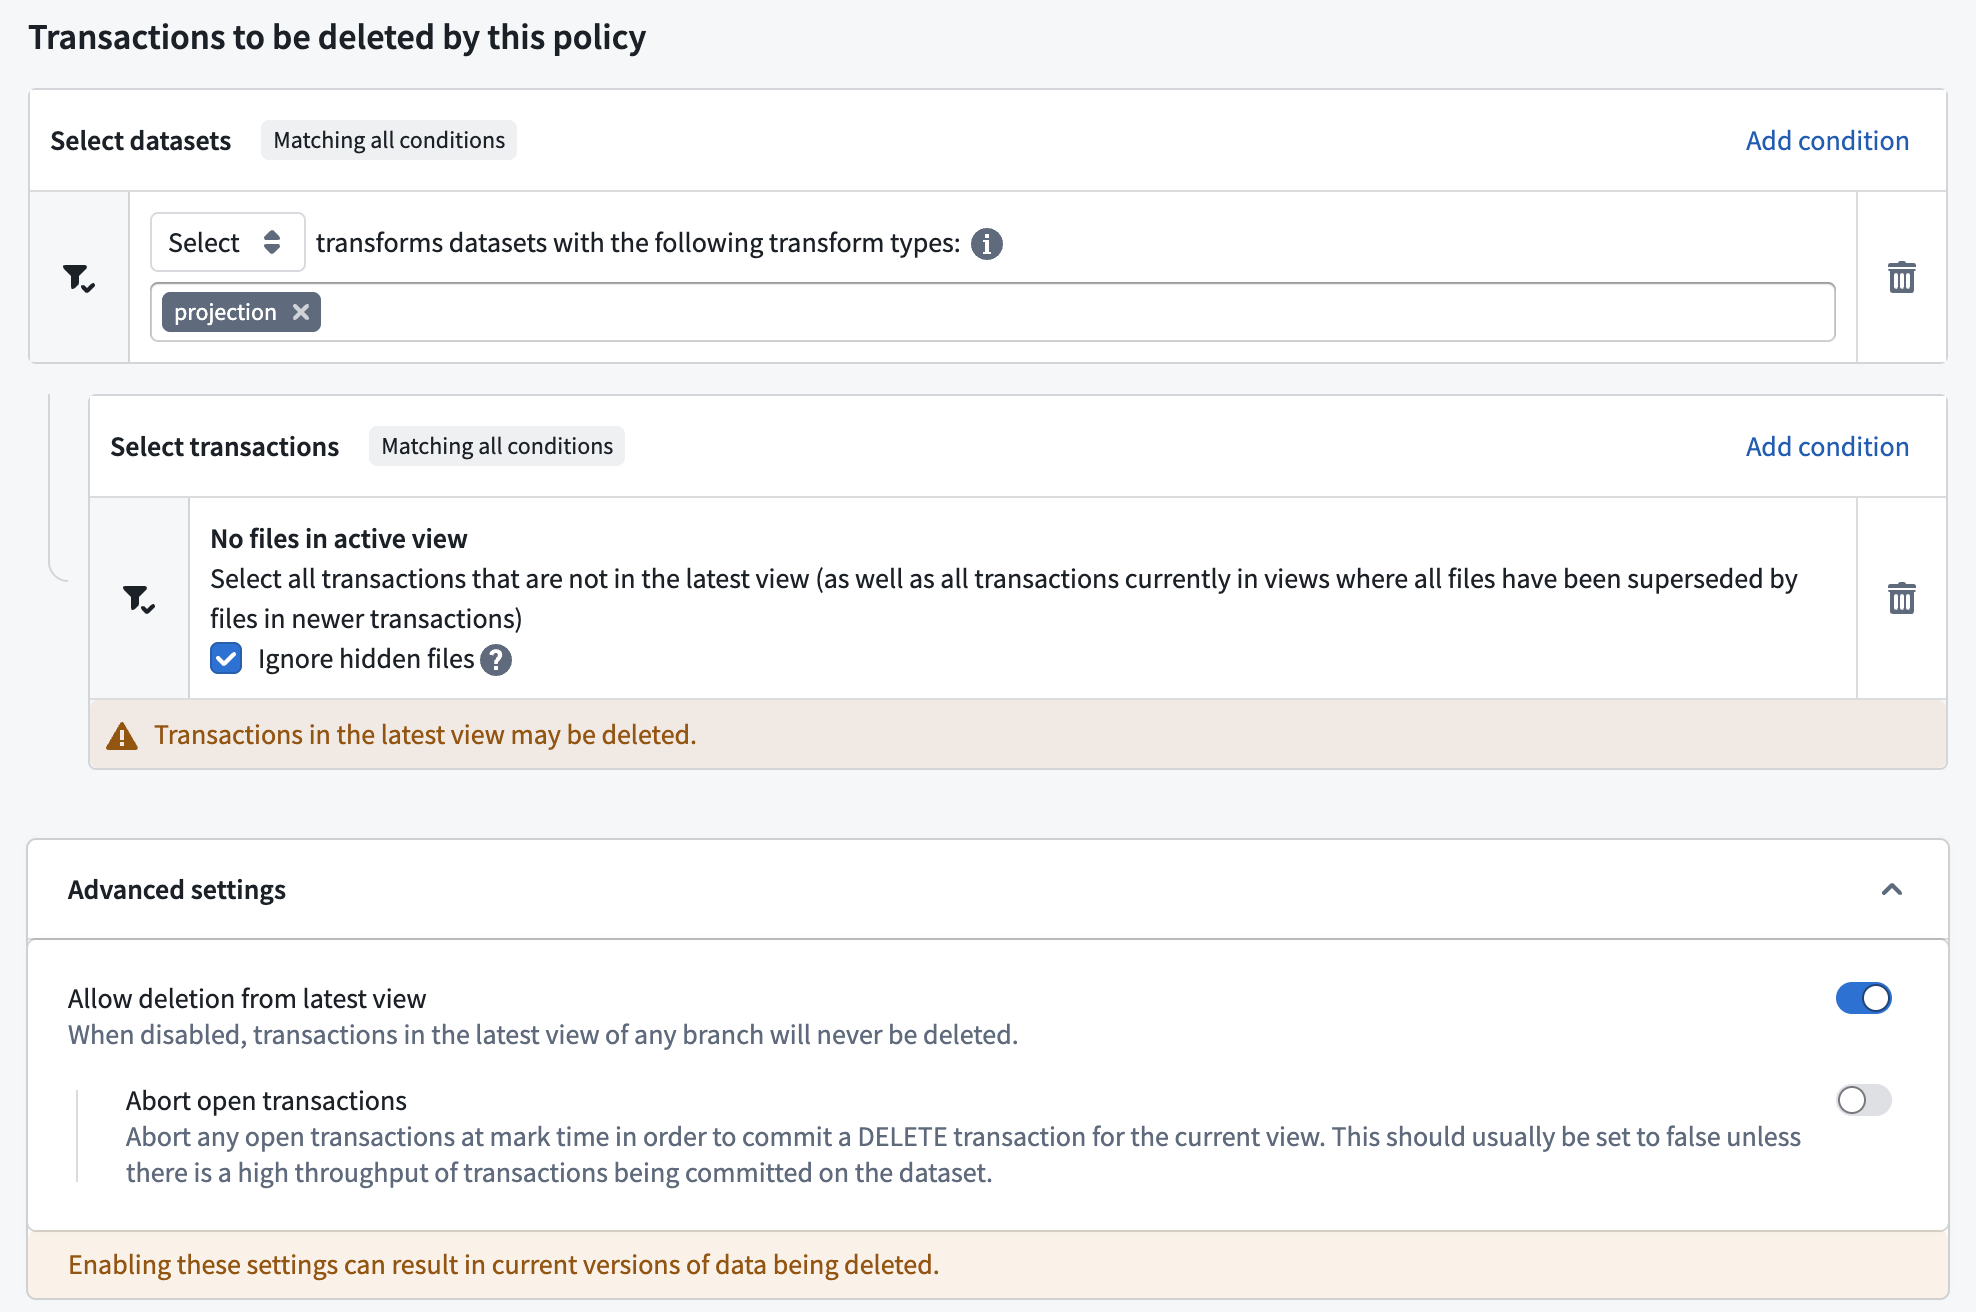
このストレージを回収するには、保持ポリシーアプリケーションで、該当するスペースのカスタム保持ポリシーを設定します。
- 選択モードでトランスフォームデータセットセレクターを追加し、トランスフォームの種類を
projectionに設定します。これにより、親データセットではなくプロジェクションデータセットが対象になります。 - アクティブなビューにファイルがない トランザクションセレクターを追加します。
- 最新のビューからの削除を許可 を有効にすると、置き換えられたトランザクションが最新のビューに含まれていても削除できるようになります。
- 非表示のファイルを無視 を有効にすると、ビルドログなどの非表示のファイルによって、データファイルが置き換えられたトランザクションの削除が妨げられなくなります。