注: 以下の翻訳の正確性は検証されていません。AIPを利用して英語版の原文から機械的に翻訳されたものです。
データ加工
Pipeline Builder は、Foundry でデータを加工するための、柔軟で強力かつ使いやすいインターフェースを提供します。既存のツール(たとえば Spark や SQL)でデータ加工を記述することは、コードを書かないユーザーにとっても、経験豊富なソフトウェア開発者にとっても難しく、エラーが発生しやすい作業です。また、既存のツールは特定の実行エンジンと結びついていることが多く、データ加工を表現するためにコードライブラリを使用する必要があります。
Pipeline Builder は、データ加工を記述するための汎用モデルを使用します。このバックエンドは、データ加工を記述するツールと、そのデータ加工の実行との間の中間層です。
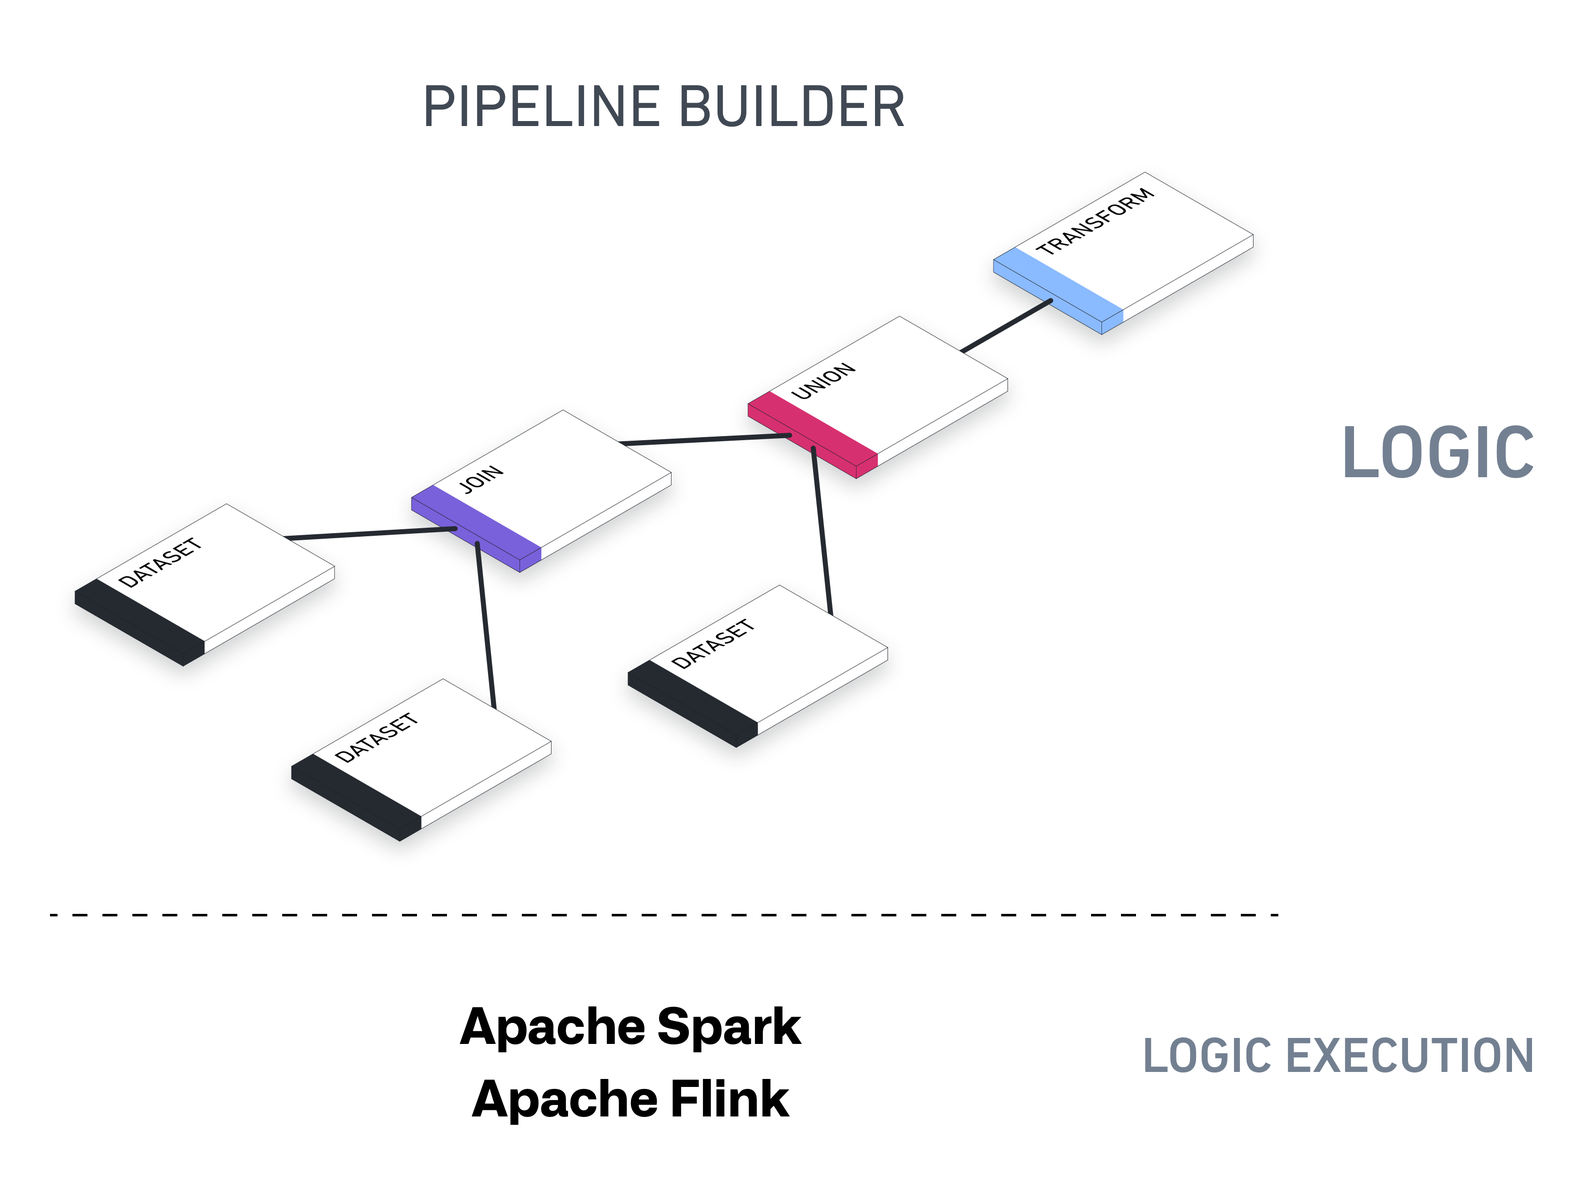
Pipeline Builder の基盤アーキテクチャは、データセット、オントロジーのオブジェクト、ストリーム、時系列、外部システムへのエクスポートなど、あらゆる種類の出力をサポートするように設計されています。データセット、オブジェクトタイプ、リンクタイプのバッチパイプラインや、ストリーミングデータセットに対応するストリーミングパイプラインを実行できます。
Pipeline Builder でデータ加工を使用する
Pipeline Builder では、式とデータ加工という2種類のデータ加工を使用できます。式はテーブルの列を入力として受け取り、1列を出力します(たとえば、文字列を分割)。一方、データ加工はテーブル全体を入力として受け取り、テーブル全体を返します(たとえば、ピボットやフィルター)。
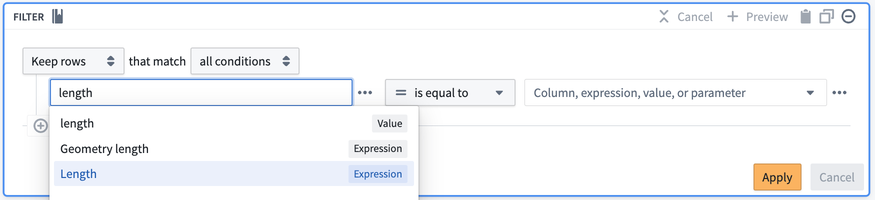
式とデータ加工は、同じ設定インターフェースにまとめられています。たとえば、型変換や文字列を連結などの式と並んで、列を削除のデータ加工が表示されます。これにより、同じパスで式とデータ加工を併用したり、1つの設定フォーム内でデータ加工に式を組み込んだりできます。下の例では、フィルターのデータ加工に長さの式を挿入しています。
データを構造化するその他のデータ加工である結合、ユニオン、分割には、それぞれ専用の設定ペインがあり、Pipeline Builder のインターフェースでは固有のアイコンで示されます。

説明を簡潔にするため、通常はあらゆる種類のデータ加工をまとめて「データ加工」と呼びます。
結合
結合は、一致する列が1つ以上ある2個のデータセットを組み合わせます。設定する結合の種類に応じて、結合の出力では一致する行を組み合わせ、一致しない行を除外できます。
ユニオン
ユニオンは、2個のデータセットを組み合わせ、すべての行を含めます。
ユニオンのデータ加工では、すべての入力が同じスキーマを持つ必要があります。入力スキーマがすべて一致していない場合、ユニオンは不足している列の一覧を含むエラーメッセージを表示します。
分割
分割は、条件に基づいて1個の入力を2個の出力に分けます。条件を満たす行は真の出力に、それ以外のすべての行は偽の出力に送られます。
分割のデータ加工は、標準のバッチパイプライン(Spark を基盤とするもの)および高速パイプライン(DataFusion を基盤とするもの)でのみサポートされています。ストリーミングパイプラインには、分割の選択肢は表示されません。
分割のデータ加工について詳しくはこちら。
null の処理
フィルター、結合、Case のデータ加工で条件を扱うときは、null 値がどのように評価されるかを理解することが重要です。Pipeline Builder の条件における null の処理について詳しくはこちら。
ユーザー定義関数
既存のデータ加工の選択肢ではデータを操作できない場合や、パイプライン間で再利用したい複雑なロジックがある場合は、ユーザー定義関数(UDF)を作成できます。ユーザー定義関数を使用すると、Pipeline Builder でカスタムコードを実行でき、そのコードのバージョン管理やアップグレードもできます。
注記: 最適なエクスペリエンスのために、Python 関数の使用を推奨します。特定の Java ライブラリへのアクセスが必要な場合は、Java UDF も利用可能です。
2個の異なるストリームからのイベントを処理する必要があるストリーミングパイプラインでは、キー付き CoProcess UDF を使用して、両方の入力にわたって状態を維持し、どちらのストリームからも独立して出力行を発行する、カスタムのステートフルなロジックを定義できます。
ユーザー定義関数は、必要な場合にのみ使用してください。可能な場合は、Pipeline Builder 内の最適化されたデータ加工ボードの使用を推奨します。
学習済みモデル
バッチパイプラインまたはストリーミングパイプライン内で機械学習モデルの推論を直接実行する必要がある場合は、学習済みモデルノードを使用できます。これにより、Foundry 内外で学習させたモデルをインポートし、コードを書かずにデータに対する予測を生成できます。モデルは、分離されたサイドカープロセスとして実行されます。
学習済みモデルノードは、テーブル形式の入力と出力をそれぞれ1個持つモデルを使用した、バッチ(Spark)およびストリーミング(Flink)の実行モードのみをサポートします。
サブグラフ
サブグラフは開発のベータ段階にあり、お使いのエンロールメントでは利用できない場合があります。
サブグラフは、1個以上のデータ加工を、パイプライン全体で適用できる再利用可能なブロックにまとめます。サブグラフノードは、繰り返し使用されるノードの連鎖を置き換えることができます。
サブグラフの作成と使用について詳しくはこちら。
次のステップ
パイプラインのワークフローにデータ加工を追加する方法を学びます。