注: 以下の翻訳の正確性は検証されていません。AIPを利用して英語版の原文から機械的に翻訳されたものです。
高度なセットアップ
時系列のセットアップページで説明されているように、Pipeline Builder を使って時系列パイプラインをセットアップすることを推奨します。これにより、以下で説明するトランスフォームの最適化が自動的に適用されます。
高度なセットアップの設定を進める前に、Palantir の担当者にお問い合わせください。
トランスフォームの低レベルの制御や、Pipeline Builder ではまだ提供されていない高度な機能が必要な場合に向けて、このページでは、データ変換に Code Repositories を使って時系列パイプラインを手動でセットアップする方法を説明します。
Code Repositories で時系列をセットアップするには、以下を完了する必要があります。
1. 時系列の入力データを作成して最適化する
時系列同期は、データセットまたはストリームを基に構築できます。この選択は、多くの場合、スループットと低遅延に関する考慮事項によって決まります。より詳しい分析については、ストリーミング処理とバッチ処理の比較を確認してください。
どちらの場合も、パイプラインを手動でセットアップする際は、形式を整えた時系列データを含む時系列データセットまたはストリームを明示的に生成する必要があります。これは時系列同期の作成に必要です。時系列同期で値をマッピングできるように、データセットまたはストリームには、用語集で指定されている Series ID、Value、Timestamp 列が含まれている必要があります。
データセットの時系列
時系列データセットは通常、ライブデータがある場合にインクリメンタル(差分処理)でビルドするように設定されます。インクリメンタルビルドにより、コンピューティングコストを削減し、生データが取り込まれてから最新のデータを読み取れるようになるまでの時間を大幅に短縮して、低遅延を実現できます。詳しくは、時系列に関する FAQ で説明しています。
同じシリーズIDのすべての値は、同じデータセットに含める必要があります。値はシリーズIDを使って取得されるため、1つの時系列データセットに複数のシリーズIDのすべての値を含めることができます。例:
+------------------------+---------------------+---------+
| series_id              | timestamp           | value   |
+------------------------+---------------------+---------+
| Machine123_temperature | 01/01/2023 12:00:00 | 100     |
| Machine123_temperature | 01/01/2023 12:01:00 | 99      |
| Machine123_temperature | 01/01/2023 12:02:00 | 101     |
| Machine463_temperature | 01/01/2023 12:00:00 | 105     |
| Machine123_pressure    | 01/01/2023 12:00:00 | 3       |
| ...                    | ...                 | ...     |
+------------------------+---------------------+---------+
コードで時系列データセットを生成する場合は、書き込む前に以下のようにデータセットの形式を整えます。
Python
Copied!1 2 3 4 5 6 7 8 9 10 11 12 13 14 15from transforms.api import transform, Input, Output @transform( output_dataset=Output("/path/to/output/dataset"), input_dataset=Input("/path/to/input/dataset") ) def my_compute_function(output_dataset, input_dataset): output_dataframe = ( input_dataset .dataframe() .repartitionByRange('seriesId') .sortWithinPartitions('seriesId', 'timestamp') ) output_dataset.write_dataframe(output_dataframe, output_format='soho')
Java
Copied!1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31package myproject.datasets; import com.palantir.transforms.lang.java.api.Compute; import com.palantir.transforms.lang.java.api.FoundryInput; import com.palantir.transforms.lang.java.api.FoundryOutput; import com.palantir.transforms.lang.java.api.Input; import com.palantir.transforms.lang.java.api.Output; import com.palantir.foundry.spark.api.DatasetFormatSettings; import org.apache.spark.sql.Dataset; import org.apache.spark.sql.Row; import java.util.Collections; public final class TimeSeriesWriter { @Compute public void writePartitioned( @Input("/path/to/input/dataset") FoundryInput inputDataset, @Output("/path/to/output/dataset") FoundryOutput outputDataset) { Dataset<Row> inputDataframe = inputDataset.asDataFrame().read(); Dataset<Row> outputDataframe = inputDataframe .repartitionByRange(inputDataframe.col("seriesId")) .sortWithinPartitions("seriesId", "timestamp"); outputDataset.getDataFrameWriter(outputDataframe) .setFormatSettings(DatasetFormatSettings.builder() .format("soho") .build()) .write(); } }
このパーティション再分割と並べ替えを実行すると、時系列として高いパフォーマンスで使用できるようにデータセットが最適化されます。また、まだプロジェクションが作成されていない場合に新しいデータが時系列データベースにインデックス化されるように、少なくともデータセットを(上記のように)Soho 形式にする必要があります。さらに、以下の指針に基づいて、repartitionByRange() ↗ で書き込むパーティション数を、パイプラインに適した数に設定する必要があります。
- 書き込むパーティション数はできるだけ少なくします。
- パーティションは 128 MB より大きくする必要があります。
- 一般に、パーティションの行数は50億行より少なくする必要があります。
書き込めるパーティション数の下限は、各パーティションがエグゼキューターに収まる程度に小さく、かつ、求めるパイプラインの低遅延を実現するためにジョブを十分に並列化できるだけのパーティション数を確保することによって決まります。書き込むパーティション数を増やすと、パーティションが小さくなり、ジョブは高速になりますが、大きなパーティションほど最適ではなくなります。
時系列同期のビュー最適化
大量のデータを同期する場合は、1時間ごと、1日ごと、1週間ごとなどの区切られた時間間隔でパーティション分割し、データを小さなデータセットに分割することを推奨します。その後、これらのパーティションを、時系列に同期できる統合ビューにまとめることができます。この方法により、下流の FoundryTS ライブラリや Quiver で時系列データを要求する際に良好なパフォーマンスを確保しやすくなります。小さなデータセットは、最終的に統合ビューを通じて1つの時系列同期にまとめられます。
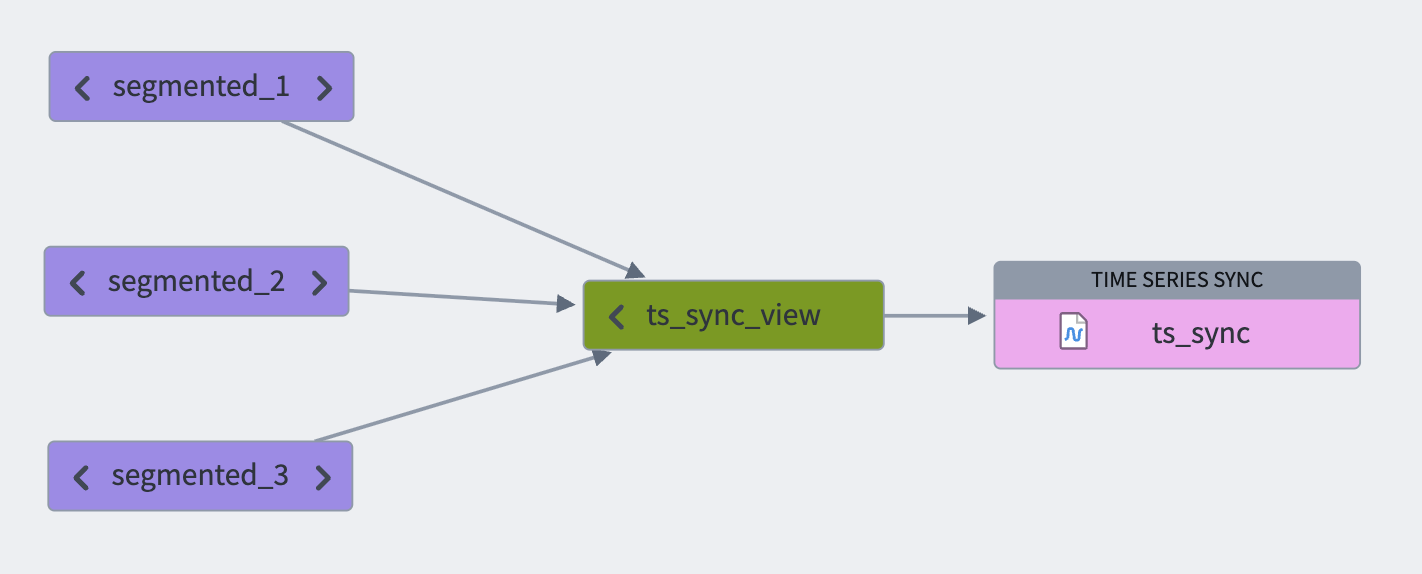
ビューには分割されたすべての元データセットが含まれるため、シリーズIDが元データセット間に分散していたり、時間帯ごとに異なる元データセットに格納されていたりしても問題ありません。
ビュー最適化の使用は、時系列同期の詳細設定で設定できます。
ビュー最適化を設定するには、以下の手順に沿って進めます。
- 元となるシリーズデータセットを含むビューをセットアップします。
- セットアップする時系列同期の入力として、そのビューを使用します。
- 時系列セットアップダイアログの詳細設定セクションで、ビューデータセット入力のインデックス付けを行うオプションを切り替えます。
ストリーミング時系列
ストリーミング時系列のパフォーマンスを最適化するために、以下の手順を実施することを推奨します。
- シリーズID列を使ってストリームのキーを設定します。これにより、時系列データをインデックス化する際に、プラットフォームが読み取るパーティション数を最小限にできます。ストリーミングキーの詳細については、ストリーミングキーのドキュメントを参照してください。
- パーティション数を多めに設定します。より高いスループットが必要なストリーミング時系列同期では、少なくとも3個のパーティションを設定することを推奨します。
ストリームのキーはシリーズID列のみで設定し、ほかの列を使わないようにしてください。これにより、時系列のインデックス化に最適な順序保証が確保されます。
ストリーミングパイプライン
ストリーミングパイプラインを使ってストリーミング時系列同期をセットアップすることを推奨します。パイプラインの出力を時系列同期にすることで、セットアップできます。
Series ID列を使ってストリームのキーを設定する:Series ID列_のみ_を使って、Key by トランスフォームを作成します。- パーティション数を設定する: ビルド設定 > 詳細な設定 > 出力パーティション数で、ストリーミングプロファイルをカスタマイズします。

ストリーミング同期
ストリーミング時系列の入力を設定するもう1つの方法は、ストリーミング同期をセットアップすることです。
Series ID列を使ってストリームのキーを設定する: 設定 > キーで、Series ID列を選択します。- パーティション数を設定する: スループットで、非常に高いを選択し、スループット要件に基づいて値を選択します。

ストリームにすでにレコードが取り込まれている場合、キーの設定やパーティション分割を変更するには、ストリームをリセットする必要があります。
2. 時系列同期を設定する
セットアップアシスタントに沿って進めている場合は、Builder に移動を選択します。

詳細については、Time Series Catalog を使用して時系列同期を作成するドキュメントを参照してください。
時系列同期を作成したら、Ontology Manager に戻り、この時系列同期を時系列プロパティのデータソースとして追加します。同期にすべての系列IDが含まれている場合は、新しい同期を作成する代わりに、新しい時系列プロパティに同じ同期を選択できます。
変更を保存するには、Ontology Manager で必ず保存を選択してください。新しいオブジェクトタイプを作成し、初めて変更を保存する場合は、時系列プロパティ(TSP)を分析できるようになるまで、初回のインデックス化が完了するのを待つ必要があります。インデックスのステータスを確認するには、Ontology Manager でオブジェクトタイプのデータソースタブに移動します。
新しく設定した時系列データを分析する方法について詳しくはこちら
3. 時系列オブジェクトタイプの元データセットを作成する
時系列オブジェクトタイプの元データセットは、任意の方法で生成できます。用語集に記載されているスキーマに準拠する必要があります。
時系列オブジェクトタイプの元データセットを自動的に生成するには、時系列データセットと同じトランスフォーム内で、系列IDの重複を除いた集合を取得し、そこからメタデータを抽出したり、そこにメタデータをマッピングしたりすることで生成できます。インクリメンタル(差分処理)パイプラインでは、マージと追加パターンを使用して実現できます。
4. 時系列オブジェクトタイプを設定する
標準の手順に沿って、時系列オブジェクトタイプの元データセットに基づくオブジェクトタイプを作成します。データセットプレビューですべてのアクション > オブジェクトタイプを作成するを選択して、データセットから直接オブジェクトタイプを生成することもできます。オブジェクトタイプを作成するときに、どのプロパティを時系列プロパティにするかを指定して、時系列用に設定します。