注: 以下の翻訳の正確性は検証されていません。AIPを利用して英語版の原文から機械的に翻訳されたものです。
パイプラインのコードをエクスポート
パイプラインをコードとしてエクスポートする機能は、デフォルトのバッチ(Spark)パイプラインでのみサポートされています。高速パイプラインとストリーミングパイプラインはこの機能をサポートしておらず、これらの種類のパイプラインでは、設定メニューにエクスポートのオプションが表示されません。
Pipeline Builder でパイプラインを作成する際に、パイプラインのコードを既存の Java トランスフォームリポジトリにエクスポートできます。このエクスポート機能は、特定の Java ライブラリにアクセスする必要がある場合に便利です。
エクスポート時には、パイプラインが Java トランスフォームのコードに変換され、エクスポート先のリポジトリにプッシュされます。この処理では、次の点に留意してください。
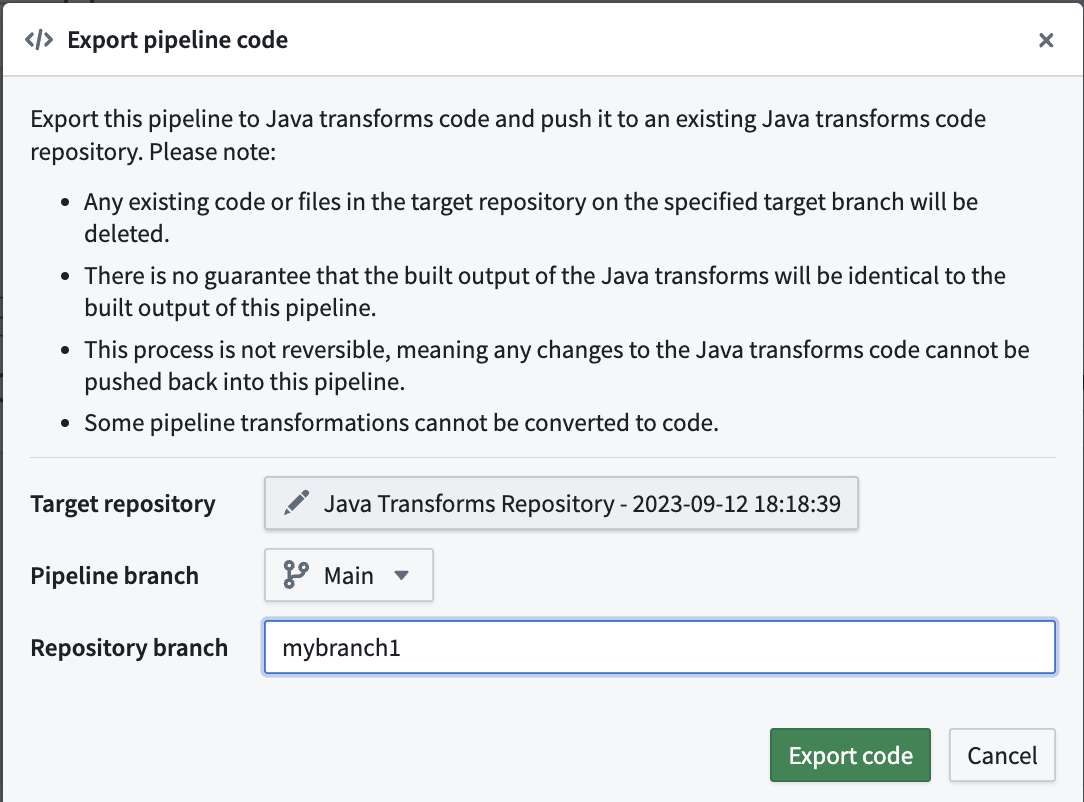
- エクスポート先のリポジトリの指定したブランチにある既存のコードやファイルはすべて削除されます。
- Java トランスフォームのコードによる新しい出力は、Pipeline Builder パイプラインの出力と必ずしも同一になるとは限りません。詳細については、Pipeline Builder を Java トランスフォームにエクスポートするを参照してください。
- この処理は元に戻せません。つまり、Java トランスフォームのコードに加えた変更を Pipeline Builder パイプラインにプッシュして反映することはできません。
- 一部のパイプラインのデータ加工はコードに変換できません。
エクスポートするパイプラインを開き、設定 > コードをエクスポートに移動します。ポップアップウィンドウが表示され、エクスポート先となる既存の Java トランスフォームリポジトリを検索して選択できます。次に、エクスポート元の Pipeline Builder ブランチを選択し、必要に応じて、エクスポート先のリポジトリで使用する新しいブランチを作成します。
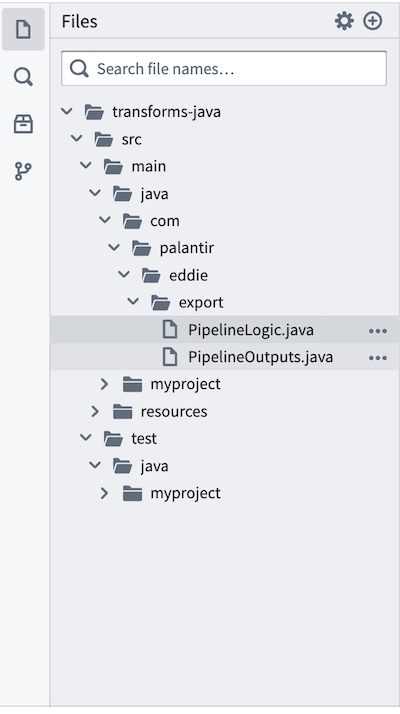
エクスポートしたパイプラインは、リポジトリの transforms-java/src/main/java/com/ にある PipelineLogic.java および PipelineOutputs.java ファイルとして利用できます。
Pipeline Builder を Java トランスフォームにエクスポートする
Pipeline Builder パイプラインを Java コードにエクスポートする際には、新しい出力が元のパイプラインの出力と必ずしも同一になるとは限らないことを理解しておくことが重要です。これには、いくつかの理由があります。
-
コード生成の制限:Pipeline Builder の多くの機能は Foundry 固有のものであり、エクスポートでは完全にはサポートされていません。これには次の機能が含まれます。
- ユーザー定義関数(UDF)
- 埋め込みを含む、LLM 呼び出しおよびモデル呼び出し
- メディア操作
- 地理時系列機能
サポートされていない機能は、生成されたコード内に
todoプレースホルダーブロックとして表示され、手動での実装が必要です。 -
ネイティブ Spark との差異:Pipeline Builder の一部の式は、信頼性の向上とエラー処理の改善のために最適化されており、ネイティブ Spark とは異なる方法で実装されています。これらの独自の最適化はエクスポートできないため、ネイティブ Spark の式に戻す必要があります。そのため、こうしたエッジケースでは動作が異なる場合があります。
コード生成でサポートされているその他のすべての式は、Spark のテストケースで検証されています。Java トランスフォームへのエクスポートは出発点として捉え、完全な正確性を確保するために、ユーザーが手動で検証する必要があります。
PySpark にエクスポートする
Pipeline Builder は、Java(Spark)トランスフォームへのパイプラインのエクスポートのみをサポートしています。Pipeline Builder パイプラインを PySpark トランスフォームにエクスポートする組み込み機能はありません。
PySpark コードが必要な場合は、上記の手順で Pipeline Builder パイプラインを Java Spark コードにエクスポートし、その後、大規模言語モデル(LLM)を使用して、エクスポートした Java Spark コードを PySpark に変換できます。この変換処理では、Pipeline Builder を Java トランスフォームにエクスポートするで説明した考慮事項と同様に、正確性を確保するために手動での検証が必要になる場合があります。