注: 以下の翻訳の正確性は検証されていません。AIPを利用して英語版の原文から機械的に翻訳されたものです。
Kafka
Foundry を Kafka に接続して、Kafka キューから Foundry ストリームにデータをリアルタイムで読み込みます。
サポートされる機能
| 機能 | ステータス |
|---|---|
| 探索 | 🟢 一般提供 |
| ストリーミング同期 | 🟢 一般提供 |
| ストリーミングエクスポート | 🟢 一般提供 |
データモデル
| key(バイナリ) | value(バイナリ) |
|---|---|
| London | {"firstName": "John", "lastName": "Doe"} |
| Paris | {"firstName": "Jean", "lastName": "DuPont"} |
Kafka コネクターはメッセージの内容をパースせず、任意のデータ型のデータを Foundry に同期できます。すべての内容は、パースされずに value 列にアップロードされます。データをパースするには、下流のストリーミングトランスフォーム(たとえば、Pipeline Builder の parse_json)を使用します。key 列には、メッセージとともに Kafka に記録されたキーが表示されます。メッセージにキーが含まれていない場合、値は null になります。
パフォーマンスと制限事項
コネクターは、デフォルトで1個のコンシューマースレッドを使用します。スループットを向上させるために、スレッドを追加で設定できます。各スレッドは独立した Kafka コンシューマーを作成し、ブローカーによってトピックのパーティションの一部が割り当てられます。パーティション数を超える数のスレッドを設定しても、余分なスレッドはアイドル状態のままになるため、追加の効果はありません。
ストリーミング同期は、継続的に長時間実行するジョブとして設計されています。期待される結果によっては、ストリーミング同期の中断はサービス停止に相当する可能性があります。
現在、ストリーミング同期には次の制限事項があります。
- Foundry ワーカー上のジョブは、少なくとも48時間に1回再起動します。想定されるダウンタイムは1桁の分数です(利用可能なリソースによりジョブをすぐに再起動できる場合)。
- レガシーの Agent ワーカーソースでは、アップグレードを適用するために、Agent のメンテナンスウィンドウ中(通常は週1回)にジョブが再起動します。想定されるダウンタイムは5分未満です。高可用性を確保するには、メンテナンスウィンドウが重ならない2個の Agent 経由で接続します。
ストリーミング同期は Foundry ワーカーで実行することを推奨します。Kafka ブローカーが Foundry から直接アクセスできないネットワーク上にある場合は、レガシーの Agent ワーカーソースではなく、Agent プロキシのエグレスポリシーを使用します。
セットアップ
- Data Connection アプリケーションを開き、画面右上の + 新規ソースを選択します。
- 利用可能なコネクターの種類から Kafka を選択します。
- インターネット経由の直接接続を使用するか、中間 Agent 経由で接続するかを選択します。
- Kafka コネクターを正常にセットアップし、ダウンタイムを短縮するために、ソースごとに2個の Agent 経由で接続することを推奨します。Agent のメンテナンスウィンドウが重ならないようにしてください。
- 追加の設定プロンプトに従い、以下のセクションの情報を使用してコネクターのセットアップを続けます。
Foundry でのコネクターのセットアップについて、詳しくはこちらをご覧ください。
コネクターの種類のページに Kafka が表示されない場合は、Palantir サポートに連絡してアクセスを有効にしてください。
ブートストラップサーバー
| パラメーター | 必須かどうか | デフォルト | 説明 |
|---|---|---|---|
| ブートストラップサーバー | はい | いいえ | Kafka ブローカーサーバーを HOST:PORT 形式で1行に1個ずつ追加します。 |
認証
Kafka 接続を認証する資格情報の方式として、SSL、ユーザー名/パスワード、Azure AD、Kerberos、または NONE を選択します。
設定した資格情報では、次の操作が許可されている必要があります。
Topicリソース:- ストリーミング同期および探索用の
Read - ストリーミングエクスポート用の
Write
- ストリーミング同期および探索用の
SSL
SSL 認証は、標準の Kafka SSL および SASL_SSL プロトコルに対応します。
SSL で認証するには、次の設定オプションを指定します。
| パラメーター | 必須かどうか | デフォルト | 説明 |
|---|---|---|---|
| エンドポイント識別アルゴリズム | はい | HTTPS | HTTPS:ブローカーのホスト名が、ブローカーの証明書内のホスト名と一致することを検証します。NONE:エンドポイント識別を無効にします。 |
| カスタムクライアント秘密鍵のパスワード(レガシー) | いいえ | 無効 | レガシーの Agent ワーカーソースにのみ適用されます。接続先で相互 TLS が必要で、秘密鍵のパスワードがキーストアのパスワードと異なる場合に有効にします。 |
| SASL を使用 | いいえ | いいえ | SASL 認証を有効にします。 |
接続に相互 TLS(双方向 SSL)が必要な場合は、秘密鍵を追加する手順に従います。カスタムのクライアント秘密鍵パスワードが必要な場合は、次の設定オプションを指定します。
| パラメーター | 必須かどうか | デフォルト | 説明 |
|---|---|---|---|
| SSL キーのパスワード | はい | いいえ | 秘密鍵の復号に必要なパスワードです。 |
SASL 認証を有効にする場合は、追加の設定を行います。
| パラメーター | 必須かどうか | デフォルト | 説明 |
|---|---|---|---|
| SASL メカニズム | いいえ | いいえ | 資格情報の暗号化に使用するアルゴリズムを選択します。 |
saslJaasConfigUsername | はい | いいえ | ユーザー名 |
| SASL JAAS 設定のパスワード | はい | いいえ | パスワード |
| SASL クライアントのコールバックハンドラークラス | はい | いいえ | SASL クライアントのデフォルトのコールバックハンドラーを表示します。SASL コールバックハンドラーの詳細は、Java SASL API ドキュメント ↗を参照してください。 |
OAuth 2.0
OAuth 認証は OAuth 2.0 プロトコルを使用します。現在、クライアントクレデンシャルグラントフローのみがサポートされています。
認証に OAuth 2.0 プロトコルを使用するには、次の設定オプションを指定します。
| パラメーター | 必須かどうか | デフォルト | 説明 |
|---|---|---|---|
| クライアントID | はい | いいえ | 認証をリクエストするアプリケーションの ID |
| クライアントシークレット | はい | いいえ | サーバーとアプリケーションの間で共有するシークレット |
| トークンエンドポイント URI | はい | いいえ | アクセストークンまたは ID トークンを発行するサーバーの Uniform Resource Identifier (URI) |
| スコープ | いいえ | いいえ | OAuth 経由で Kafka または特定の Kafka トピックに接続するには、スコープのリクエストが必要な場合があります。スコープは、認証プロバイダーで設定される任意の文字列値です。たとえば、コンシューマーが Kafka に対して取得するアクセスレベルを決めるために、認証リクエストで (kafka-topics-read, kafka-topics-list) のいずれか1つをリクエストする必要がある場合があります。 |
| SASL 拡張機能 | いいえ | いいえ | Confluent Cloud などの一部の Kafka サーバーでは、SASL 拡張機能 ↗の設定が必要な場合があります。これらは、そのサーバープラットフォームに固有のキーと値のペアです。 |
Azure AD
Azure AD 認証モードは、Azure Event Hubs の Kafka インターフェースに適用されます。このモードには Azure AD サービスプリンシパルが必要です。サービスプリンシパルを作成し、Event Hubs へのアクセスを設定する方法については、Azure ドキュメント ↗を参照してください。
| パラメーター | 必須かどうか | デフォルト |
|---|---|---|
| テナントID | はい | いいえ |
| クライアントID | はい | いいえ |
| クライアントシークレット | はい | いいえ |
Azure Event Hubs の Kafka インターフェースには、SAS トークン ↗経由でもアクセスできます。SAS トークンで認証するには、ユーザー名/パスワード認証を選択し、ユーザー名に $ConnectionString(引用符なし)、パスワードに Event Hubs の接続文字列を指定します。
なし
Kafka の標準の PLAINTEXT プロトコルに対応します。
認証も SSL も使用せずにコネクターを設定すると、コネクターと Kafka ブローカーの間で暗号化されていないデータが送信されるため、この設定は強く非推奨とします。この設定は、安全なネットワーク内でのみ使用してください。
ネットワーク
コネクターは Kafka ブローカーのホストにアクセスできる必要があります。直接接続を使用する場合は、すべてのブートストラップサーバーホストに対して DNS エグレスポリシーを作成します。
証明書と秘密鍵
SSL および TLS 用に、クライアントまたはサーバーの証明書と秘密鍵を追加で設定する必要がある場合があります。
Foundry ワーカーを使用するソースでは、Control Panel でエグレス証明書を使用して、証明書を一元的に作成および管理できます。設定した証明書は、Data Connection ソースに適用できます。
SSL
SSL 接続では、サーバー証明書を検証します。通常、SSL の検証は証明書チェーンを通じて行われます。デフォルトでは、Agent ワーカーと Foundry ワーカーのどちらも、ほとんどの標準的な証明書チェーンを信頼します。ただし、接続先のサーバーに自己署名証明書がある場合、またはホスト名検証によって接続が遮断される場合は、コネクターがその証明書を信頼する必要があります。使用する適切な証明書については、Kafka 管理者にお問い合わせください。
Data Connection での証明書の使用について、詳しくはこちらをご覧ください。
相互 TLS (mTLS)
Kafka クラスターでは、サーバーとクライアントの両方が mTLS で認証する必要がある場合があります。mTLS を有効にするには、次を設定する必要があります。
コネクターの実行タイプに応じて、以下の手順に従ってクライアント秘密鍵を設定します。
Agent 用のクライアント秘密鍵を設定する
Agent 経由で接続する場合は、秘密鍵を追加する手順に従います。
直接接続用のクライアント秘密鍵を設定する
直接接続する場合は、コネクター設定ページのクライアント証明書および秘密鍵の設定セクションで秘密鍵をアップロードします。表示されるポップアップでエイリアス kafka を使用し、秘密鍵とクライアント証明書を追加します。


Kafka からデータを同期する
Kafka との同期を設定する方法については、ストリーミング同期を設定するチュートリアルを参照してください。より複雑なシナリオでは、コードによる代替アプリケーションを使用します。
Schema Registry 統合
Kafka Schema Registry は、すべてのスキーマのバージョン履歴を保持する一元化されたストレージシステムとして機能します。このレジストリーは Avro、Protobuf、JSON スキーマとの互換性を提供し、SerDes(シリアライザー/デシリアライザー)を使用して、スキーマ形式とシリアライズされたデータとの間の変換を容易にします。
Kafka Schema Registry を効果的に活用するには、対象の Kafka トピックのスキーマを登録し、ソース設定に Schema Registry URL を追加する必要があります。この変更により、コネクターは生のバイトを対応するデータ型に変換できるようになります。
たとえば、標準的な抽出では通常、以下に示すように Kafka から生のバイトを Foundry に取り込みます。

一方、Schema Registry を設定すると、コネクターはバイトの基になるスキーマを識別し、以下に示すように Foundry のネイティブなデータ型に変換できます。
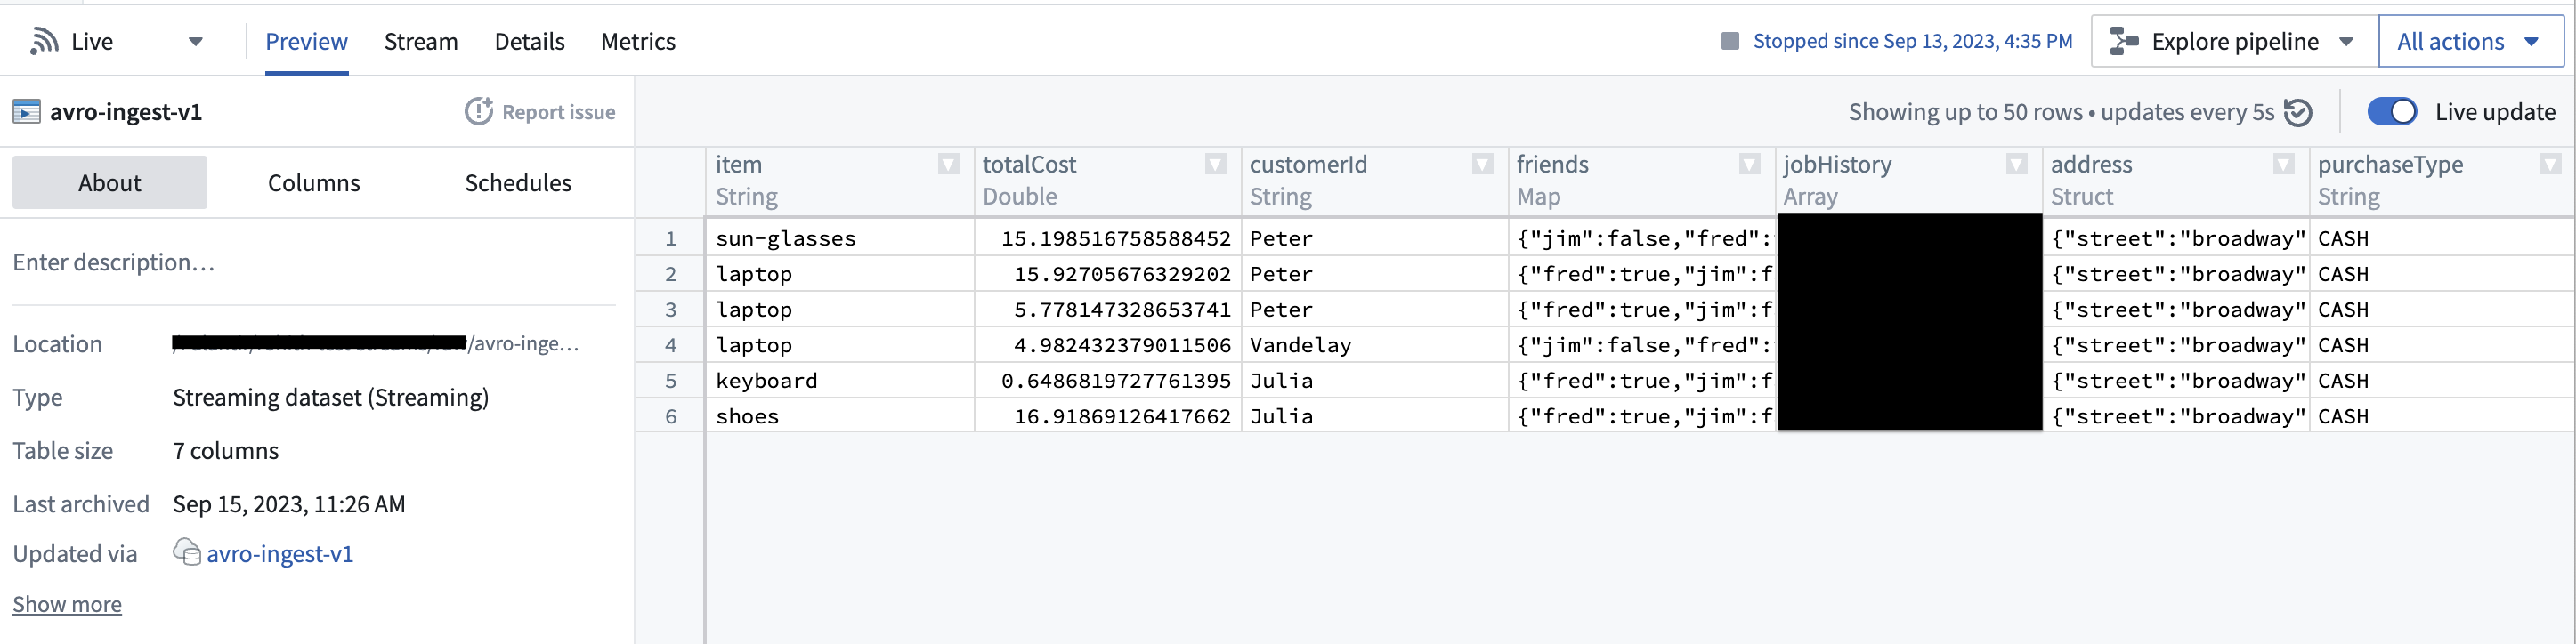
この機能により、煩雑な型変換が不要になり、下流のパイプラインを大幅に簡素化できます。さらに、Schema Registry はスキーマの一元管理と、スキーマの進化に伴う互換性チェックを提供するため、データの整合性保証も向上します。
データを Kafka にエクスポートする
このコネクターは、Data Connection を介した外部 Kafka クラスターへのストリームのエクスポートをサポートします。より複雑なシナリオでは、コードによる代替アプリケーションを使用します。
Kafka にエクスポートするには、まず Kafka コネクターのエクスポートを有効にします。次に、新しいエクスポートを作成します。
エクスポート設定オプション
| オプション | 必須かどうか | デフォルト | 説明 |
|---|---|---|---|
Topic | はい | N/A | エクスポート先の Kafka トピックです。 |
Linger milliseconds | はい | 0 | Kafka にレコードを送信するまでの待機時間(milliseconds)です。待機中に蓄積されたレコードは、エクスポート時にまとめてバッチ処理されます。この設定のデフォルトは0で、レコードは即座に送信されます。ただし、このデフォルト設定では Kafka インスタンスへのリクエスト数が増える場合があります。 |
Key column | いいえ | 未設定 | Kafka にレコードを発行するときに Key として使用する Foundry ストリームの列です。null キーには対応していません。エクスポートするストリームのすべてのレコードで、選択した列に値が設定されていることを確認してください。 |
Value column | いいえ | 未設定 | エクスポートする Foundry ストリームの列です。値を指定しない場合は、行のすべてのフィールドがバイト列にシリアライズされ、メッセージ本文として Kafka にエクスポートされます。 |
Header column | いいえ | 未設定 | ストリーミングレコードに付加するヘッダーとして使用する Foundry ストリームの列です。この列は構造体型である必要があり、構造体内のすべてのフィールドは文字列としてパースされます。値を指定しない場合、または列が null の場合は、ヘッダーは付加されません。 |
Enable Base64 Decode | いいえ | 無効 | Foundry ストリームのバイナリデータは、内部に保存されるときに Base64 でエンコードされます。このフラグを有効にすると、エクスポート前にバイナリデータがデコードされます。Key column と Value column の両方を指定した場合にのみ有効にできます。 |
エクスポートタスクの設定(レガシー)
エクスポートタスクを使用した Kafka へのエクスポートは推奨しません。可能であれば、既存のエクスポートタスクを移行して、推奨するエクスポート機能を使用してください。以下のドキュメントは、過去の機能を参照するためのものです。
エクスポートタスクを使用してデータのエクスポートを開始するには、エクスポート先の Kafka コネクターを含むプロジェクトフォルダーに移動します。コネクター名を右クリックし、Data Connection タスクを作成を選択します。
Data Connection 画面の左側のパネルで、次の操作を行います。
- ソース名が、使用する Kafka コネクターと一致していることを確認します。
- ストリーミングデータセット型の、
datasetという名前の入力を追加します。入力データセットは、エクスポートする Foundry データセットです。 - ストリーミングエクスポート型の、
datasetという名前の出力を追加します。出力データセットは、タスクの実行、スケジュール設定、監視に使用します。 - 最後に、テキストフィールドに YAML ブロックを追加して、タスクの設定を定義します。
YAML を作成する際は、次のオプションを使用します。
| オプション | 必須かどうか | デフォルト | 説明 |
|---|---|---|---|
maxParallelism | はい | いいえ | データのエクスポートに使用できる並列スレッドの最大数です。入力 Foundry ストリームのパーティション数が maxParallelism より小さい場合、実際のスレッド数はそのパーティション数によって決まります。 |
topic | はい | いいえ | データのプッシュ先のトピック名です。 |
clientId | はい | エクスポートタスクに使用する識別子です。この識別子は Kafka の client.id に対応します。詳細は、Kafka ドキュメント ↗を参照してください。 | |
batchOptions | はい | いいえ | 以下の batchOptions 設定を参照してください。 |
keyColumn | いいえ | いいえ | 入力ストリーミングデータセット内の列名です。この列の値は、エクスポートされるメッセージのキーとして使用されます。このプロパティを省略すると、キーの値として null がエクスポートされます。 |
valueColumn | いいえ | いいえ | 入力ストリーミングデータセット内の列名です。この列の値は、エクスポートされるメッセージの値として使用されます。このプロパティを省略すると、すべての列が文字列化された JSON オブジェクトとして value フィールドにエクスポートされます。 |
enableIdempotence | いいえ | true | 詳細は、Kafka ドキュメント ↗を参照してください。 |
useDirectReaders | はい | いいえ | 常に false に設定します。例に従って設定します。 |
transforms | はい | いいえ | 以下の設定例を参照してください。 |
次のオプションを使用して batchOptions を設定します。
| オプション | 必須かどうか | デフォルト | 説明 |
|---|---|---|---|
maxMilliseconds | はい | いいえ | 利用可能な行を出力トピックに書き込むまでの最大待機時間(milliseconds)です。低遅延化するにはこの値を小さくし、ネットワークのオーバーヘッド(リクエスト数)を減らすには大きくします。バッチが先に maxRecords の上限に達しない限り、この値が使用されます。 |
maxRecords | はい | いいえ | 出力トピックに書き込む前にバッファリングするメッセージの最大数です。低遅延化するにはこの値を小さくし、ネットワークのオーバーヘッド(リクエスト数)を減らすには大きくします。バッチが先に maxMilliseconds の上限に達しない限り、この値が使用されます。 |
以下に、エクスポートタスクの設定例を示します。
Copied!1 2 3 4 5 6 7 8 9 10 11 12 13 14type: streaming-kafka-export-task config: maxParallelism: 1 topic: test-topic clientId: client-id keyColumn: key valueColumn: value batchOptions: maxMilliseconds: 5000 maxRecords: 1000 transforms: transformType: test userCodeMavenCoords: [] useDirectReaders: false
エクスポートタスクを設定したら、右上隅の保存を選択します。
コードで Kafka ソースを使用する
より複雑なシナリオでは、コードによる代替アプリケーションを使用して Kafka ソースに接続できます。以下の例では、外部トランスフォームで Apache Kafka 用 Python クライアント ↗である kafka-python を使用して、Apache Kafka ソースに接続する方法を示します。
外部トランスフォームで Kafka から読み取る
この例では、インクリメンタル(差分処理)バッチ処理を使用して、指定した Kafka トピックからメッセージを読み取ります。1回あたり1分間、または最大100件のメッセージを読み取ります。
Copied!1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54from transforms.api import Output, lightweight, incremental, transform_pandas from transforms.external.systems import external_systems, Source, ResolvedSource from datetime import timedelta, datetime from kafka import KafkaConsumer import json import pandas as pd @lightweight @incremental() @external_systems( kafka_source=Source("<source_rid>") ) @transform_pandas( Output("<output_dataset_rid>"), ) def compute(kafka_source: ResolvedSource) -> pd.DataFrame: # 1. Kafka コンシューマーをセットアップします USERNAME = kafka_source.get_secret("username") PASSWORD = kafka_source.get_secret("password") BOOTSTRAP_SERVER = "<server in the form host[:port]> " # サーバーのリストも指定できます TOPIC = "<topic name>" CONSUMER_NAME = "<consumer name>" # オフセットのコミットに使用するコンシューマーの一意の名前 consumer = KafkaConsumer( TOPIC, bootstrap_servers=BOOTSTRAP_SERVER, security_protocol="SASL_SSL", sasl_mechanism="PLAIN", sasl_plain_username=USERNAME, sasl_plain_password=PASSWORD, group_id=CONSUMER_NAME, enable_auto_commit=True, # オフセットの自動コミットを有効にします ) # 2. メッセージの読み取り時間と内容の上限を定義します MAX_BATCH_SIZE = 100 TIMEOUT_MINUTES = 1 END_TIME: datetime = datetime.now() + timedelta(minutes=TIMEOUT_MINUTES) # 3. メッセージを取得して処理します events_received = [] count = 0 while datetime.now() < END_TIME and count < MAX_BATCH_SIZE: # メッセージをポーリングします(新しいメッセージを最大1秒待ちます) msg_pack = consumer.poll(timeout_ms=1000) for _, messages in msg_pack.items(): for message in messages: events_received.append(json.loads(message.value)) count += 1 consumer.close() # 4. 結果を返します return pd.DataFrame(events_received)
インクリメンタルなオフセット追跡で Kafka から読み取る
以下の例では、Kafka トピックから利用可能なすべてのメッセージを読み取り、オフセットを別のデータセットに保存することで、次回の実行時に前回停止した位置から再開します。上記の基本的な例とは異なり、この方法は Kafka コンシューマーグループの自動コミットに依存しません。代わりに、パーティションを手動で割り当て、以前に保存したオフセットにシークし、各パーティションの末尾オフセットに達するまでポーリングします。
このトランスフォームは2つの出力を生成します。
records_output:取り込んだ Kafka レコードoffsets_output:パーティションごとに最後に消費したオフセットを保存する小さなデータセットで、次回のインクリメンタル実行時に使用します
Copied!1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 104 105 106 107 108 109 110 111 112 113 114 115 116 117 118 119 120 121 122 123 124 125 126 127 128 129 130 131 132 133 134 135 136 137 138 139 140import logging from datetime import datetime, timedelta from collections import defaultdict import polars as pl from kafka import KafkaConsumer from transforms.api import ( Output, transform, incremental, LightweightOutput, IncrementalLightweightOutput, IncrementalTransformContext, ) from transforms.external.systems import external_systems, Source, ResolvedSource logger = logging.getLogger(__name__) def wait_for_partition_assignment(consumer, timeout_seconds=30): """ブローカーがこのコンシューマーにパーティションを割り当てるまでポーリングします。""" deadline = datetime.now() + timedelta(seconds=timeout_seconds) while not consumer.assignment(): consumer.poll(timeout_ms=100) if datetime.now() > deadline: raise TimeoutError( f"Partition assignment did not complete within {timeout_seconds} seconds." ) def read_offsets(offsets_output, ctx): """前回のインクリメンタル実行のオフセットマップを読み込みます。""" if not ctx.is_incremental: return {} offset_df = offsets_output.polars(mode="previous") result = defaultdict(dict) for row in offset_df.iter_rows(named=True): result[row["topic"]][row["partition"]] = row["offset"] return result def write_offsets(offsets, offsets_output): """次回のインクリメンタル実行に備えて、現在のオフセットマップを永続化します。""" rows = [ {"topic": topic, "partition": partition, "offset": offset} for topic, partitions in offsets.items() for partition, offset in partitions.items() ] df = pl.DataFrame(rows, schema={"topic": pl.Utf8, "partition": pl.Int32, "offset": pl.Int64}) offsets_output.set_mode("replace") offsets_output.write_table(df) @external_systems( kafka_source=Source("<source_rid>") ) @incremental() @transform.using( records_output=Output("<records_dataset_rid>"), offsets_output=Output("<offsets_dataset_rid>"), ) def compute( kafka_source: ResolvedSource, records_output: LightweightOutput, offsets_output: IncrementalLightweightOutput, ctx: IncrementalTransformContext, ): # 1. オフセットを手動で管理するコンシューマーを作成します consumer = KafkaConsumer( "<topic_name>", bootstrap_servers="<bootstrap_server>", security_protocol="SASL_SSL", sasl_mechanism="PLAIN", sasl_plain_username=kafka_source.get_secret("username"), sasl_plain_password=kafka_source.get_secret("password"), enable_auto_commit=False, auto_offset_reset="earliest", group_id="external-transform-consumer", ) # 2. パーティションの割り当てを待ち、終了位置として末尾のオフセットを記録します wait_for_partition_assignment(consumer) end_offsets = {tp.partition: consumer.end_offsets([tp])[tp] for tp in consumer.assignment()} # 3. インクリメンタル実行では、各パーティションを最後に保存したオフセット + 1 の位置にシークします saved_offsets = read_offsets(offsets_output, ctx) topic_offsets = saved_offsets.get("<topic_name>", {}) for tp in consumer.assignment(): last_offset = topic_offsets.get(tp.partition) if last_offset is not None: consumer.seek(tp, last_offset + 1) # 4. 末尾のオフセットに達するまでメッセージをポーリングします current_offsets = {} rows = [] MAX_IDLE_POLLS = 5 idle_count = 0 while idle_count <= MAX_IDLE_POLLS: msg_pack = consumer.poll(timeout_ms=1000, max_records=1000) if not msg_pack: idle_count += 1 continue idle_count = 0 for tp, messages in msg_pack.items(): for message in messages: rows.append({ "topic": message.topic, "partition": message.partition, "offset": message.offset, "timestamp": message.timestamp, "key": message.key.decode("utf-8") if message.key else None, "value": message.value.decode("utf-8"), }) current_offsets[tp.partition] = message.offset # すべてのパーティションが末尾のオフセットに達したら停止します if all( current_offsets.get(p, -1) >= end - 1 for p, end in end_offsets.items() ): break consumer.close() # 5. レコードを出力データセットに書き込みます if rows: records_df = pl.DataFrame(rows) records_output.set_mode("replace") records_output.write_table(records_df) else: ctx.abort_job() return # 6. 次回の実行に備えてオフセットを永続化します all_offsets = dict(saved_offsets) all_offsets["<topic_name>"] = current_offsets write_offsets(all_offsets, offsets_output)
基本的な例との主な違いは、次のとおりです。
- 自動コミットなし: オフセットは Kafka にコミットするのではなく Foundry データセットに保存されるため、処理セマンティクスを完全に制御できます。
- パーティションの割り当て:
wait_for_partition_assignment()ヘルパーは、末尾オフセットを読み取る前に、コンシューマーにパーティションが割り当てられていることを確認します。 - インクリメンタルなシーク: 次回以降の実行では、トランスフォームは以前のオフセットのデータセットを読み取り、すでに消費したメッセージより先にシークします。
- 末尾オフセットでの停止: すべてのパーティションがそれぞれの末尾オフセットに達するとポーリングループが終了するため、トランスフォームは無期限に停止しなくなることなく、利用可能なすべてのメッセージを処理します。
すべての行をメモリーに保持するとメモリー不足エラーが発生する可能性がある大容量のトピックでは、書き込む前にすべてのレコードを収集するのではなく、メモリー使用量を考慮したバッファリング付き Parquet ライターのパターンを使用して、レコードをインクリメンタルにディスクに書き出すことを検討してください。
外部トランスフォームで Kafka に書き込む
この例では、合成センサーデータを指定した Kafka トピックに2秒ごとに1分間書き込みます。
Copied!1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62from transforms.api import Output, transform_pandas, lightweight from transforms.external.systems import external_systems, Source, ResolvedSource from datetime import datetime, timedelta import pandas as pd from kafka import KafkaProducer import time import random import json @external_systems( kafka_source=Source("<source_rid>") ) @transform_pandas( Output("<output_dataset_rid>"), ) def compute(kafka_source: ResolvedSource) -> pd.DataFrame: # 1. Kafka プロデューサーをセットアップします USERNAME = kafka_source.get_secret("username") PASSWORD = kafka_source.get_secret("password") BOOTSTRAP_SERVER = "<server in the form host[:port]> " # サーバーのリストも指定できます TOPIC = "<topic name>" producer = KafkaProducer( bootstrap_servers=BOOTSTRAP_SERVER, security_protocol="SASL_SSL", sasl_mechanism="PLAIN", sasl_plain_username=USERNAME, sasl_plain_password=PASSWORD, ) # 2. 定期的なデータ送信のパラメーターを定義します TIMEOUT_MINUTES = 1 INTERVAL_SECONDS = 2 END_TIME: datetime = datetime.now() + timedelta(minutes=TIMEOUT_MINUTES) # 3. センサーデータを送信します events_sent = [] while datetime.now() < END_TIME: data = get_random_sensor_data(datetime.now()) # これは実際のデータに置き換えてください producer.send(TOPIC, value=json.dumps(data).encode("utf-8")) events_sent.append(data) time.sleep(INTERVAL_SECONDS) producer.flush() producer.close() # 4. 結果を返します return pd.DataFrame(events_sent, columns=["timestamp", "temperature_c", "humidity_percent", "pressure_hpa", "status"]) def get_random_sensor_data(timestamp): """指定されたタイムスタンプのランダムなセンサーデータを生成します。実際のデータに置き換えてください""" def random_sensor_status(): # 90% OK, 8% WARN, 2% FAIL return random.choices(["OK", "WARN", "FAIL"], weights=[90, 8, 2], k=1)[0] return { "timestamp": timestamp.isoformat(), "temperature_c": round(random.gauss(22, 2), 2), # mean=22C, std=2 "humidity_percent": round(random.gauss(50, 10), 1), # mean=50%, std=10 "pressure_hpa": round(random.gauss(1013, 5), 1), # mean=1013 hPa, std=5 "status": random_sensor_status(), }