注: 以下の翻訳の正確性は検証されていません。AIPを利用して英語版の原文から機械的に翻訳されたものです。
ストリーミング同期を設定する
同期とは、ソースから特定のデータを読み取り、Foundry に取り込むタスクです。たとえば、複数のテーブルを含むリレーショナルデータベースソースがある場合、特定のテーブルを Foundry に取り込むように同期を設定できます。
ストリーミング同期は、非ストリーミング(バッチまたはインクリメンタル(差分))の同期と似ていますが、いくつかの違いがあります。主な違いは、バッチ同期やインクリメンタル同期が定期的に実行されるのに対し、ストリーミング同期は継続的に実行され、遅延をできるだけ抑えて Foundry にデータを取り込むことです。
以下では、同期の作成に必要な手順を説明します。
このチュートリアルでは、Kafka ソースを使用して同期を設定します。
パート1. データを定義する
まず、Foundry に同期するデータを決めます。Data Connection でストリーミングソースを選択し、右上に表示されるアクションを選択します。
- ソースを探索して同期を作成: この選択肢は、ソースの種類がソース探索に対応している場合に表示され、データソースを探索しながら同期を作成できます。
- 同期を作成: この選択肢は、ソースの種類がソース探索に対応していない場合に表示されます。
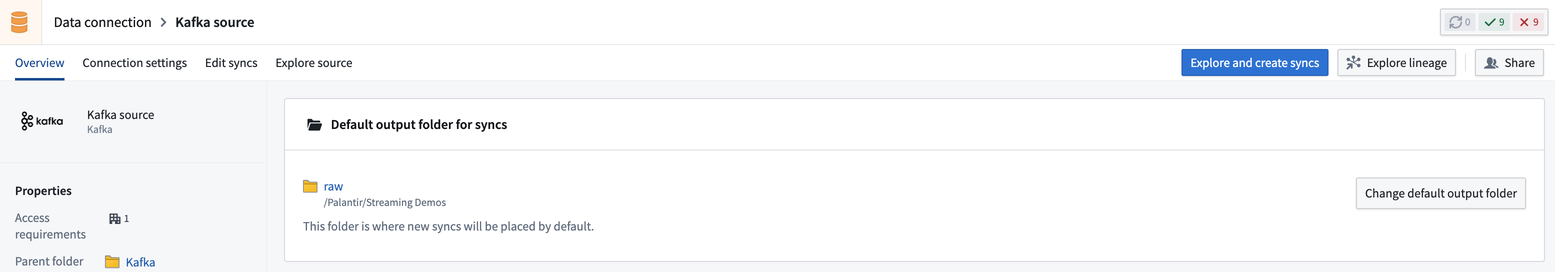
ソースを探索して同期を作成する
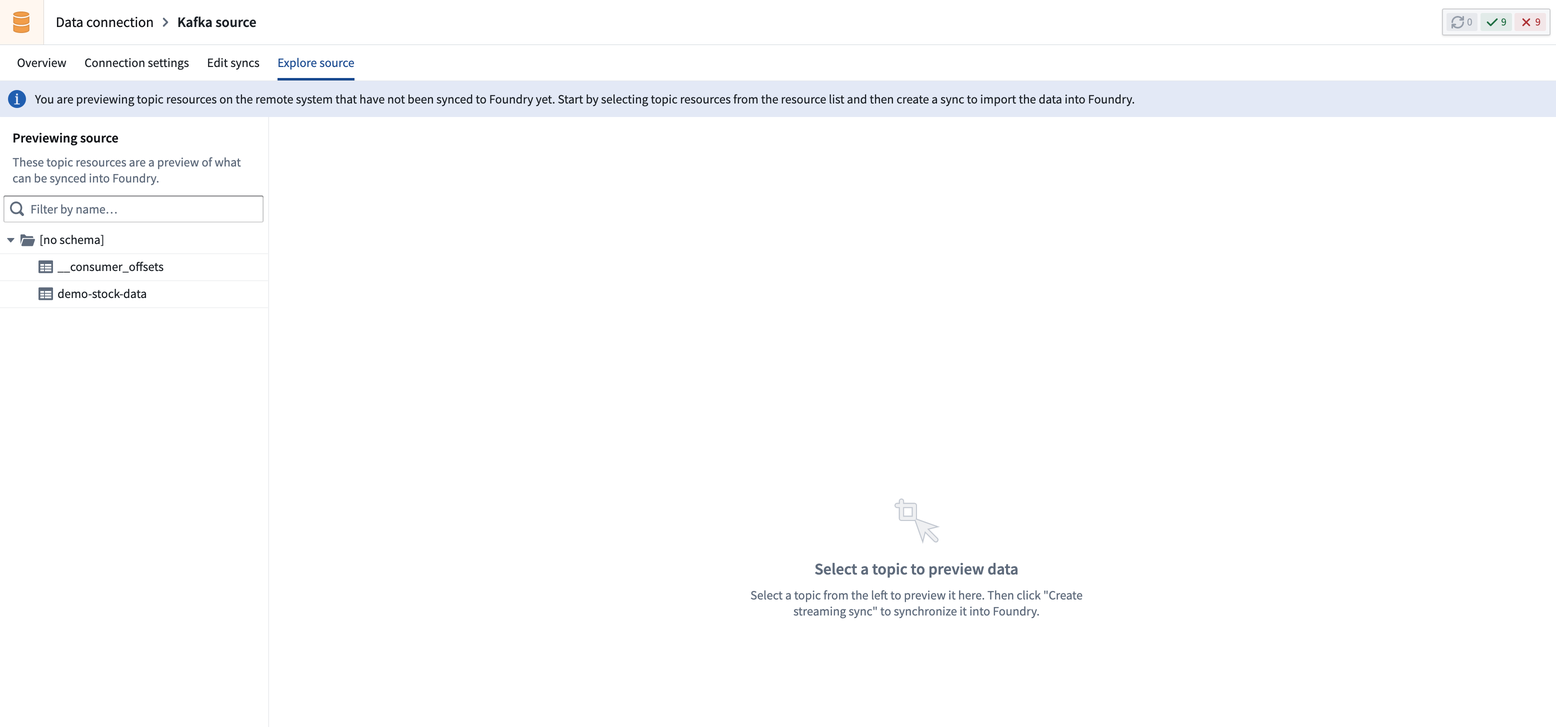
ソースの種類がソース探索に対応している場合、Data Connection のソースを探索ページに移動し、同期可能なデータが表示されます。探索表示のインターフェースは、使用するソースの種類によって異なります。たとえば、Kafka ソースの探索では、Kafka ブローカーに存在するトピック ↗を確認し、そのトピックに含まれるデータをプレビューできます。
Kafka の探索表示では、ページ左側のリストで既存のトピックを確認できます。
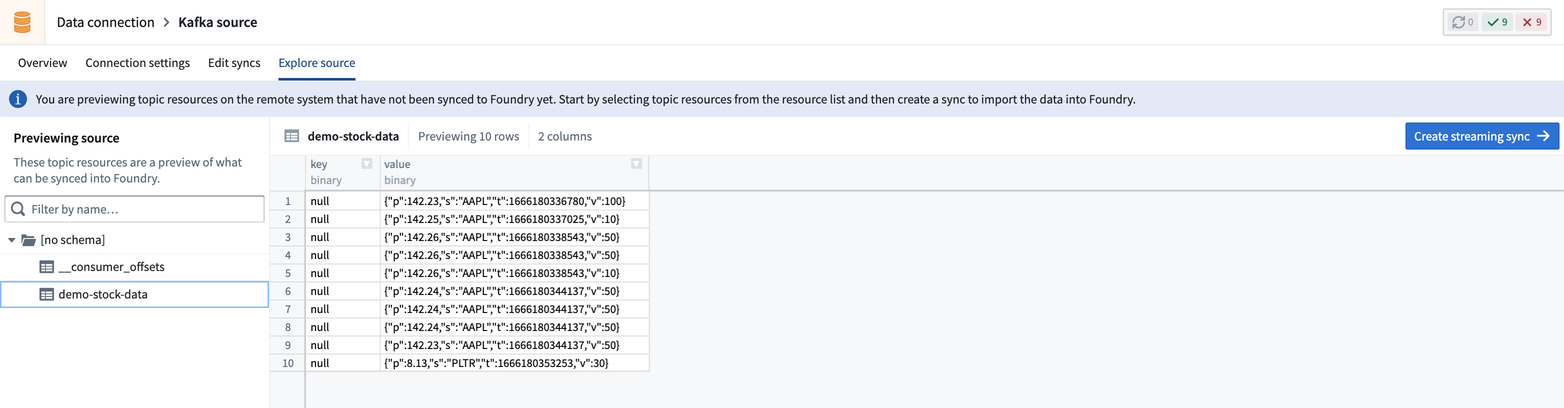
トピックを選択すると、そのトピックのデータサンプルをプレビューできます。
パート2. 同期の保存先を定義する
次に、同期するデータセットを Foundry のどこに保存するかを決めます。データセットの場所によって、プロジェクトレベルの権限に基づいて、作成されるデータセットにアクセスできるユーザーが決まります。
同期するデータセットは、プロジェクト内でそのソースと同じ場所に保存し、同じ権限を持つようにすることを推奨します。データセットとソースの権限が一致していると、データパイプラインの作成に役立ちます。データパイプラインに推奨されるプロジェクト構造について、詳しくはこちら。
同期の保存先を選択したら、右上のストリーミング同期を作成をクリックします。
パート3. ストリーミング同期を設定する
Data Connection の同期の作成ページに移動します。このページでは、同期のソース固有の設定とストリーミングの基本設定を定義できます。
- ソース固有: 設定ページの上部にあるこれらのオプションは、ソースの種類によって異なります。接続するソースに渡すパラメーターを設定します。
- ストリーミングの基本設定: ソース固有の設定の下にあるこれらのオプションは、すべてのストリーミング同期に共通です。基本設定には、スループット、スキーマ、同期の宛先が含まれます。
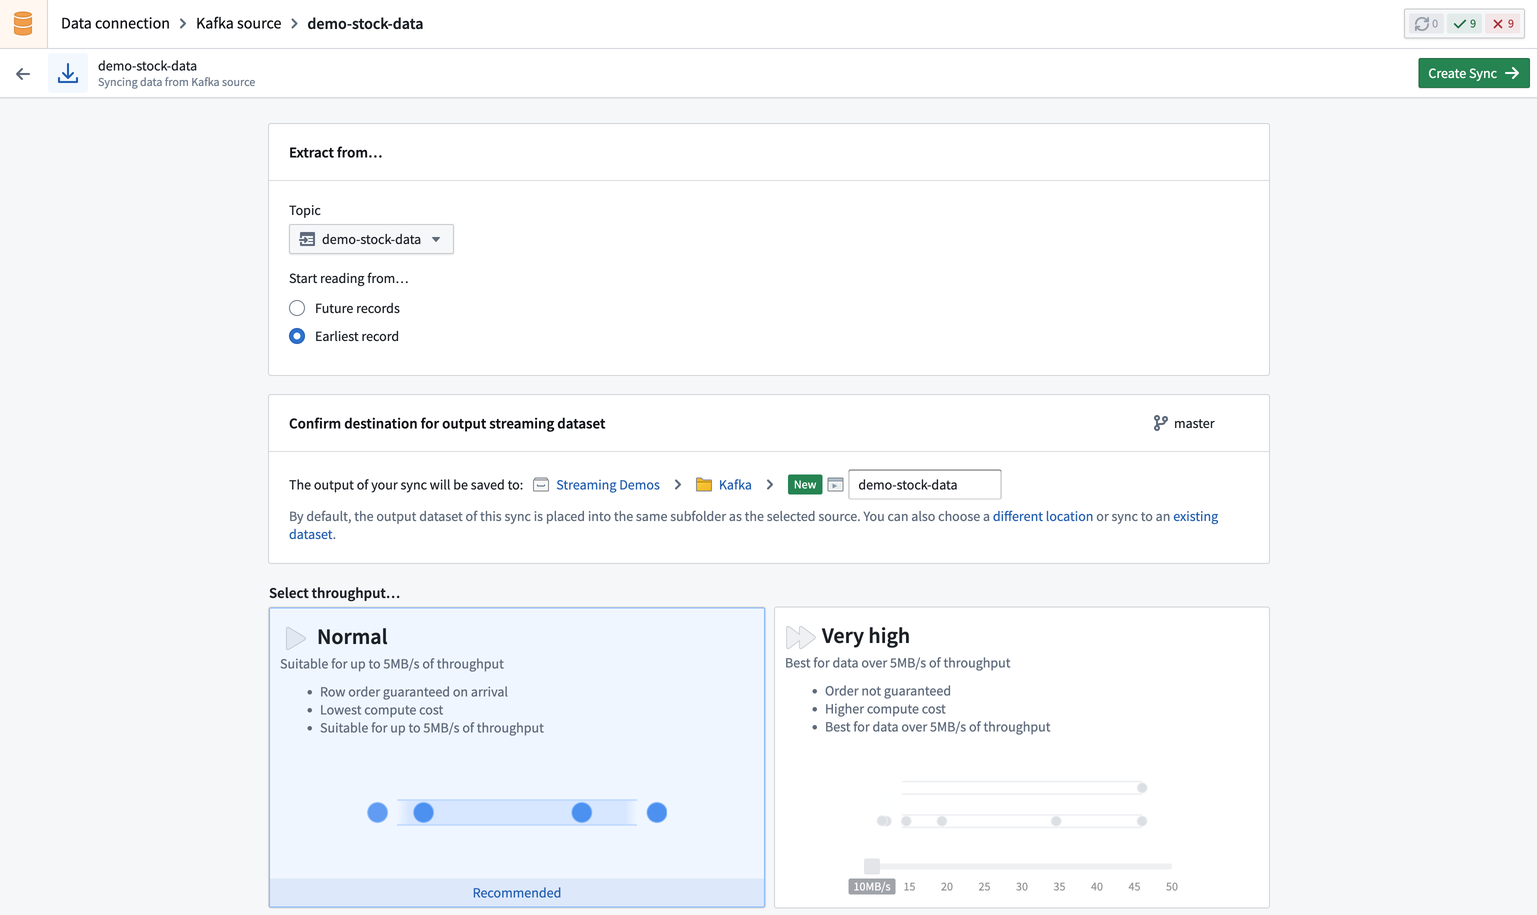
追加設定メニューのコンピュートプロファイル設定にあるソース設定オプションでコンピュートプロファイルのサイズを選択すると、ストリーミング同期のコンピュートリソースを指定できる場合があります。Agent ワーカーを使用するソースでは、コンピュートが Agent ホスト上で実行されるため、このオプションは利用できません。
次に、ストリームのスループットを選択します。スループットによって、作成されるパーティションの数が決まります。パーティション数を多くすると、より高いスループットを実現できます。スループットで通常を選択すると、そのストリームでは最大 5 MB/s を利用できます。
続いて、入力データのスキーマを指定します。デフォルトではソースから推論されますが、必要に応じて上書きできます。
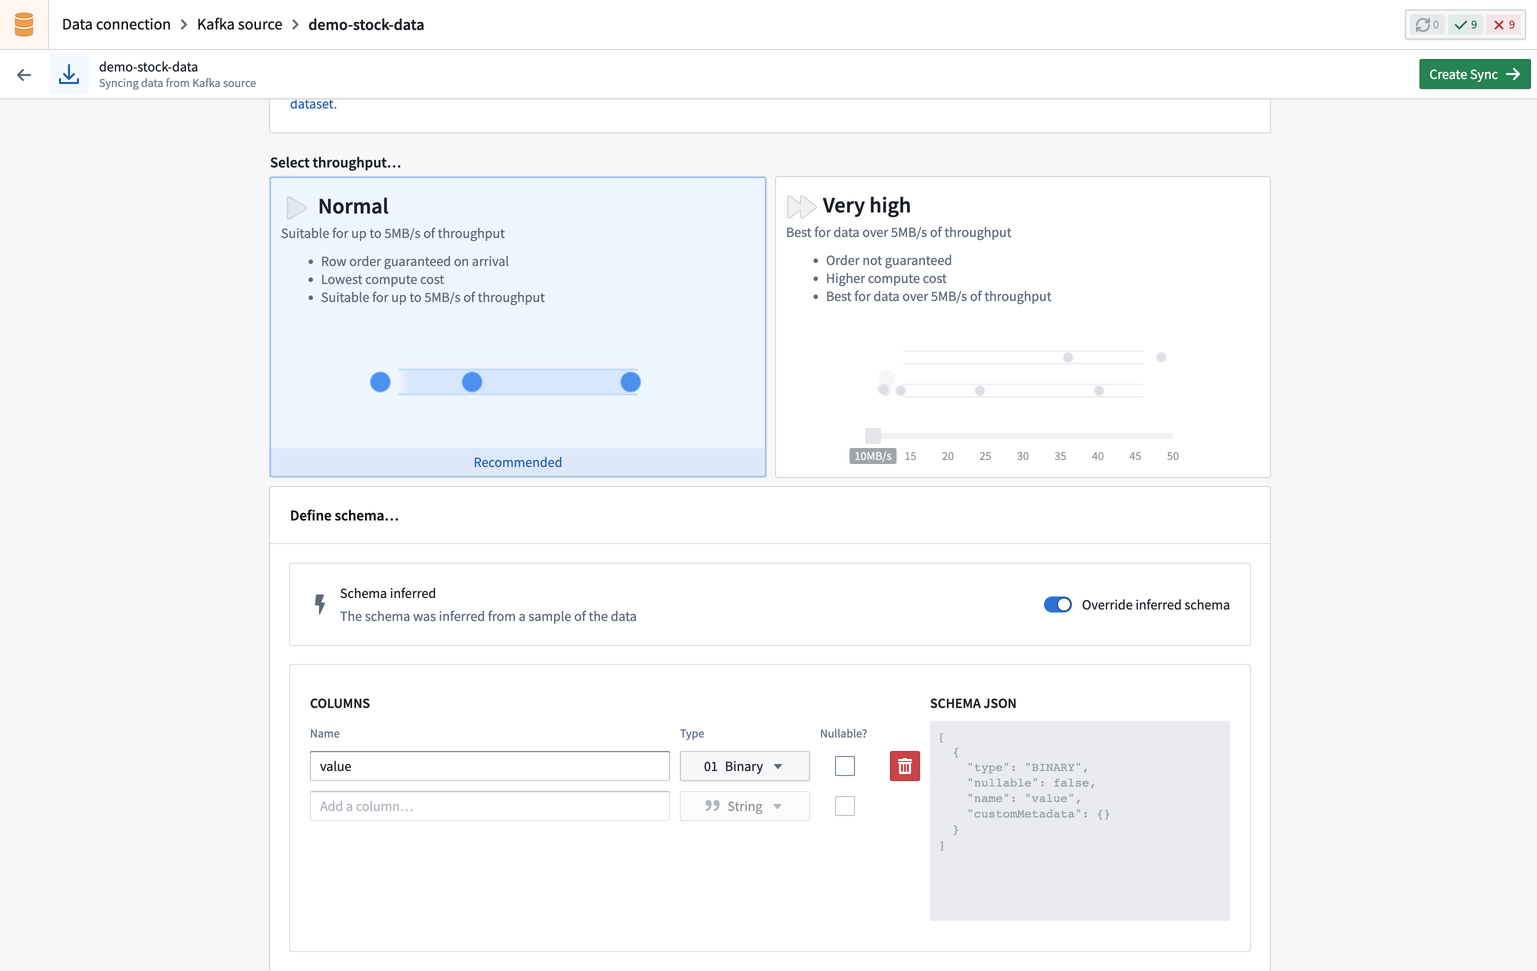
同期を設定したら、右上の同期を作成を選択します。
同期が作成されると、概要タブに移動します。
パート4. 同期を実行する
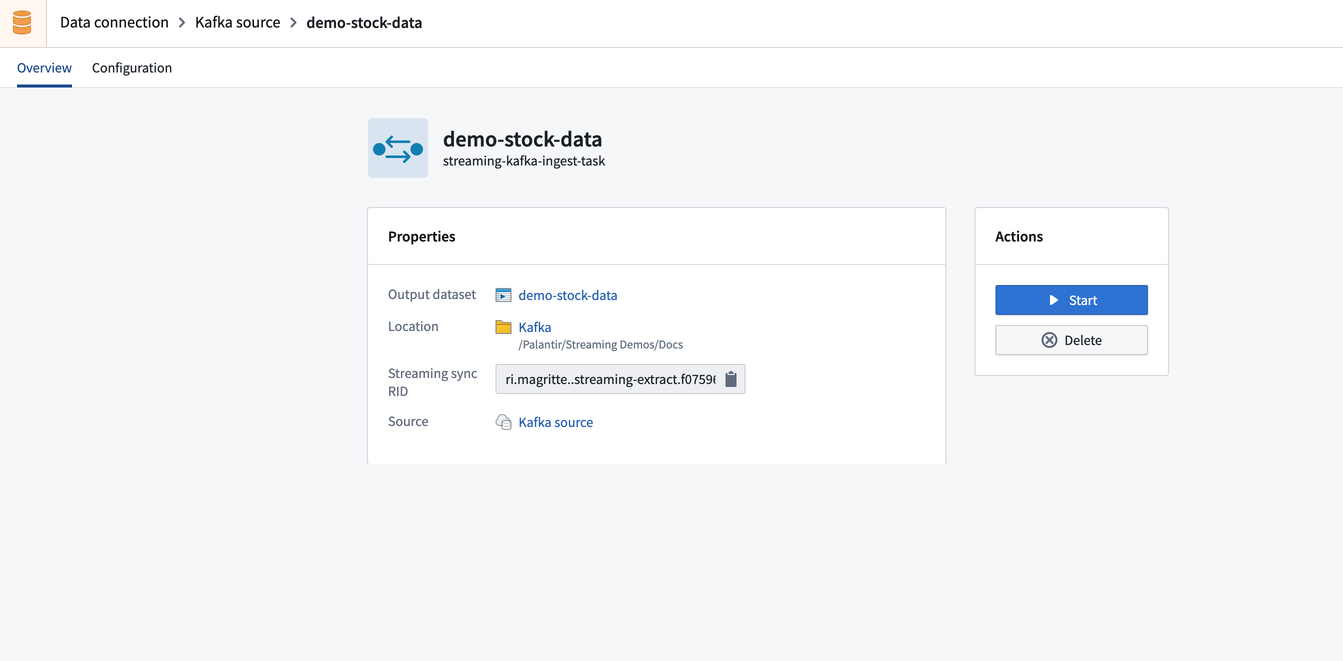
これで同期を実行する準備ができました。概要タブを選択すると、出力データセット、場所、利用可能なアクションなど、新しい同期の概要を確認できます。
開始をクリックして、外部ストリームから Foundry へのデータ同期の実行を開始します。
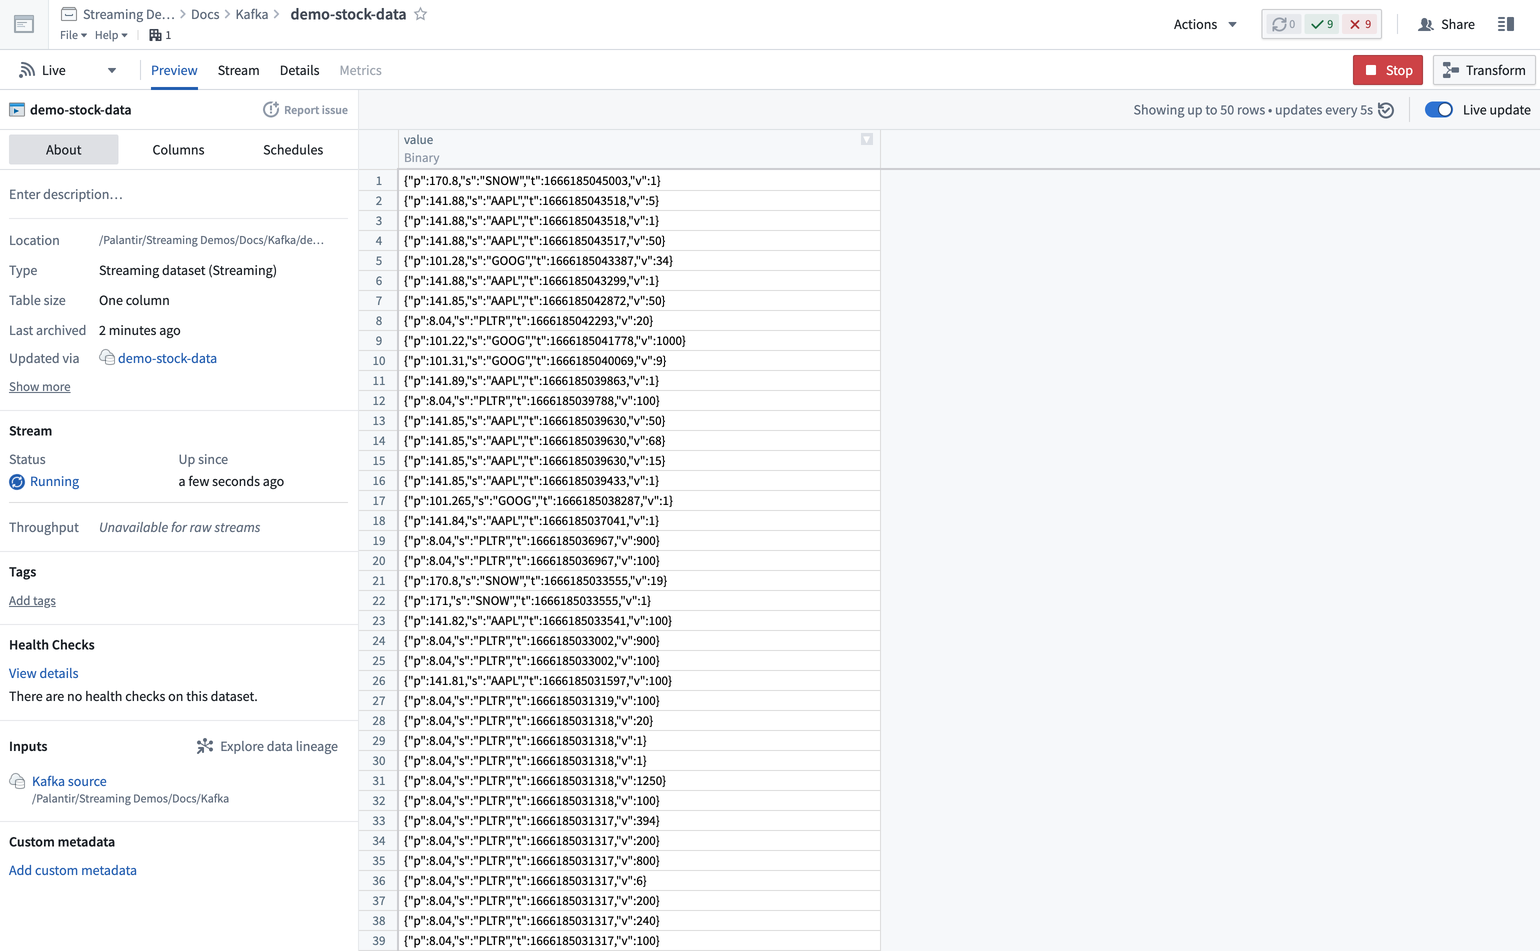
ストリームデータを表示するには、同期の作成時に設定したストリームに移動し、ストリームのプレビューページを表示します。ストリームに Kafka トピックからレコードが流れていることを確認できるはずです。
次のステップ
同期を正常に実行できたら、失敗しているストリームをデバッグする方法、プッシュベースの取り込みでストリームにデータをプッシュする方法、またはストリームをオントロジーと統合する方法を学びます。