注: 以下の翻訳の正確性は検証されていません。AIPを利用して英語版の原文から機械的に翻訳されたものです。
Pipeline Builder で一意の ID を作成する
Pipeline Builder では、一意の ID によってデータの追跡、処理、分析が容易になり、各レコードを個別に識別して適切に扱えるようになります。このため、レコードに一意の識別子(ID)を作成する必要がある場合がよくあります。このセクションでは、単調増加する ID の使用が最適な方法ではない理由と、一意の ID の生成には文字列列を連結してから SHA256 ハッシュを生成する方法が推奨される理由を説明します。
文字列列の連結と SHA256 ハッシュを使用する
一意の ID を生成する最適な方法は、入力データの文字列列を連結し、その連結した文字列の SHA256 ハッシュを作成することです。
Pipeline Builder でこの方法を使って一意の ID を生成するには、Pipeline Builder のデータ加工パス内で次の手順を実行します。
- 組み合わせることでデータセット内の各レコードを一意に識別できる文字列列を特定します。
- 選択した文字列列を連結して、各レコードの単一の文字列を作成します。
- 「Hash sha256」を使用して、連結した文字列の SHA256 ハッシュを計算します。生成された256ビットのハッシュは64文字の16進数文字列で表すことができ、各レコードの一意の ID として使用されます。

この方法には、次の利点があります。
- 一貫性: 同じ入力データからは常に同じ一意の ID が生成されるため、データパイプラインを何度実行しても一貫性が保たれます。これにより、レコードの追跡、重複の識別、データの照合が容易になります。特に、ID をオブジェクトの主キーとして使用する場合、パイプラインの再ビルドによって主キーが変わることは避ける必要があります。また、下流でデータを扱う人が、いずれかの時点で ID が変わらないことを前提にしていないかも検討してください。
- 分散生成: 一意の ID はデータ自体から生成されるため、同期や中央での調整を必要とせず、複数のプロセスが同時に一意の ID を生成できます。これにより、分散データ処理環境でのスケーラビリティとパフォーマンスが向上します。
文字列列を連結してから SHA256 ハッシュを生成することで、スケーラブルで安全かつ一貫した一意の ID を生成できるため、データパイプラインアプリケーションに最適な選択肢となります。
決定論的な一意の ID に UUID V5 を使用する
決定論的な一意の ID を生成する別の方法として、UUID V5 関数を使用できます。UUID V5 は、SHA-1 ハッシュ(RFC 4122)を使用して、名前空間 UUID と名前文字列から決定論的な UUID を生成します。同じ名前空間と名前からは常に同じ UUID が生成されるため、標準化された再現可能な識別子が必要な場合に適しています。
Pipeline Builder で UUID V5 を使って一意の ID を生成するには、次の手順を実行します。
- データドメインを表す名前空間 UUID を選択します。標準の名前空間 UUID を使用することも、独自のものを作成することもできます。
- 識別に使用する列を連結したものを名前文字列として使用します。
- 「UUID V5」式を適用して、決定論的な UUID を生成します。
この方法には、次の利点があります。
- 標準への準拠: UUID V5 は RFC 4122 に準拠しているため、生成された ID は標準の UUID を想定するほかのシステムと相互運用できます。
- 一貫性: 同じ名前空間と名前の組み合わせからは、常に同じ UUID が生成されます。
- 決定論的な生成: SHA256 と同様に、同じ入力が与えられれば、複数のプロセスが独立して同じ UUID を生成できます。
単調増加する ID の欠点
Pipeline Builder は単調増加する ID に対応していませんが、Spark に慣れているデータエンジニアはよく使用しています。単調増加する ID は、1、2、3のように順次生成されます。この方法は本質的にシンプルですが、いくつかの欠点があります。
- ビルド間の不整合: Spark で単調増加する ID を使用すると、同じアプリケーションでも実行ごとに生成される ID が変わる可能性があります。これは、Spark がエグゼキューターにタスクを割り当てる方法が変わる可能性があり、その結果、ID の割り当て順序が変わるためです。この不整合により、結果の再現、実行間の比較、インクリメンタル(差分)更新が難しくなる可能性があるため、ID 列としての信頼性は低くなります。オントロジーオブジェクトの主キーとして使用すると、ビルドのたびに完全な再インデックス化が必要になります。
- 状態への依存: 単調増加する ID を生成するには、行間で状態を保持する必要があります。
これらの欠点から、単調増加する ID の使用は、データパイプラインアプリケーションで一意の識別子を生成する最適な方法ではないことがわかります。代わりに、前のセクションで詳しく説明したように、文字列列を連結してから SHA256 ハッシュを生成する方法、または UUID V5 を使用することを推奨します。
ハッシュ化に使用できる一意の列の組み合わせがない場合
この方法では、ビルドやプレビューの間で一貫性が保たれないことに注意してください。一意の列の組み合わせを特定できない場合に限り、最後の手段として使用してください。
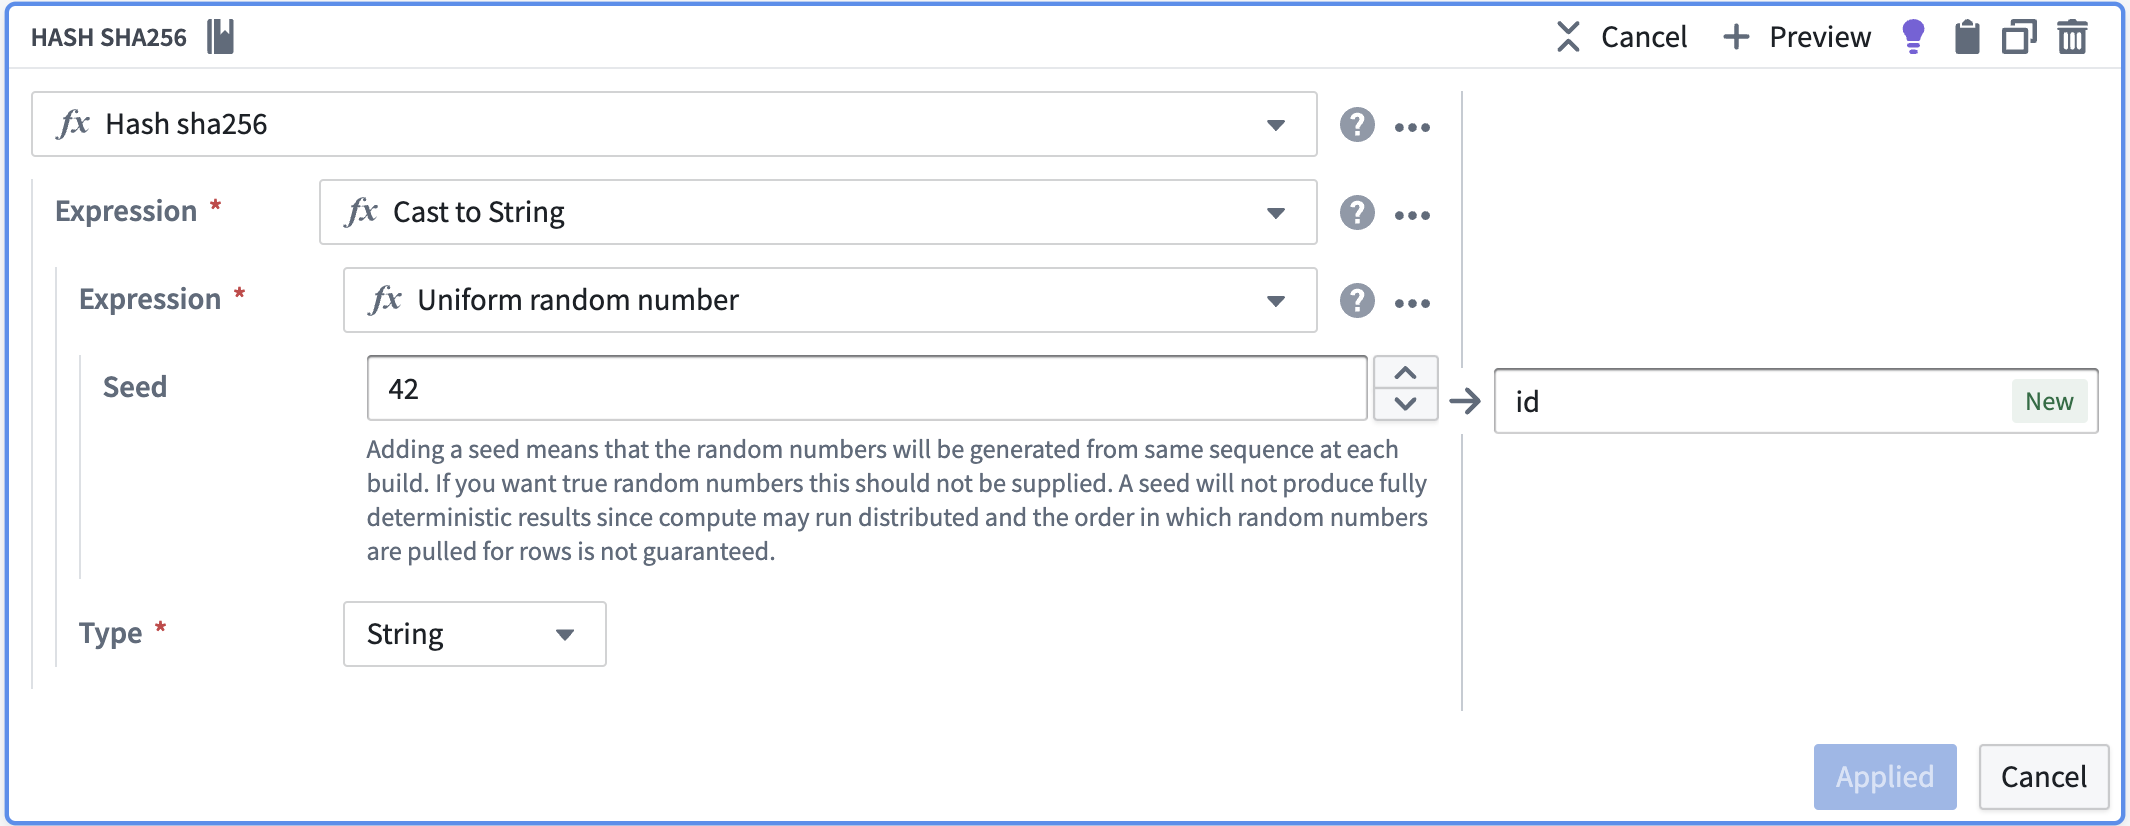
データ内で一意の行を定義する列の組み合わせがない場合は、乱数のハッシュを使って ID を作成できます。この方法で ID を作成するには、Pipeline Builder のデータ加工パス内で次の手順を実行します。
- 「Uniform random number」を使用して乱数を作成します。
- 列を文字列にキャストします。
- 「Hash sha256」を使用して、その列をハッシュ化します。