注: 以下の翻訳の正確性は検証されていません。AIPを利用して英語版の原文から機械的に翻訳されたものです。
仮想テーブル
仮想テーブルを使用すると、サポートされているデータプラットフォーム内のテーブルに、データを事前に Foundry のデータセットに保存せずにクエリできます。
仮想テーブルは、Foundry 外部のソースシステム内のテーブルへのポインターとして機能します。仮想テーブルは、基盤となるソースシステムやストレージ形式を抽象化するため、異なるソースシステムのデータをシームレスに組み合わせるワークフローを構築できます。また、仮想テーブルは、データを1か所に集約する必要のない柔軟なアーキテクチャの一部として、Foundry に保存されているデータセットと組み合わせることもできます。さらに、Foundry でのデータ変換の出力として新しい仮想テーブルを作成することもできます。これにより、ストレージを完全に外部に置き、Foundry がオーケストレーション、セキュリティ、その他の機能を担うワークフローを実現できます。

仮想テーブルは、次の要素で定義されます。
- ソースストレージシステムへの接続(たとえば、ソース URL や資格情報)。この接続は、Foundry の Data Connection アプリケーションでソースを設定することで確立されます。
- ソースシステム内のテーブルを識別するロケーター(たとえば、データベース、スキーマ、テーブル名)。
Foundry のほかのリソースと同様に、仮想テーブルも Foundry のセキュリティと権限モデルによって管理され、さまざまな Foundry アプリケーションで開いたり使用したりできます。
サポートされているソース
以下のソースは仮想テーブルをサポートしています。接続の設定方法およびサポートされている機能の詳細については、ソースのドキュメントを参照してください。
| ソース | ステータス | 対応形式 | 手動登録 | 自動登録 |
|---|---|---|---|---|
| Amazon S3 | 🟢 一般提供 | Avro ↗, Delta ↗, Iceberg ↗, Parquet ↗ | ✔️ | |
| OneLake および Azure Data Lake Storage Gen2 (Azure Blob Storage) | 🟢 一般提供 | Avro ↗, Delta ↗, Iceberg ↗, Parquet ↗ | ✔️ | |
| BigQuery | 🟢 一般提供 | テーブル、ビュー、実体化ビュー | ✔️ | ✔️ |
| Databricks | 🟢 一般提供 | テーブル、ビュー、実体化ビュー | ✔️ | ✔️ |
| Foundry | 🟡 ベータ版 | マネージド Iceberg のみ | ✔️ | |
| Google Cloud Storage | 🟢 一般提供 | Avro ↗, Delta ↗, Iceberg ↗, Parquet ↗ | ✔️ | ✔️ カタログが設定されている場合の Iceberg テーブル |
| Snowflake | 🟢 一般提供 | テーブル、ビュー、実体化ビュー | ✔️ | ✔️ |
Iceberg カタログ
Iceberg カタログは、存在する Iceberg テーブルと、各テーブルのファイルが現在保存されている場所を記録します。Apache Iceberg テーブルを元にした仮想テーブルを読み込むには、Iceberg カタログが必要です。Iceberg テーブルについて詳しくはこちら。仮想テーブルがサポートするカタログは、使用するソースによって異なります。ソース以外の各列の見出しは、Foundry がサポートする Iceberg カタログの名前です。各カタログの設定方法や、ソースの Iceberg テーブルの使用方法の詳細については、ソースのドキュメントを参照してください。
| ソース | AWS Glue | Horizon Catalog | Lakehouse | Object Storage | Polaris | Unity Catalog |
|---|---|---|---|---|---|---|
| Amazon S3 | 🟢 一般提供 | 🔴 利用不可 | 🔴 利用不可 | 🟢 一般提供 | 🟢 一般提供 | 🟡 レガシー:Databricks ソースの使用を推奨します。 |
| Databricks | - | - | - | - | - | 🟢 一般提供 |
| Google Cloud Storage | 🔴 利用不可 | 🔴 利用不可 | 🟢 一般提供 | 🟢 一般提供 | 🔴 利用不可 | 🔴 利用不可 |
| OneLake および Azure Data Lake Storage Gen2 (Azure Blob Storage) | 🔴 利用不可 | 🔴 利用不可 | 🔴 利用不可 | 🟢 一般提供 | 🟢 一般提供 | 🟡 レガシー:Databricks ソースの使用を推奨します。 |
| Snowflake | - | 🟢 一般提供 | - | - | - | - |
サポートされている Foundry ワークフロー
仮想テーブルは、以下のアプリケーションおよびワークフローでは入力として、Pipeline Builder および Code Repositories では出力としてもサポートされています。
仮想テーブルのブランチのサポートは、ソースシステムとテーブルタイプの機能、および使用する Foundry ワークフローによって異なります。Foundry に仮想テーブルを登録しても、ソースにブランチ機能が追加されるわけではありません。
Apache Iceberg のオープンなテーブル仕様にはブランチ機能が含まれています ↗が、仮想 Iceberg テーブルでのサポートは、ソースカタログの実装とサポートされている操作にも依存します。テーブルタイプごとの機能と制限事項については、ソースのドキュメントを参照してください。
コンピュートプッシュダウンを使用する場合のブランチの制限事項については、外部パイプライン:既知の制限事項を参照してください。
| 対応アプリケーション | 対応ワークフロー | 非対応 |
|---|---|---|
| Data Connection | ソースを設定する 仮想テーブルを登録する | Agent ベースの接続 |
| Contour | Contour で分析する | データセットとして保存する |
| オントロジー | Ontology Manager によるオブジェクトの作成 Pipeline Builder によるオブジェクトの作成 | |
| Data Lineage | Foundry のリネージを表示する | |
| Pipeline Builder | パイプラインの入力 パイプラインの出力 スナップショットビルド インクリメンタル(差分処理)ビルド(追加のみ) 外部パイプライン(コンピュートプッシュダウン) | ストリーミングビルド 高速パイプライン |
| Code Repositories | Python トランスフォーム Java トランスフォーム SQL トランスフォーム スナップショットビルド インクリメンタル(差分処理)ビルド(追加のみ) コンピュートプッシュダウン | 軽量トランスフォーム(Foundry コンピュート) |
| 観測可能性 | 仮想テーブルに対応するヘルスチェック Pipeline Builder でのデータが満たすべき条件 Code Repositories でのデータが満たすべき条件 | 単一ノードのトランスフォームでは、仮想テーブルの出力に対して on_error='FAIL' を設定してデータが満たすべき条件を満たさなかった場合にジョブを中止することはできません。ただし、仮想テーブルの入力、Foundry が管理する Iceberg テーブル、および Spark トランスフォーム全般では利用できます。 |
| Code Workspaces | JupyterLab® VS Code |
一部のソースタイプでは、これらの機能のすべてがサポートされているとは限りません。詳細については、ソース固有のドキュメントを参照してください。Code Repositories で仮想テーブルを使用する場合のソースの設定方法について詳しくはこちら。
一般に、仮想テーブルは、次のいずれかの方法で、Foundry の一般的なワークフローの大半の元データとして使用できます。
- 上記のように仮想テーブルを直接操作する方法、または
- 仮想テーブルを元データとして、Foundry データセットまたはオブジェクトを出力する変換パイプラインを作成する方法。これらの出力は、プラットフォームで通常どおり使用できます。
ソースおよびテーブルタイプ別の仮想テーブル互換性マトリクス
以下のマトリクスは、仮想テーブルで利用可能な主な機能を、データソースとテーブルタイプ別にまとめたものです。ソース固有の制限事項や高度な機能を含む詳細については、ソース固有のドキュメントを参照してください。
| ソース | テーブルの種類 | 機能 | Foundry コンピュート | コンピュートプッシュダウン* |
|---|---|---|---|---|
| BigQuery | テーブル、ビュー、実体化ビュー、その他 | ✅ 読み取り ✅ 書き込み | ✅ Python:単一ノード ✅ Python:Spark ❌ Pipeline Builder:単一ノード ✅ Pipeline Builder:Spark | ✅ Python (Ibis) ❌ Pipeline Builder |
| Databricks | 外部 Delta、マネージド Iceberg | ✅ 読み取り ✅ 書き込み | ✅ Python:単一ノード ✅ Python:Spark ❌ Pipeline Builder:単一ノード ✅ Pipeline Builder:Spark | ✅ Python (PySpark) ✅ Pipeline Builder |
| Databricks | マネージド Delta | ✅ 読み取り ❌ 書き込み | ✅ Python:単一ノード ✅ Python:Spark ❌ Pipeline Builder:単一ノード ✅ Pipeline Builder:Spark | ✅ Python (PySpark) ✅ Pipeline Builder |
| Databricks | ビュー、実体化ビュー、その他 | ✅ 読み取り ❌ 書き込み | ✅ Python:単一ノード ✅ Python:Spark ❌ Pipeline Builder:単一ノード ✅ Pipeline Builder:Spark | ✅ Python (PySpark) ✅ Pipeline Builder |
| Snowflake | テーブル、ビュー、実体化ビュー、その他 | ✅ 読み取り ✅ 書き込み | ✅ Python:単一ノード ✅ Python:Spark ❌ Pipeline Builder:単一ノード ✅ Pipeline Builder:Spark | ✅ Python (Snowpark) ✅ Pipeline Builder |
| Snowflake | マネージド Iceberg | ✅ 読み取り ❌ 書き込み | ❌ Python:単一ノード ✅ Python:Spark ❌ Pipeline Builder:単一ノード ✅ Pipeline Builder:Spark | ✅ Python (Snowpark) ✅ Pipeline Builder |
| AWS S3 | Parquet, Avro, CSV, Delta | ✅ 読み取り ✅ 書き込み | ❌ Python ❌ Pipeline Builder | NA |
| Azure ADLS | Parquet, Avro, CSV, Delta | ✅ 読み取り ✅ 書き込み | ❌ Python ❌ Pipeline Builder | NA |
| Google Cloud Storage | Parquet, Avro, CSV, Delta | ✅ 読み取り ✅ 書き込み | ❌ Python ❌ Pipeline Builder | NA |
| Google Cloud Storage | Lakehouse カタログ内の Iceberg テーブル | ✅ 読み取り ✅ 書き込み | ✅ Python ✅ Pipeline Builder | NA |
* コンピュートプッシュダウンとは、ソースシステムのネイティブコンピュートエンジンを使用することを指します。
仮想テーブルの接続を設定する
仮想テーブルをサポートするソースは、Data Connection アプリケーションで設定します。使用するソースを選択し、ソース設定の仮想テーブルタブに移動します。ソースのドキュメントと、そこに記載されている仮想テーブルを使用するための要件に従ってください。

仮想テーブルを作成する
サポートされているすべてのソースで、ソースシステムの個々のテーブルを Foundry に登録できます。テーブル形式のソースタイプでは、複数の仮想テーブルを一度に一括登録することもできます。一部のソースでは、さらに自動登録もサポートしています。自動登録では、設定された資格情報でアクセスできるソース内のすべてのテーブルを、指定したプロジェクトに定期的に登録します。
仮想テーブルを登録するには、ソースの仮想テーブルタブで仮想テーブルを作成を選択します。利用可能なテーブルの一覧を見て、登録するテーブルを選択します。別の場所を選択しない限り、仮想テーブルはソースのデフォルトの出力フォルダーに作成されます。

一括登録
Databricks、BigQuery、Snowflake などのテーブル形式のソースタイプを使用する場合、複数の仮想テーブルを一度に一括登録できます。まず、左側のパネルから外部テーブルを1つ以上選択します。右側のパネルでは、新しい仮想テーブルの保存先を変更したり、名前を更新したりできます。Foundry で仮想テーブルの名前を変更しても、ソース内のテーブル名は変更されません。

自動登録
自動登録を有効にすると、仮想テーブルが自動的に作成される新しい Foundry プロジェクトを作成します。このプロジェクトのフォルダー階層にはソースシステムの構造が反映され、ソースに新しいテーブルが作成されると定期的に更新されます。ソーステーブルが削除されても、プロジェクト内の関連する仮想テーブルは自動的には削除されませんが、アクセスしてもデータは読み込まれません。
自動登録を有効にするには、Foundry のプロジェクト作成権限が必要です。

このプロジェクトは Foundry によって管理され、ユーザーはプロジェクト内のリソースを手動で作成または更新できません。このプロジェクトに登録された仮想テーブルは、ほかのプロジェクトにインポートしてワークフロー開発に使用できます。
自動登録を有効にする際に、プロジェクトの権限とアクセスを設定できます。これらは、後からプロジェクトの所有者がアクセスサイドバーで管理できます。

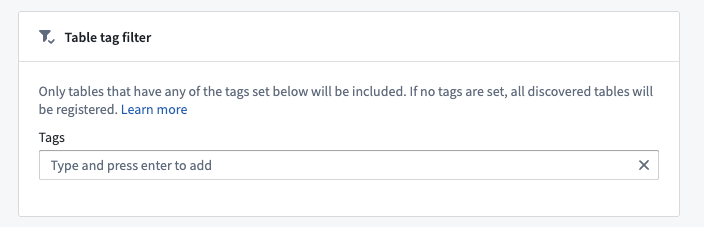
Databricks ソースのタグによる絞り込み
Databricks ソースの自動登録を設定する際に、絞り込みに使用するテーブルタグのリストを指定できます。Databricks の TABLE_TAGS ↗ システムテーブルで、これらのタグのいずれかが設定されているテーブルのみが登録されます。
Code Repositories での仮想テーブル
Code Repositories で仮想テーブルを使用すると、その仮想テーブルを入力として使用するトランスフォームには、ソースに設定されたエグレスポリシーに基づいてネットワークエグレスが自動的に付与されます。ソースに設定された資格情報は、ソースへの接続に使用できるよう必然的に公開されます。これは External Transforms と同様の動作です。
ソースで次の設定を有効にする必要があります。
- コードインポート: ソースをコードリポジトリにインポートして使用できるようにします。この設定と有効化の方法についての詳細は、こちらを参照してください。
- エクスポート制御: 仮想テーブルを使用する Python トランスフォームの入力で許可されるセキュリティマーキングと組織を制御します。この設定と有効化の方法についての詳細は、こちらを参照してください。
ソースを設定してコードリポジトリにインポートすると、transforms.api.Input を使用して、データセットと同じ方法で仮想テーブルを Python トランスフォームの入力として使用できます。インクリメンタル(差分処理)計算の API はデータセットのものと一貫しており、一部のソースでサポートされています。詳細は、ソース固有のドキュメントを参照してください。
一般に、仮想テーブルは Python、SQL、Java トランスフォームの入力としてサポートされています。トランスフォームの出力として新しい仮想テーブルを作成できるのは Python トランスフォームのみです。SQL および Java トランスフォームでは、既存の仮想テーブルへの書き込みがサポートされています。
Python トランスフォームによる新しい仮想テーブルの作成について詳しくはこちら。
仮想テーブルの詳細を表示する
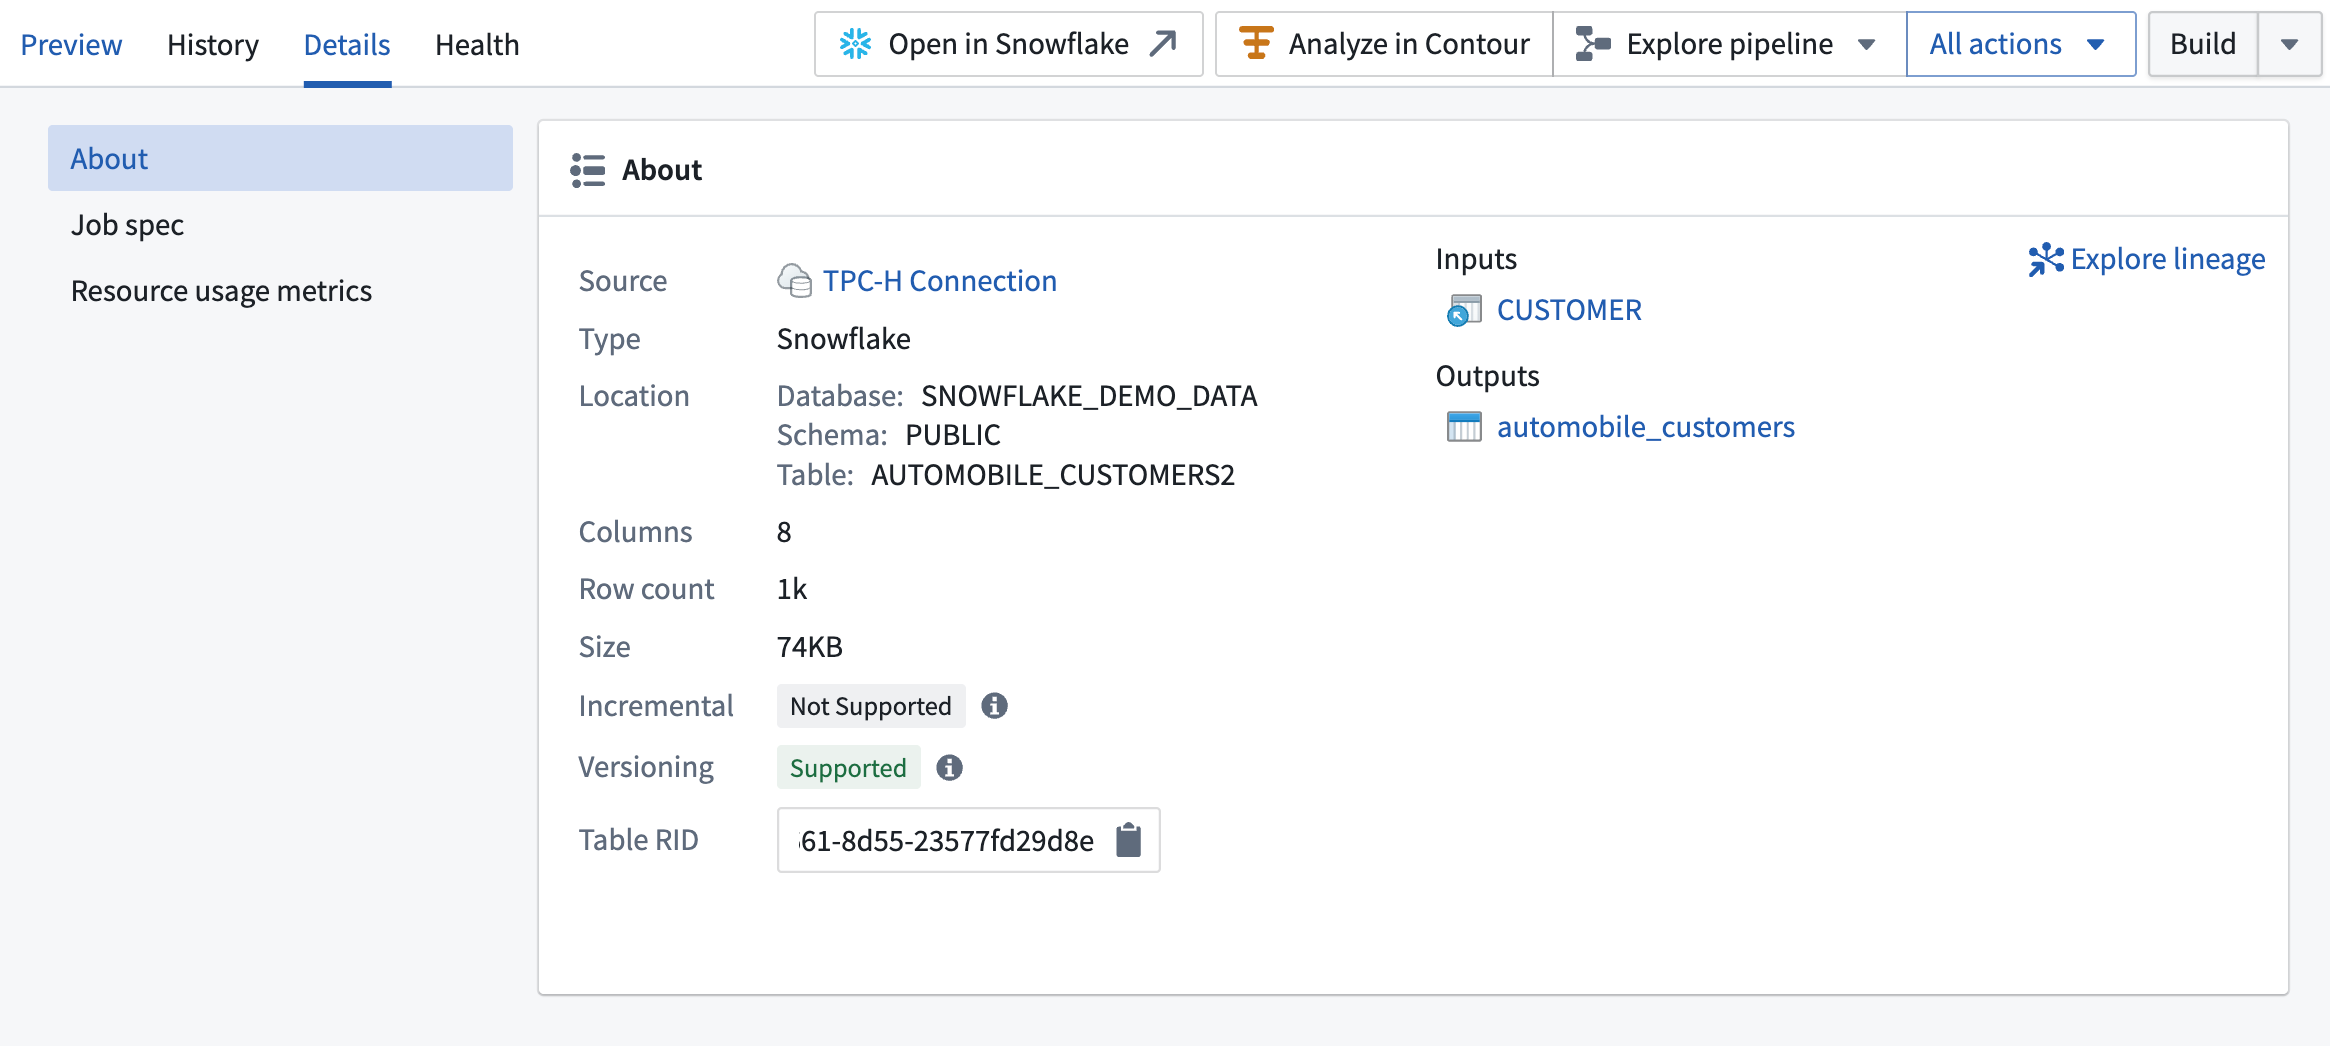
データセットプレビューの詳細パネルで、仮想テーブルに関する重要な情報を確認できます。
これには次の情報が含まれます。
- インクリメンタル: サポートされている場合、そのテーブルを使用してインクリメンタルパイプラインを設定できます。これにより、下流のビルドではすべての行を再処理するのではなく、新しいデータまたは変更されたデータのみが処理されます。
- バージョン管理: サポートされている場合、テーブルのバージョン管理機能により、Foundry は更新を検出し、データが変更されていないときは不要な下流のビルドをスキップできます。
仮想テーブル入力の更新検出
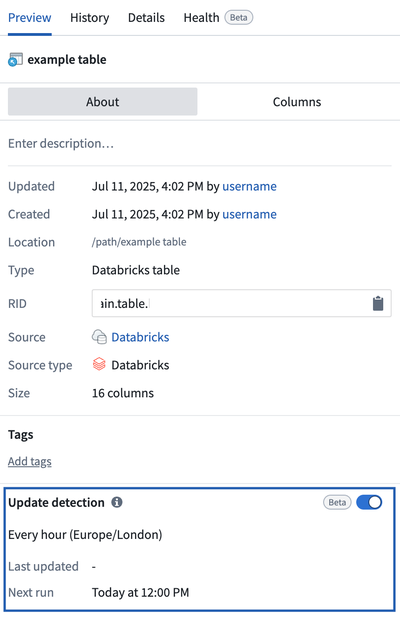
更新検出機能は仮想テーブルを監視し、ソースシステム内のテーブルの変更を検出します。これにより、パイプラインやオブジェクトなどの依存リソースのビルドトリガーとして仮想テーブルを使用できます。
更新検出は、外部で管理され、Foundry に登録されたテーブルである仮想テーブル入力を対象としています。仮想テーブル出力(Foundry パイプラインによって作成されるもの)については、Foundry がパイプラインのビルド情報を使用して更新を自動的に追跡するため、更新検出は必要ありません。
更新検出を有効にすると、Foundry はソースシステムを定期的にポーリングして、テーブルの更新を確認します。ソーステーブルの形式がバージョン管理に対応している場合(たとえば、Delta や Iceberg)、Foundry は変更を検出し、必要な場合にのみ下流のビルドをトリガーできます。バージョン管理に対応していない場合、すべてのポーリングが更新の可能性があるものとして扱われるため、不要な下流のビルドが発生する可能性があります。
仮想テーブルがバージョン管理に対応しているかどうかは、仮想テーブルの詳細を表示して確認できます。
更新検出が制御するのは、下流のビルドがいつトリガーされるかだけです。その結果実行されるビルドがスナップショットビルドかインクリメンタル(差分処理)ビルドかを決めるものではありません。バージョン管理に対応しているソースは、インクリメンタル(追加のみ)ビルドにも対応でき、この場合、Foundry は前回のビルド以降に追加された行を特定し、テーブル全体を再処理するのではなく、その新しいデータのみを処理します。仮想テーブルのインクリメンタル処理への対応は、現在、追加のみの変更に限定されており、Delta の Change Data Feed ↗ や Iceberg の Incremental Reads ↗ の有効化など、ソース固有の追加の前提条件があります。詳細については、ソース別のドキュメントを参照してください。ソースがバージョン管理に対応していない場合、その仮想テーブルに基づく下流のパイプラインではスナップショットビルドを使用する必要があり、トリガーされた実行のたびにテーブル全体が再処理されます。
更新検出を有効にする
更新検出は、下流のテーブル、データセット、オブジェクトなどのリソースの作成に仮想テーブル入力が使用されている場合にのみ利用できます。
仮想テーブル入力の更新検出を有効にするには、次の手順に従います。
- データセットプレビューで仮想テーブルを開きます。
- 左パネルの更新検出セクションに移動します。
- 更新検出を有効にし、希望するポーリングスケジュール(たとえば、毎時または毎日)を設定します。
有効にすると、下流のテーブルやデータセットのスケジュールトリガーとして仮想テーブル入力を使用できます。仮想テーブルを元にしたオブジェクトは、ソースの更新が検出されると自動的に再インデックス化されます。
仮想テーブルを元にしたオブジェクトを設定する
Ontology Manager で、仮想テーブルを直接の元データとするオブジェクトを設定できます。
元データとなる仮想テーブルが Foundry の外部で更新される場合は、オブジェクトがソースシステムから定期的に更新を受け取れるように、仮想テーブルで更新検出を有効にしてください。
仮想テーブルの使用とデータセットへの同期の比較
仮想テーブルを使用するか、Foundry データセットに同期するかは、アーキテクチャの目標と、対応する対象ワークフローによって決まります。ワークフローごとに適切な統合パターンを検討することを推奨します。この2つのアプローチを併用し、相互に補完することもできます。
仮想テーブルの使用とデータセットへのデータ同期について、考えられる利点、欠点、制限事項に関する考慮事項を以下に示します。
仮想テーブルを使用する利点
仮想テーブルには、次のような利点があります。
- ソースデータを Foundry に保存しないため、重複するストレージを削減できます。ただし、Foundry パイプラインから出力されるデータセットやオブジェクトなど、下流で作成されるリソースのデータは引き続き Foundry に保存されます。
- クエリをソースシステムにプッシュダウンして、データ転送の総量を抑えられます。コンピュートプッシュダウンを利用できるかどうかは、ソースシステムとクエリの種類によって異なります。
- 重複するストレージのコストが大きくなる非常に大きなテーブルでは、仮想テーブルが特に有益な場合があります。
- 仮想テーブルでは、使用時にデータが直接クエリされるため、データを同期したり、データの鮮度が低下する可能性を考慮したりする必要がありません。
- 仮想テーブルは、Foundry の実装を対象のアーキテクチャパターンに合わせるための選択肢を提供します。
仮想テーブルを使用する欠点
仮想テーブルがあらゆる状況で最適な選択肢になるとは限りません。考慮事項には、次のようなものがあります。
- Foundry データセットに保存されたデータを使用する場合と比べて、対話型操作のパフォーマンスが低下する可能性があります。
- 仮想テーブルに対して実行するクエリの種類によっては、コンピュート使用量が増加する可能性があります。たとえば、スケジュールされたパイプラインへの入力として使用するテーブルでは、Contour の分析で頻繁に対話型アクセスを行うテーブルと比べて、コンピュート使用量が少なくなる場合があります。
- 仮想テーブルでは、データセットのバージョン管理やブランチなどの Foundry データセットの機能を利用できません。
仮想テーブルを使用する際の制限事項
仮想テーブルには、次の制限事項があります。
- すべてのソースで仮想テーブルを利用できるわけではありません。
- 仮想テーブルには、Foundry ワーカーを使用するソースと、直接接続のエグレスポリシーが必要です。
- セルフサービスのプライベートリンクエグレスポリシーを使用する接続は、通常、サポートされていません。ただし、Palantir の担当者が設定したプライベートリンクはサポートされています。
- Agent プロキシポリシーを使用する接続はサポートされていません。
- バケットエンドポイントのエグレスポリシーを使用する接続はサポートされていません。
- Agent ワーカーを使用する接続はサポートされていません。
- Foundry のすべてのアプリケーションや機能が、仮想テーブルを入力として使用することに対応しているわけではありません。ただし、仮想テーブルの下流で作成される実体化されたリソース(パイプラインから出力されるデータセットやオブジェクトなど)は、通常どおり Foundry エコシステム全体で完全にサポートされています。
use_external_systemsデコレーターを使用するトランスフォームは、現在、仮想テーブルに対応していません。ソースベースの external_transforms に切り替えるか、トランスフォームを、仮想テーブルを入力として使用するものとuse_external_systemsデコレーターを使用するものに分割してください。
仮想テーブルに対するクエリのコンピュート
仮想テーブルに対して直接実行されるクエリでは、コンピュートが Foundry とソースシステムに分散される場合があります。具体的な動作は、クエリと、ソースシステムが対応しているプッシュダウン計算の範囲によって異なります。詳細については、ソース別のドキュメントを参照してください。