注: 以下の翻訳の正確性は検証されていません。AIPを利用して英語版の原文から機械的に翻訳されたものです。
Spark の概念
Spark 入門
Spark とは?
Spark は、Foundry 内で大規模なデータ変換を実行するために使用される分散コンピューティングシステムです。もともとはカリフォルニア大学バークレー校の研究者チームによって開発され、その後2000年代後半に Apache Foundation に寄贈されました。Foundry では、Spark を基盤となる計算レイヤーとして使用し、大量のデータに対して SQL、Python、Java、Mesa のトランスフォームを実行できます(Mesa は Java ベースの独自 DSL です)。
Spark はどのように動作しますか?
Spark は、多数のコンピューターにジョブを同時に分散してデータを処理します。Hadoop が使用するディスクベースの2段階 MapReduce モデルとは異なり、Spark は有向非巡回グラフ(DAG)実行エンジンを使用し、インメモリー計算を優先するため、ユーザーやプロジェクトをまたいで同時に実行されるジョブを高速に処理できます。これらのコンピューターは、ドライバーとエグゼキューターに分かれています。
- ドライバーは、Spark ジョブの「指揮者」のような役割を果たします。ドライバーは、ジョブの作業をエグゼキューターに分配します。
- エグゼキューターは、Spark ジョブの「働き蜂」のような役割を果たします。エグゼキューターは、ドライバーから割り当てられたジョブの一部について計算を実行します。この作業は複数の「パーティション」に分割され、各エグゼキューターには、コードを実行する対象となるパーティションがいくつか割り当てられます。エグゼキューターはこのタスクを完了するとドライバーに戻り、ジョブが完了するまで追加の作業を要求します。
- すべての Spark ジョブには、トランスフォームの実行に最適な Spark プロファイルを作成するために調整できる変数がいくつかあります。
- どの Spark ジョブでも、ジョブを迅速かつ容易に実行することと、実行に伴うコストやリソースとの間でバランスを取る必要があります。
- 一般的な目安として、エグゼキューター数やメモリーを増やすと、実行時間は短くなる一方で、コストも増加すると考えられます。
- ジョブの特性によって、ドライバーとエグゼキューターの組み合わせや設定の中には、ほかよりも高いパフォーマンスを発揮するものがあります。詳細は、Spark プロファイルを調整するのセクションで説明します。
- Spark プロファイルは、Foundry が上記の分散計算リソース(ドライバーとエグゼキューター)に適切な数の CPU コアと適切な量のメモリーを割り当てるために使用する設定です。
- すべての Spark ジョブには、設定可能な変数が5個あります。
- ドライバーのコア数: Spark ドライバーに割り当てる CPU コア数を制御します。
- ドライバーのメモリー: Spark ドライバーに割り当てるメモリー量を制御します。
- 制御されるのは JVM メモリーのみです。これには、Spark 以外の外部タスク(Python ライブラリーの呼び出しなど)に必要な「オフヒープ」メモリーは含まれません。
- エグゼキューターのコア数: 各 Spark エグゼキューターに割り当てる CPU コア数を制御します。これにより、各エグゼキューターで同時に実行されるタスク数も制御されます。
- エグゼキューターのメモリー: 各 Spark エグゼキューターに割り当てるメモリー量を制御します。
- このメモリーは、エグゼキューター上で実行されるすべてのタスクで共有されます。
- エグゼキューター数: ジョブの実行のために要求するエグゼキューター数を制御します。
- 組み込みの Spark プロファイルの一覧は、Spark プロファイルリファレンスで確認できます。

Spark プロファイルを調整する
- トランスフォームの実行時に問題が発生し、対象のジョブを実行できるように Spark プロファイルを調整して、デフォルトとは異なるカスタム設定を作成する必要が生じる場合があります。たとえば、次のような場合です。
- ジョブにより多くのメモリーが必要な場合。
- ユースケースで求められる速度よりジョブの実行が遅い場合。
- ジョブ全体の失敗につながるエラーが発生する場合。
- Code Repositories でデフォルト以外の Spark プロファイルを使用するには、まずトランスフォームを含むリポジトリにプロファイルをインポートする必要があります。この手順は、Spark プロファイルの使用に関するドキュメントで説明されています。
- インポート後は、トランスフォームプロファイルを適用するドキュメントの手順に従って、Spark プロファイルを特定のトランスフォームに割り当てることができます。
- Pipeline Builder のバッチパイプラインで使用する Spark プロファイルは、パイプラインのビルド設定で制御します。
Spark プロファイルをデフォルトから変更するタイミング
- Spark プロファイルを編集する際の目安として、1回に増やす変数は1個だけにし、毎回1段階だけ引き上げてください。
- たとえば、まずエグゼキューターのメモリーだけを調整し、
EXECUTOR_MEMORY_SMALLからEXECUTOR_MEMORY_MEDIUMに引き上げてから、ほかの設定を調整する前にジョブを再実行します。これにより、ジョブにリソースを過剰に割り当てて不要なコストが発生するのを防ぎやすくなります。
- たとえば、まずエグゼキューターのメモリーだけを調整し、
- バックエンドのデフォルト設定は、必ずしも特定の Spark プロファイルに対応するわけではありませんが、通常は
SMALLというラベルの付いた組み込みプロファイルで近似できます。- 適切なデフォルト設定(Python 以外のトランスフォームの場合)は、
EXECUTOR_CORES_SMALL、EXECUTOR_MEMORY_SMALL、DRIVER_CORES_SMALL、DRIVER_MEMORY_SMALL、NUM_EXECUTORS_2です。 - Python では、JVM 外で実行される Python ライブラリを呼び出す際に、JVM 外のオーバーヘッド用メモリーがより多く必要になる場合があります。
- 適切なデフォルト設定(Python 以外のトランスフォームの場合)は、
- Spark ジョブで何らかの問題が発生している場合は、まずコードを最適化します。
- 可能な限り最適化しても問題が解消しない場合は、以下の具体的な推奨事項を参照してください。
- ジョブの実行には成功するものの、ユースケースで求められる速度より遅い場合:
- エグゼキューターの数を増やしてみます。エグゼキューターの数を増やすと、並列で実行できるタスク数が増えるため、ジョブに十分な並列性があればパフォーマンスが向上します。ただし、使用するリソースが増えるため、コストも増加します。
- 対象のビルドの Builds アプリケーションページを表示すると、エグゼキューターの数を増やすことでジョブの速度が向上するかどうかを判断するのに役立つグラフを確認できます。タスクの同時実行数がエグゼキューターの数に近づいていない場合、エグゼキューターの数を増やしても実行時間はほとんど改善しないと考えられます。
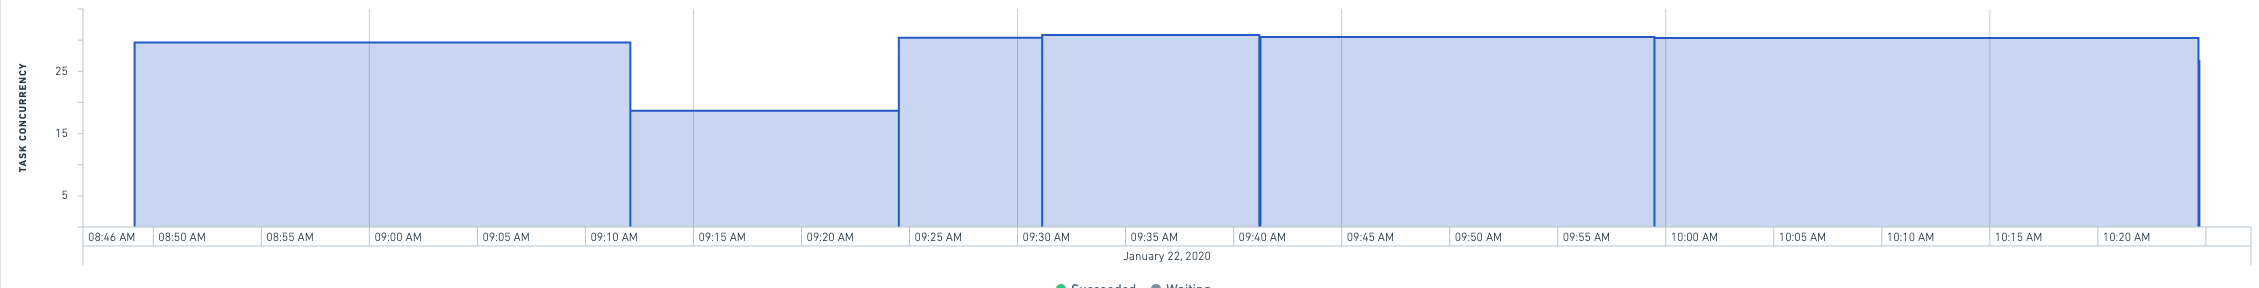
- エグゼキューターの数を2倍にしても実行時間が1/3を超えて短縮されない場合は、コードが非効率である可能性があります(たとえば、Catalog からの読み取りや Catalog への書き込みが多い場合)。
- たとえば、6分かかるジョブを生成するトランスフォームでエグゼキューターの数を2倍にした場合、ジョブは4分以内に実行されるはずです。
- エグゼキューターの数を半分にしてもジョブの実行時間の増加が50%未満(たとえば、4分から6分)であれば、実行時間が極めて重要でない限り、コストを節約するためにエグゼキューターの数を少ない方に減らすべきです。
- 承認されたユースケースだけが大量のリソースを使用できるように、大規模なプロファイル(エグゼキューターが128個以上など)には制限が設けられる場合があります。制限に達して、さらに引き上げる必要がある場合は、Palantir の担当者にお問い合わせください。
- 起動時には、通常、1分あたり約10個のエグゼキューターがドライバーに追加されます。そのため、エグゼキューターの数が多く、実行時間が短いジョブでは、システムのスラッシングを減らすためにエグゼキューターの数を減らすのがよいと考えられます。たとえば、エグゼキューターを64個使用する10分未満のジョブは、エグゼキューターを32個に減らすのがよいと考えられます。必要なコンピューティングリソースがすべて確保される頃には、ジョブがほぼ終了しているためです。
- エグゼキューターの数を増やしてみます。エグゼキューターの数を増やすと、並列で実行できるタスク数が増えるため、ジョブに十分な並列性があればパフォーマンスが向上します。ただし、使用するリソースが増えるため、コストも増加します。
- ジョブの実行に失敗し、OOM(メモリー不足)エラー、またはコードのロジックに起因する失敗とは関係のない「Shuffle stage failed」エラーが発生している場合:
- エグゼキューターのメモリーを
SMALLからMEDIUMに増やしてみます。大量のデータを処理している場合は、これで改善するはずです。MEDIUMからLARGEへの調整が必要だと考えられる場合は、専門家に相談してください。可能であれば、トラブルシューティングガイドに記載されているように、トランスフォームの簡略化を検討してください。
- エグゼキューターのメモリーを
- 大量のデータをドライバーに収集して戻す場合、または大規模なブロードキャスト結合を実行する場合:
- ドライバーのメモリーを増やしてみます。
- 「Spark module stopped responding」のようなエラーが表示され、入力データセットに多数のファイルがある場合:
- まずドライバーのメモリーを増やしてみます。
- ドライバーのメモリーを増やしてもエラーが解消しない場合は、ドライバーのコア数を2に増やします。
- 多数のファイルを読み取るトランスフォームで GC(ガベージコレクション)の問題が発生する場合:
- ドライバーのコア数を2に増やしてみます。
推奨されるベストプラクティス
管理者向け
- ユースケースが終了したら、そのユースケース用に作成したカスタムプロファイルをすべて削除します。
- これにより、煩雑さが軽減され、カスタムプロファイルが増えすぎて混乱を招くのを防げます。
- リソースを大量に使用するプロファイルは、管理者が明示的に権限を付与した後にのみアクセスできるように権限を設定します。
- たとえば、
NUM_EXECUTORS_32とEXECUTOR_MEMORY_LARGE(およびそれ以上)は、申請とその申請の承認を経た場合にのみ利用可能にすべきです。 EXECUTOR_CORES_SMALLを除くすべてのエグゼキューターのコア数の値は、厳格に管理すべきです(これはコンピューティング能力を「目立たない形で」増やす方法であり、ほぼすべての場合に、ユーザーをNUM_EXECUTORSプロファイルへ誘導する方が望ましいためです)。
- たとえば、
Spark プロファイルの調整について
- 可能な限り、デフォルトのプロファイル(つまり、プロファイルなし)を使用するようにします。
- これにより、コストと煩雑さを軽減できます。
- デフォルトのプロファイルを使用できない場合は、組み込みプロファイルを使用するようにします。
- 新しいプロファイル設定を作成する際は、ご自身の名前またはユースケースの名前を付けて保存します。
- これにより、整理しやすくなるとともに、このプロファイルが知らないうちにほかのユーザーやプロジェクトで使用されるのを防げます。
- そうしないと、どのプロファイルがどの用途で設定されたのかわからないまま、プロファイルの一覧が増えすぎる場合があります。
- メモリーを増やす場合、リソースの比率が8:1(
EXECUTOR_CORES_SMALLとEXECUTOR_MEMORY_MEDIUMの組み合わせで示される比率)を超える設定は、管理者の承認を必要とすべきです。EXECUTOR_CORES_EXTRA_SMALLとEXECUTOR_MEMORY_LARGEは使用できないようにしてください。ユーザーがこれらを要求する場合、通常は最適化が不十分であるか、重要なワークフローであることを示しています。 - プロファイルは分離可能にすべきです。各プロファイルが影響するのは、1個の Spark 変数(または Spark 変数の1つの論理的な組み合わせ)だけにすべきです。
- たとえば、新しいプロファイルを作成する際は、エグゼキューターの数だけを変更し、エグゼキューターのメモリーやドライバーのメモリーなど、ほかの変数を同時に変更せずに試します。
- 同じ Spark モジュールで多数の Spark ジョブが同時に実行されるような特殊な場合を除き、ドライバーのコア数のデフォルト設定は上書きすべきではありません。
- エグゼキューターのコア数のデフォルト設定を上書きするのは、まれな場合に限るべきです。
- 実行時間が15分未満のジョブで、エグゼキューターを64個使用すべきではありません。
- これほど多くのエグゼキューターを使用すると、その時間の大半が単に立ち上がりに費やされます。
- カスタムプロファイルを作成して実行した際は、必ず実行後に Spark の詳細でパフォーマンスを確認します。
- Spark の詳細では、ジョブの実行速度を追跡し、同時実行されるジョブの詳細を確認できます。