注: 以下の翻訳の正確性は検証されていません。AIPを利用して英語版の原文から機械的に翻訳されたものです。
Spark の最適化
このページでは、Spark パイプラインを最適化するための戦略とベストプラクティスを説明します。Palantir プラットフォームで効率的なパイプラインを構築するための基本的な概念と高度な概念の両方を扱います。
基本的な最適化
Spark の基本的な最適化は、次の3つの主要な原則に基づきます。
| 概念 | 説明 |
|---|---|
| データ量を減らす | 不要な行を早い段階で除外し、使用しない列を削除します。フィルター式はシンプルかつ具体的にします。 |
| パーティションを再分割する | ファイルやパーティションの分割方法を調整して、パーティション数とエグゼキューター数のバランスを取ります。 |
| データをクレンジングする | 処理前に値を標準化します。たとえば、Spark と spark の大文字と小文字の表記を統一します。Spark は、大文字と小文字が異なる文字列を別の値として扱います。 |
データ量を減らす
Spark のパフォーマンスを向上させる簡単な方法は、不要なデータをできるだけ早い段階で削除することです。次の2つの手法が役立ちます。
- フィルター、並べ替えのステップ、内部結合がより早い段階で実行されるように、操作を並べ替えます。
- 下流のロジックで必要としない列を削除します。
Spark は、記述されたとおりに操作を実行します。予期しない動作を避けるために、データがクレンジングおよび標準化されており、フィルターが正確な値を対象にしていることを確認してください。
Parquet メタデータに基づく分割や並べ替え(Spark が自動的に適用します)が下流のパフォーマンスに効果をもたらすのは、入力データがすでにクレンジングされ、絞り込まれている場合に限られます。
同等の DataFrame API メソッドの代わりにユーザー定義関数(UDF)を使用するフィルターも非効率です。代わりに組み込みのメソッドを使用します。
データ量を減らすことが重要な理由
早い段階での絞り込みと未使用の列の削除により、各タスクが実行するネットワーク I/O とディスク I/O が減り、ジョブ全体の実行時間が短縮されます。
操作の順序は重要です。 不要なデータの削除を後のステージまで延期すると、Spark はそれ以前のすべてのステージでそのデータを処理します。最初に削除することで、そのオーバーヘッドをなくせます。コストベースのオプティマイザーを有効にすると、この並べ替えが自動的に行われます。
たとえば、D がデータセット SMALL および BIG と内部結合するデータセットである場合、次のクエリは、
Copied!1SELECT * FROM D JOIN SMALL ON SMALL.key = D.key JOIN BIG ON BIG.key2 = D.key2
次のクエリよりも高いパフォーマンスを発揮します。
Copied!1SELECT * FROM D JOIN BIG ON BIG.key2 = D.key2 JOIN SMALL ON SMALL.key = D.key
D、BIG、SMALL の列を制限すると、パフォーマンスがさらに向上します。Spark は SMALL と BIG のサイズを認識している場合、大きい方のデータセットを自動的にその場に保持しようとします。
ブラインド最適化
ブラインド最適化は、具体的な操作にかかわらず Spark のパフォーマンスを向上させることを目指します。一般的な目標は、入力分割数をエグゼキューター数に合わせることです。適切なエグゼキューター数は、利用可能なリソースとワークロードによって異なります。
分割数には、次の概算を使用します。
| 構造 | 分割数 |
|---|---|
| 入力ファイルが分割に対応しており、パーティション分割されていない | 分割数 = エグゼキューター数 = (ファイルサイズ / HDFS ブロックサイズ) |
| 入力ファイルが分割に対応しており、パーティション分割されている | 分割数 = エグゼキューター数 = パーティション数 |
| 入力ファイルが分割に対応していない | 分割数 = エグゼキューター数 = 入力ファイル数 |
最後のケースでは、入力ファイルが分割に対応していないため、Spark はファイルを処理する前に、そのファイルを構成するすべてのブロックを取得する必要があります。そのため、読み取りのオーバーヘッドは、BLOCK_SIZE 未満の単一ファイルを読み取る場合よりも大きくなります。
最悪の場合、ブラインド最適化によって、ノードが処理できる量を超えるデータがそのノードに割り当てられ、ジョブが中止されることがあります。その場合は、タスク数を増やします。結合キーが複数の行と一致する場合、結合によって入力データセットの合計よりも大きい出力が生成されることがある点に注意してください。入力分割数をエグゼキューター数に合わせると、集計や結合の際にも問題が発生することがあります。これらの操作によって、利用可能なメモリーを超えるグループが生成される可能性があるためです。
実行される操作がわかっている場合は、その操作を考慮した最適化を適用できます。これにより、パーティション(または入力分割)の数を制御して、計算中のシャッフルを減らせます。操作を考慮した最適化には、1)バケット化と2)パーティション分割の2つがあります。
データをクレンジングする
Spark は文字列の内容から意図を推測しません。内部では、Spark は一意の文字列をそれぞれ数値識別子に変換し、大文字と小文字の違いを含め、文字列に少しでも違いがあると別の識別子を生成します。たとえば、Spark は 'filter' にある整数を、'Filter' には別の整数を割り当てるため、両方が同じ値を表していると認識できません。この問題を避けるには、文字列のフィルターで大文字と小文字を区別し(たとえば、'filter' と 'Filter' の両方を対象に絞り込む)、処理前にデータをクレンジングします(たとえば、すべての表記のバリエーションを余分な文字のない一貫した大文字と小文字の表記に正規化する)。
高度な最適化
上記の基本的な方法は、すべてのパイプラインで実施すべき最低限の手順です。それだけでは不十分な場合、このセクションの手法が役立ちます。高度な最適化では、次の4つの目標を指針とします。
- 複数のエグゼキューターにデータを均等に、または適切なキーに基づいて分散します(パーティション分割)。
- タスクの入力を、エグゼキューターのメモリーに収まるサイズに抑えます。
- ネットワーク I/O とディスク I/O を削減します。そのためにはファイル数を制限します。
- タスクごとにスケジューリングのオーバーヘッドが発生するため、タスク数を削減します。
これらの目標に対応するデータの書式設定方法は7つあります。どの方法を適用するかは、ワークロードと優先事項によって異なります。
| 方法 | 別称 | 説明 | 影響を受けるステップ | 使用する場合 | 使用しない場合 |
|---|---|---|---|---|---|
| 基本的なパーティション分割:Coalesce | Coalesce、パーティション数の変更、DataFrame のパーティション分割、データの書式設定、再パーティション分割 | タスク間のパーティション数を減らし、タスクの総数を削減します。 | ステップ2(RDD からエグゼキューター) | タスクの完了後に、出力パーティション数を減らしたい場合。 | タスクによってデータ量が大きく変わらない場合。 |
| 基本的なパーティション分割:値による再パーティション分割 | Repartition、DataFrame のパーティション分割、データの書式設定、キーによるパーティション分割 | 計算後に、特定の列の値(たとえば、名前や ID)に基づいて行を新しいパーティションに再分散します。 | ステップ2(RDD からエグゼキューター) | パーティション列の異なる値の数が少ない場合(低カーディナリティ)。 | パーティション列の異なる値の数が多い場合(おおむね1,000より大きい場合)。 |
| ハッシュパーティション分割 | バケット化(および並べ替え) | メタデータに基づいて、RDD 内に並べ替え済みのパーティションを作成します。出力ファイルには、値の名前ではなくバケット識別子(output.bucket1.parquet)を使用します。 | ステップ3(エグゼキューターから出力ファイル) | 下流の計算で行のキーを照合する場合(集計、結合)、または事前の並べ替えが複数のユースケースで有益な場合。 | 下流での明確な利点がない場合。バケット化は、具体的なパフォーマンス目標がある場合にのみ使用してください。 |
| Hive パーティション分割 | 動的パーティション分割、パーティション分割 | 計算後に、パーティションキーに基づいて結果を出力ファイルに分割し、キーの値ごとに命名したサブディレクトリに保存します。 | ステップ3(エグゼキューターから出力ファイル) | 低カーディナリティの列があり、フィルターによるプルーニングが大きな効果をもたらす大規模なデータセットの場合。 | 小さなファイルが多くなりすぎる場合。 |
| 結合と集計 | — | 結合または集計したデータセットを実体化し、下流のトランスフォームやサービスが結合を再計算せずに再利用できるようにします。 | 該当なし | 下流の複数の利用先で、これらのデータセットを繰り返し結合する場合(たとえば、Contour 内)。 | 絞り込み前の結合済みデータセットが大きすぎる場合、または結合の実行頻度が低く、パイプラインのステップを追加すると全体のパフォーマンスが低下する場合。 |
| トランスフォームを分割する | — | 1個のトランスフォームを複数のトランスフォームに分割し、中間ステップを分離します。 | 該当なし | ほかの手法で改善できなかった場合、ステップを分離するとデバッグや管理が容易になる場合、または中間状態を保存する必要がある場合。 | 上記の手法ですでに十分なパフォーマンスが得られている場合。 |
| リソースを増やす | — | トランスフォームに追加の Foundry リソースを割り当てます。1個のトランスフォームのリソースを増やすと、クラスターの負荷が増し、ほかのサービスのパフォーマンスが低下する可能性があります。 | すべてのステップ | ほかのオプションでは許容できるパフォーマンスが得られず、緊急の必要がある場合にのみ、最後の手段として使用します。 | それ以外のすべての場合。 |
基本的なパーティション分割:Coalesce(パーティション数の変更)
Coalesce は、目標のパーティション数を受け取り、1つのタスク内で複数の入力パーティションを順次処理します。
利点:Coalesce は、おおむね適切に分散された大量のデータ(たとえば、テラバイト規模)に対して効果的です。クラスター全体にデータを再分散するコストを回避できます。
欠点:Coalesce はデータを再分散しないため、出力タスクのサイズに偏りが残る可能性があります。
Copied!1df.coalesce(N);
Copied!1df.coalesce(N)
SQL はこの操作に対応していません。
基本的なパーティション分割:値による再パーティション分割
値による再パーティション分割は Coalesce に似ていますが、各行をハッシュ化し、クラスター全体にデータを均等に再分散します。
利点:データが均等に分散されるため、ファイルサイズがより予測しやすくなります。
欠点:Spark はデータセットを一時作業領域に書き込み、ネットワーク経由で転送します。このコストはデータセットのサイズに応じて増加するため、再分散のオーバーヘッドが利点を上回る場合は、大規模なデータセットの再パーティション分割を避けてください。
Copied!1df.repartition(N);
Copied!1df.repartition(N)
SQL はこの操作に対応していません。
SparkSQL では、指定した列に基づいて再パーティション分割することもできます。この場合、行全体ではなく、指定した列をハッシュ化します。この手法については、後のセクションで説明します。列に基づく再パーティション分割の情報は、Spark クエリプランナーが出力ファイルを読み込む際に伝達されません。
Copied!1df.repartition(N, "column1");
Copied!1df.repartition(N, "column1")
Copied!1DISTRIBUTE BY column1
ハッシュパーティション分割(バケッティングと並べ替え)
上記の基本的なパーティション分割方法は、パイプラインのパフォーマンスを改善するために最初に試す手法です。ただし、Palantir は全体で SparkSQL を使用しているため、SparkSQL のクエリプランナーにとって有利な形式でデータセットを書き込むことで、さらに最適化できます。SparkSQL では、データセットのパーティション分割方法と各パーティション内の並べ替え順序を記述したメタデータを書き込めます。このメタデータを使用することで、下流のコストの高い処理を省略できます。これを実現する方法は、1)バケッティング(および並べ替え)と2)Hive パーティション分割の2つです。
バケッティングは、キーごとに行をグループ化して出力ファイルにまとめます。これにより、行間でキーを照合する計算(結合、グループ化処理)が高速化されます。入力が複数ある場合は、最良の結果を得るために、そのすべてをバケッティングします。バケッティングはパーティション分割に似ていますが、パーティションごとに単一の値ではなく複数の値を配置します。適切なバケット数を選ぶには、いくつかの制約を考慮してバランスを取る必要があります。目標は、次の条件を満たすファイルを作成することです。
- ノードの容量を超えず(クラッシュを避けるため)、各ノードに収まる(利用可能なスペースを使用するため)
- HDFS のブロックサイズ以上である
- パーティション、タスク、エグゼキューターの一対一の原則に従う(前述の制約と矛盾する場合を除く)
バケッティングと並べ替えは大規模なデータセットに有効ですが、適用する前にデータの分布を理解するか、制御する必要があります。バケッティングだけでも効果がありますが、バケッティングと並べ替えを組み合わせると最良の結果が得られます。
一般的には、出力ファイル(バケット)のサイズを 128–512 MB にすることを推奨します。大規模な結合を数多く実行する場合は、この目標値を調整する必要があるかもしれません。
入力パーティションが 128 MB であっても、計算によってデータが増大することがあります。128 MB の入力パーティションから、512 MB の出力ファイルが生成される場合があります。
SparkSQL でバケッティングする
CREATE TABLE を使用する SQL 文は、以下で説明するバケッティングと並べ替えの処理を含め、Code Workbook では実行できません。SQL でバケッティングするには、コードリポジトリで以下の構文を使用します。
Copied!1 2 3 4 5 6 7 8CREATE TABLE `/path/to/output` USING parquet CLUSTERED BY (a) SORTED BY (a) INTO 200 BUCKETS AS ( SELECT a, b, c FROM `/path/to/dataset` CLUSTER BY a )
上記のクエリでは、それぞれ異なる目的を持つ2つの SQL コマンドを使用しています。
CLUSTERED BY(およびSORTED BY)は、CREATE TABLE文を変更してテーブルの物理レイアウトを指定します。これらのキーワードは、個別のファイルへの実際のバケッティングを制御します。CLUSTER BYは、シャッフルを発生させるデータ処理であり、クラスター内のタスクが指定されたキーでデータをグループ化するようにします。各 Spark タスクとエグゼキューターは独立して動作するため、通常、このステップが必要です。CLUSTER BYがない場合、各タスクは自身のエグゼキューターのメモリー内にあるデータのみをバケッティングします。
例:CLUSTER BY が重要な理由
最終タスクが200個あり、200通りの値を持つキーでバケッティングする場合を考えます。CLUSTER BY がない場合、その200個の値は200個のタスクすべてに均等に分散します。各タスクは、処理するキーの値ごとに1個のファイルを作成するため、200 × 200 = 40,000個のファイルが生成されます。このファイル数によって、パイプラインの次のステップでの読み取りオーバーヘッドが急増します。
各タスクが、バケッティングキーとほぼ一対一の関係にあるデータをすでに保持していることがわかっている場合(たとえば、GROUP BY の後)は、CLUSTER BY を省略できます。省略するとシャッフルを1回減らせますが、出力ファイル数を注意深く監視してください。
注: Spark の SQL インターフェースでは、必ずしも期待される結果(バケットごとに1個のファイル)が生成されるわけではありません。SQL を調整しても目的の出力を実現できない場合は、代わりに Python を使用してください。
numPartitions は出力ファイル数を制御します。shuffle パラメーターは、ファイル間でデータを強制的に再分散します。入力がすでに適切に分散している場合は、パフォーマンスを改善するために shuffle を false に設定します。入力に偏りがある場合、または変換によって偏りが生じる場合(たとえば、一部の入力ファイル内の行にしか一致しないフィルター)は、shuffle を true に設定します。
Python では、シャッフルあり/なしのオプションに対応する2つのメソッドがあります。シャッフルなしに相当するメソッド(shuffle: false)は、次のとおりです。
Copied!1df.coalesce(N)
シャッフルありに相当するメソッド(shuffle: true)は、次のとおりです。
Copied!1df.repartition(N)
例:請求データセットをバケッティングする
claims データセットがあり、分析の大部分が、特定の patient_id に対するウィンドウ関数、参照データを取り込むための patient_id での結合、または集計であるとします。
デフォルトでは、次のクエリは、
Copied!1SELECT claims.patient_id, age FROM claims LEFT JOIN patients on claims.patient_id = patients.patient_id
次の物理プランを生成します。
Copied!1== Physical Plan ==*Project [patient_id#50, age#52]+- SortMergeJoin [patient_id#50], [patient_id#51], LeftOuter:- *Sort [patient_id#50 ASC NULLS FIRST], false, 0: +- Exchange hashpartitioning(patient_id#50, 200): +- *FileScan parquet default.claims[patient_id#50] Batched: true, Format: Parquet, Location: InMemoryFileIndex[file:/Volumes/git/spark/spark-warehouse/claims], PartitionFilters: [], PushedFilters: [], ReadSchema: struct<patient_id:string>+- *Sort [patient_id#51 ASC NULLS FIRST], false, 0+- Exchange hashpartitioning(patient_id#51, 200)+- *FileScan parquet default.patients[patient_id#51,age#52] Batched: true, Format: Parquet, Location: InMemoryFileIndex[file:/Volumes/git/spark/spark-warehouse/patients], PartitionFilters: [], PushedFilters: [], ReadSchema: struct<patient_id:string,age:int>
各 FileScan の後にある Exchange は、Spark がテーブルを patient_id でシャッフルして200個のパーティションに分け、各パーティションを patient_id で並べ替えてから、SortMergeJoin を実行することを示しています。請求データが 100 GB、患者データが 1 GB の場合、Spark はそのすべてのデータをクラスター全体に再分散する必要があるため、リソースを大量に消費するジョブになります。
バケッティングのメタデータを付けて claims と patients の両方を書き直すことで、書き込み時のコストと引き換えに、読み取りを高速化できます。
Copied!1 2 3 4 5 6 7 8 9DatasetFormatSettings format = DatasetFormatSettings.builder() .numBuckets(200) .addBucketColumns("patient_id") .addSortColumns("patient_id") .build(); output.getDataFrameWriter(df) .setFormatSettings(format) .write();
Copied!1output.write_dataframe(df,bucket_cols=["patient_id"],bucket_count=200,sort_by=["patient_id"])
Copied!1 2 3 4 5 6 7from vector.api import DataFrameReturn def my_vector_node(my_input): return DataFrameReturn(my_input, bucket_cols=["patient_id"], bucket_count=200, sort_by=["patient_id"])
Copied!1 2 3 4 5CREATE TABLE `claims` USING parquet CLUSTERED BY (patient_id) SORTED BY (patient_id) INTO 200 BUCKETS AS SELECT ...
同じクエリが、今度は次の物理プランを生成します。
Copied!1== Physical Plan ==*Project [patient_id#72, age#73]+- SortMergeJoin [patient_id#72], [patient_id#75], LeftOuter:- *FileScan parquet default.claims[patient_id#72,age#73] Batched: true, Format: Parquet, Location: InMemoryFileIndex[file:/Volumes/git/spark/spark-warehouse/claims], PartitionFilters: [], PushedFilters: [], ReadSchema: struct<patient_id:string,age:int>+- *FileScan parquet default.patients[patient_id#75] Batched: true, Format: Parquet, Location: InMemoryFileIndex[file:/Volumes/git/spark/spark-warehouse/patients], PartitionFilters: [], PushedFilters: [], ReadSchema: struct<patient_id:string>
Foundry はバケッティングと並べ替えに関するメタデータを保存するため、Spark は HDFS または S3 からデータを取得した直後に結合を開始します。これにより、シャッフルと並べ替えのステージが不要になり、ジョブの実行時間が短縮されます。ローカルディスクへの書き込みは発生せず、最初の取得以外に追加のネットワークトラフィックも必要ありません。
バケッティングが書き込み側に与える影響
バケッティングと並べ替えは、変換自体を変更しません。ジョブの最終タスクが出力を書き込む方法だけを制御します。請求データの例では、Spark は出力データを単一のファイルに順番に書き込む代わりに、hash(patient_id) % 200 として定義される一時的な列 bucket を作成し、パーティション内を (bucket, patient_id) で並べ替えます。入力データが次のようになっている場合、
Copied!1 2 3 4 5 6A C A A B C
Spark は次のように整形します(A と B のハッシュ値が0、C のハッシュ値が1になると仮定します)。
Copied!1 2 3 4 5 60 A 0 A 0 A 0 B 1 C 1 C
次に、Spark はパーティションを走査し、バケットの値ごとに個別のファイルを書き込みます。この場合は2個のファイルです。
書き込みの直前に repartition(200, "patient_id") を実行すると、各タスク内のバケット値が一定になるため、各タスクは単一のファイルを生成します。ただし、データが均等に分散している場合、最悪のケースでは、各タスクが200個の個別のファイルを書き込みます。出力タスクが200個あると、40,000個の出力ファイルが生成され、書き込みと読み取りの両方のパフォーマンスが低下します。ファイル数が多いと Foundry Catalog と Cassandra のパフォーマンスにも影響するため、出力ファイル数をできる限り抑えてください。
Hive パーティショニング
Spark では、「パーティショニング」という用語が複数の意味で使われます。ドキュメントでは通常、この方式を「Hive スタイル」、「ディレクトリ」、または「動的」パーティショニングというラベルで区別します。
Hive パーティショニングはステップ3で行われます。Apache Hive は、分散コンピューティング環境で大規模なデータセットを保存、クエリ、分析するためのシステムです。
Hive パーティショニングはバケット化と同じ方法でデータを書き込みますが、出力の並べ替えにパーティション列を追加します。Spark はこの列を使用してデータをサブディレクトリに整理し、パーティション列の一意の値ごとに1つ以上の出力ファイルを生成します。このため、フィルターによるプルーニングの効果を測定できる、カーディナリティの低い列(同じ値が多く繰り返される列)に Hive パーティショニングを使用します。
バケット化と同様に、Hive パーティショニングでは、注意しないと小さなファイルが多く生成されることがあります。バケット化と Hive パーティショニングは、パーティション、タスク、エグゼキューターの一対一の原則も崩します。これらの方法では、出力ファイル数がタスク数と異なったり、各タスクが書き込むデータが並べ替えられたりするため、結果は必ずしもタスクごとに1つの出力ファイルになるわけではありません。
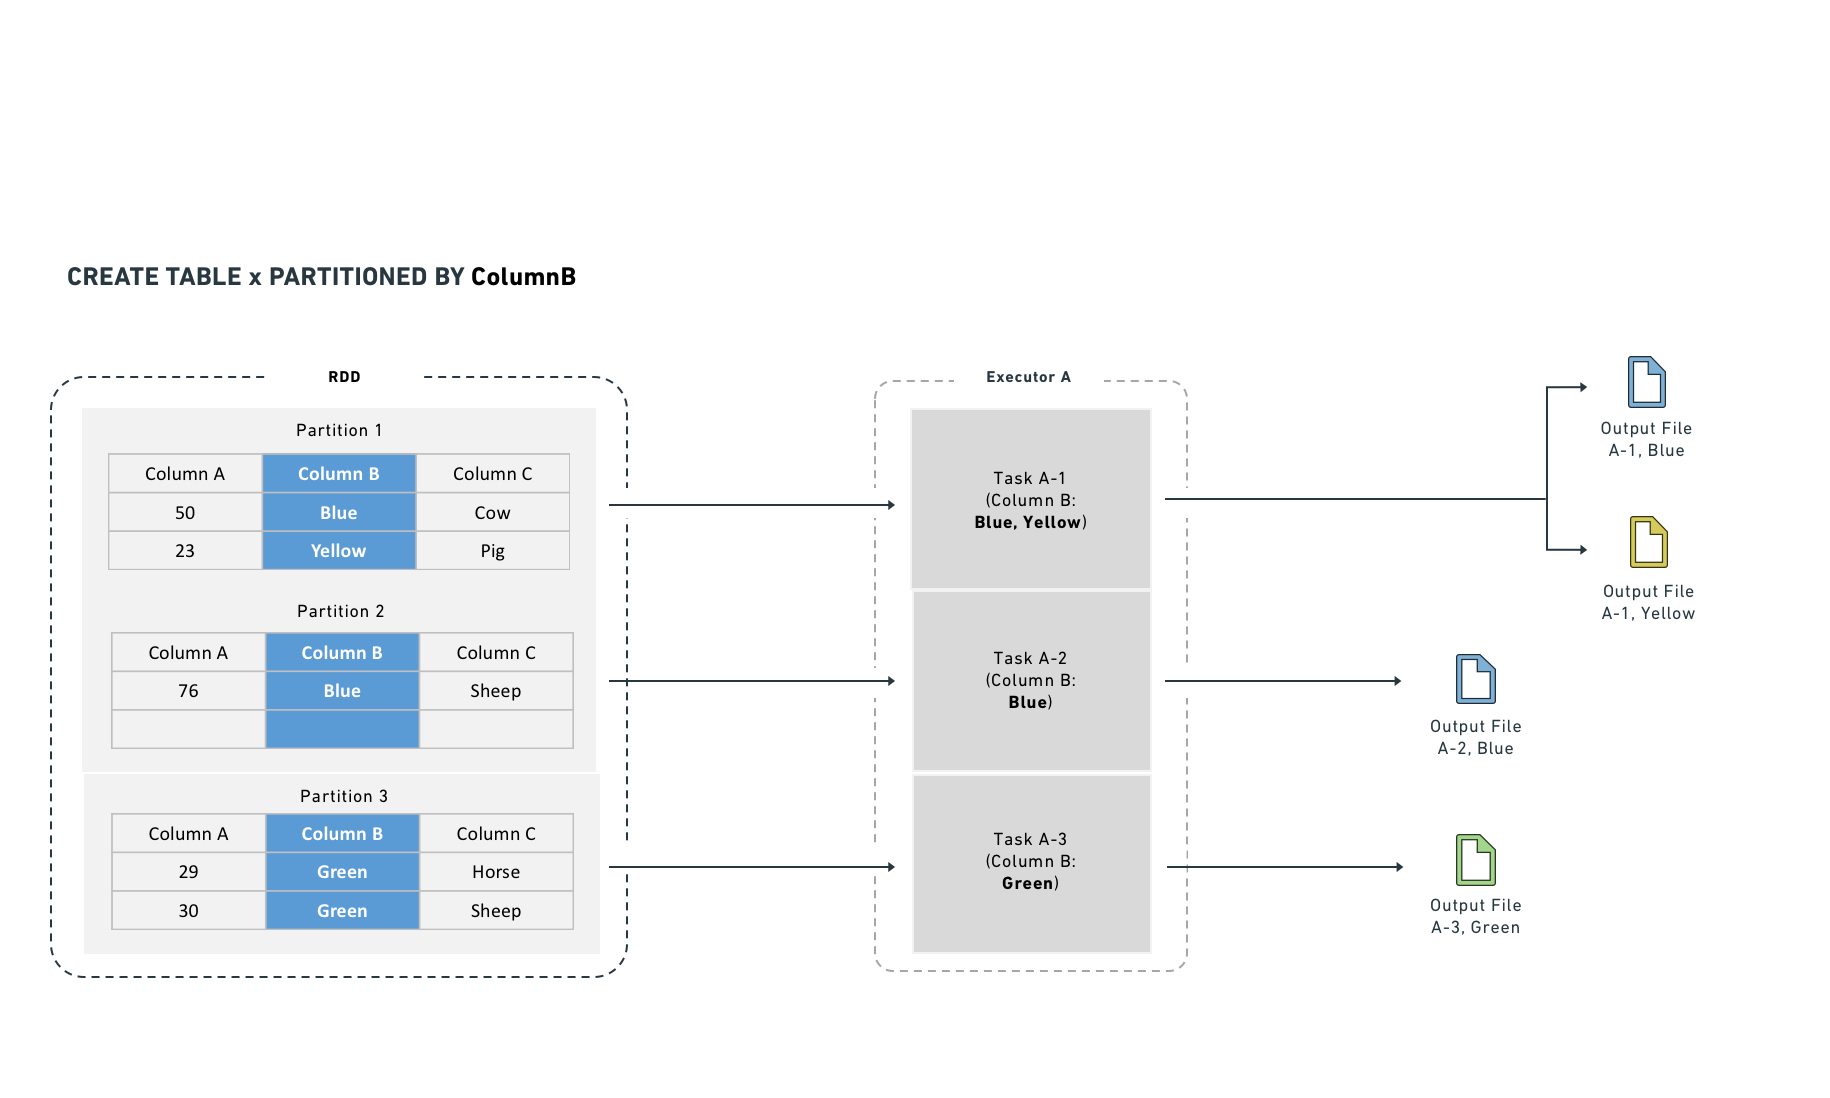
Hive パーティショニングは、パーティションプルーニング、フィルタープッシュダウン、シャッフルを最適化します。カーディナリティの低い列で最も効果を発揮し、各タスクで一意の値ごとに1つの出力ファイルを書き込みます。
Hive パーティショニングはクエリプランナーとも連携し、Spark が読み込むファイル数を減らすことで、絞り込みの効率を高めます。データは、パーティション列の値を名前とするディレクトリに整理されます。そのため、フィルタークエリはディスクからデータを読み込む代わりに、ディレクトリ構造を調べてファイルをプルーニングできます。
たとえば、「year」と「month」でパーティション分割すると、Spark はデータを /path/to/dataset/year=2017/month=09 のように配置します。
この配置により、Spark はフィルター(たとえば、SQL の WHERE 句)に一致するファイルだけを読み込めます。Hive パーティショニングはフィルターに関連するオーバーヘッドを大幅に削減できますが、出力ファイル数も増加します(パーティションごとに1つ以上)。フィルターを使用しない操作では、Spark が多数のファイルを読み込む必要があるため、効率が低下します。
SparkSQL による Hive パーティショニング
CREATE TABLE を使用する SQL 文は、以下で説明する Hive パーティショニングの操作を含め、Code Workbook では実行できません。SQL を使用するには、コードリポジトリで以下の構文を使用します。
Copied!1 2 3 4 5 6CREATE TABLE `/path/to/output` USING parquet PARTITIONED BY (a) AS ( SELECT a, b, c FROM `/path/to/dataset` CLUSTER BY a )
バケット化のセクションで説明した理由と同じ理由で、CLUSTER BY コマンドは引き続き必要です。
CLUSTERED BY と PARTITIONED BY を組み合わせると、サブディレクトリへの分割とファイルレベルのバケット化の両方が行われます。これらのオプションを組み合わせると大量の出力ファイルが生成される可能性があるため、注意してください。
例:ログデータをパーティション分割する
ログデータが毎日届き、ほとんどのクエリで時間範囲を指定するため、日付でパーティション分割します。
Copied!1 2 3 4date=2017-01-01/my_parquet_file0 date=2017-01-02/my_parquet_file1 ... date=2017-01-30/my_parquet_file30
次のクエリを実行した場合:
Copied!1SELECT * FROM logs WHERE date < to_date('2017-01-03')
Spark は 2017-01-01 と 2017-01-02 ディレクトリ配下のファイルだけにアクセスします。これにより、読み込むデータの総量とタスク数の両方が減少します。正しくパーティション分割されたクエリの物理プランは、次のようになります。
Copied!1*FileScan parquet default.logs[content#158,date#159] Batched: true, Format: Parquet, Location: PrunedInMemoryFileIndex[], PartitionCount: 2, PartitionFilters: [isnotnull(date#159), (date#159 < 17169)], PushedFilters: [], ReadSchema: struct<content:string>
PartitionCount は、PartitionFilters を通過した Hive パーティションの数を示します。これらのパーティションが FileScan への入力になります。
前述のとおり、Hive パーティショニングはバケット化と同じ書き込みの仕組みを使用します。
Copied!1 2 3 4 5 6 7DatasetFormatSettings format = DatasetFormatSettings.builder() .addPartitionColumns("date") .build(); output.getDataFrameWriter(df) .setFormatSettings(format) .write();
Copied!1output.write_dataframe(df, partition_cols=["date"])
Copied!1 2 3CREATE TABLE `logs` USING parquet PARTITIONED BY (date) AS SELECT ...
Hive パーティション分割されたデータを使用する Mesa データセットは、Hive パーティション列を正しく読み込めません。これらの列は null 値になります。直接の利用先が Mesa Transforms データセットの場合は、Hive パーティショニングを使用しないでください。
結合
一部の計算では、同じキーを持つ行を同じ場所に配置するために、エグゼキューターがデータをシャッフルする必要があります。シャッフルはネットワーク I/O とディスク I/O を消費し、パフォーマンスを低下させます。結合または集計を別のデータセットとして実体化することで、このコストを削減できます。この方法では結合を1回計算し、後続のトランスフォームや Contour サービスは再計算せずに結果を再利用するため、シャッフルのコストが繰り返し発生することを防げます。
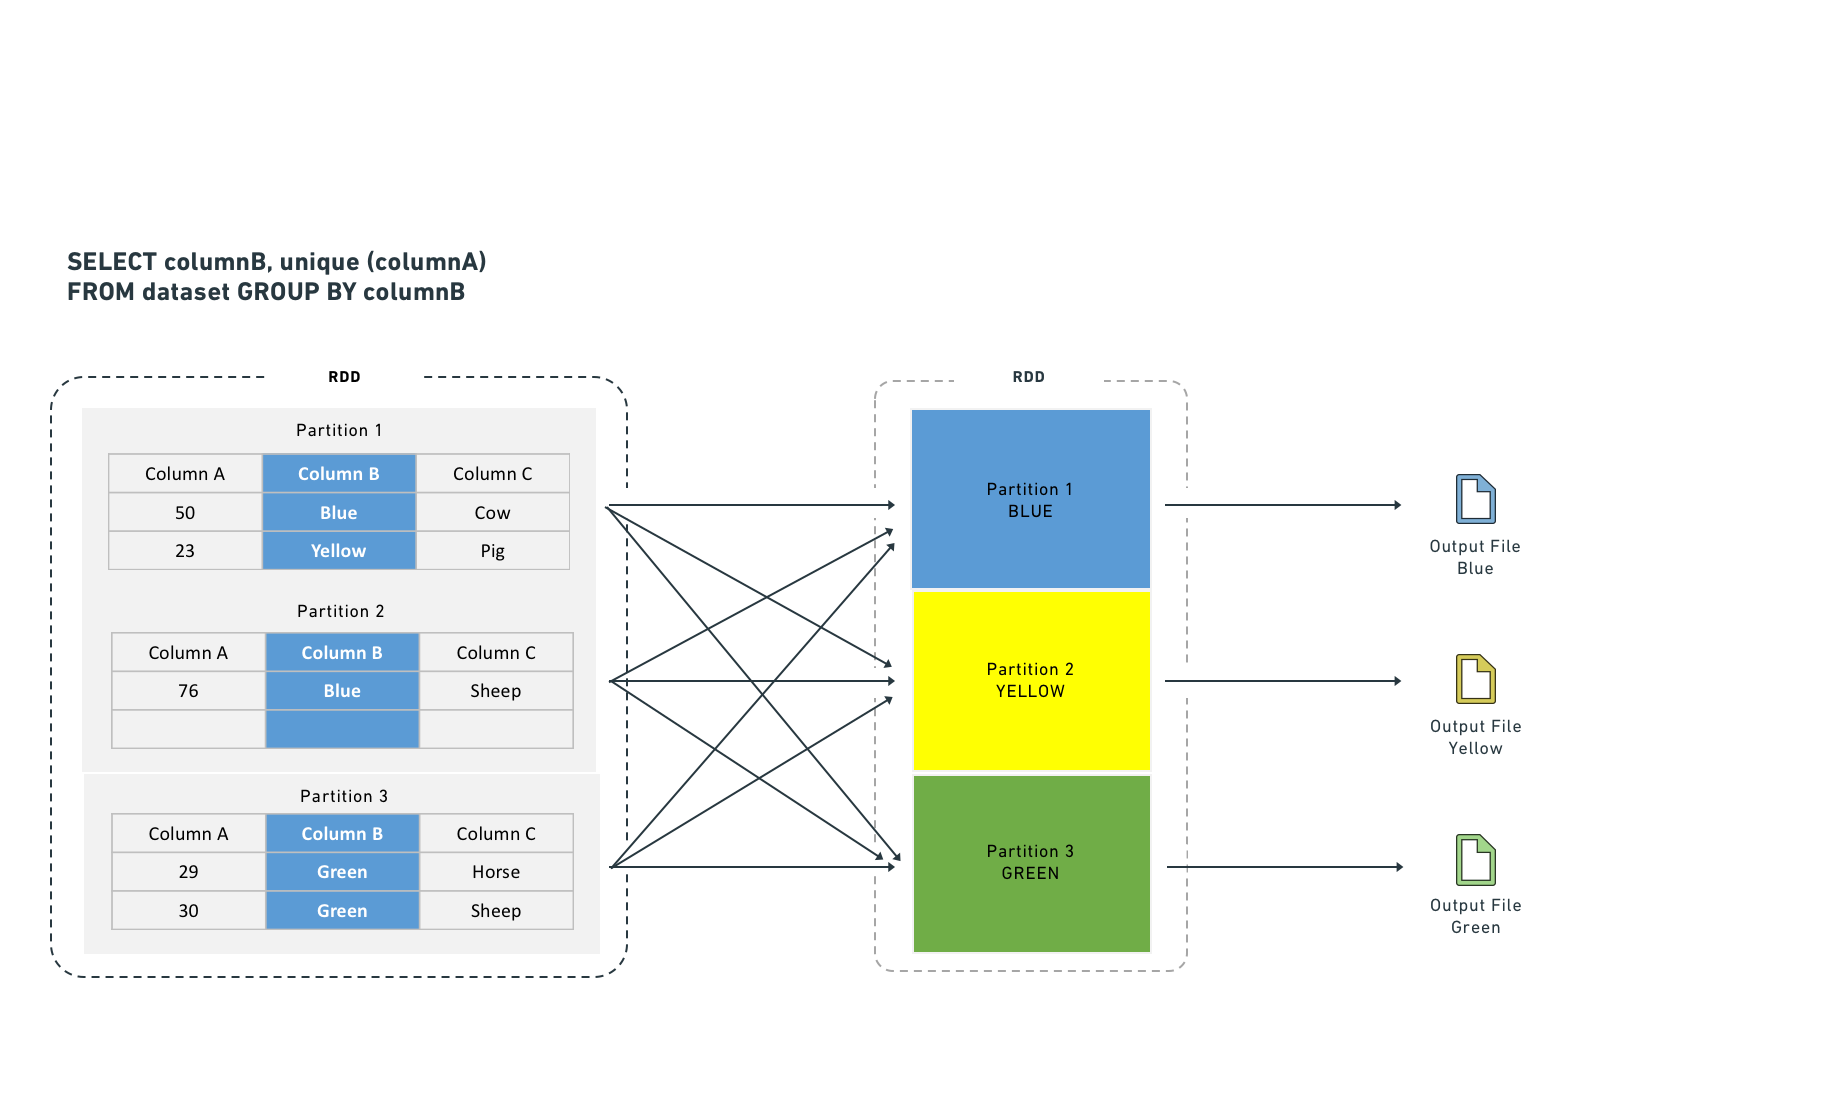
一部の計算では、エグゼキューターがデータをシャッフルして、キーごとに行を同じ場所に配置します。シャッフルはネットワーク I/O とディスク I/O を消費します。計算前に結合と集計(その後に並べ替え)を行うと、データのシャッフルが不要になります。これは Hive パーティショニングに似ていますが、タスクの完了後ではなく開始前に行われます。
Spark は2つの結合方式をサポートしています。
- ソートマージ結合(デフォルト): Spark は結合キーで両側のデータをシャッフルし、各パーティションを並べ替えてからマージします。この方法では、シャッフルと並べ替えの両方が必要です。入力を結合キーでバケット化することで、ソートマージ結合のパフォーマンスを改善できます。
- ブロードキャスト結合: Spark は結合を実行する前に、右側のデータセットをすべてのエグゼキューターにコピーします。行レベルのシャッフルが不要なため、ブロードキャスト結合の方が高速に実行されます。ただし、ブロードキャスト結合は右側のデータセット全体をすべてのエグゼキューターに複製するため、クラスター全体のメモリー消費量が増加します。
ブロードキャスト結合は、結合を実行する前に、指定されたすべてのエグゼキューターに右側のデータセットをコピーします。
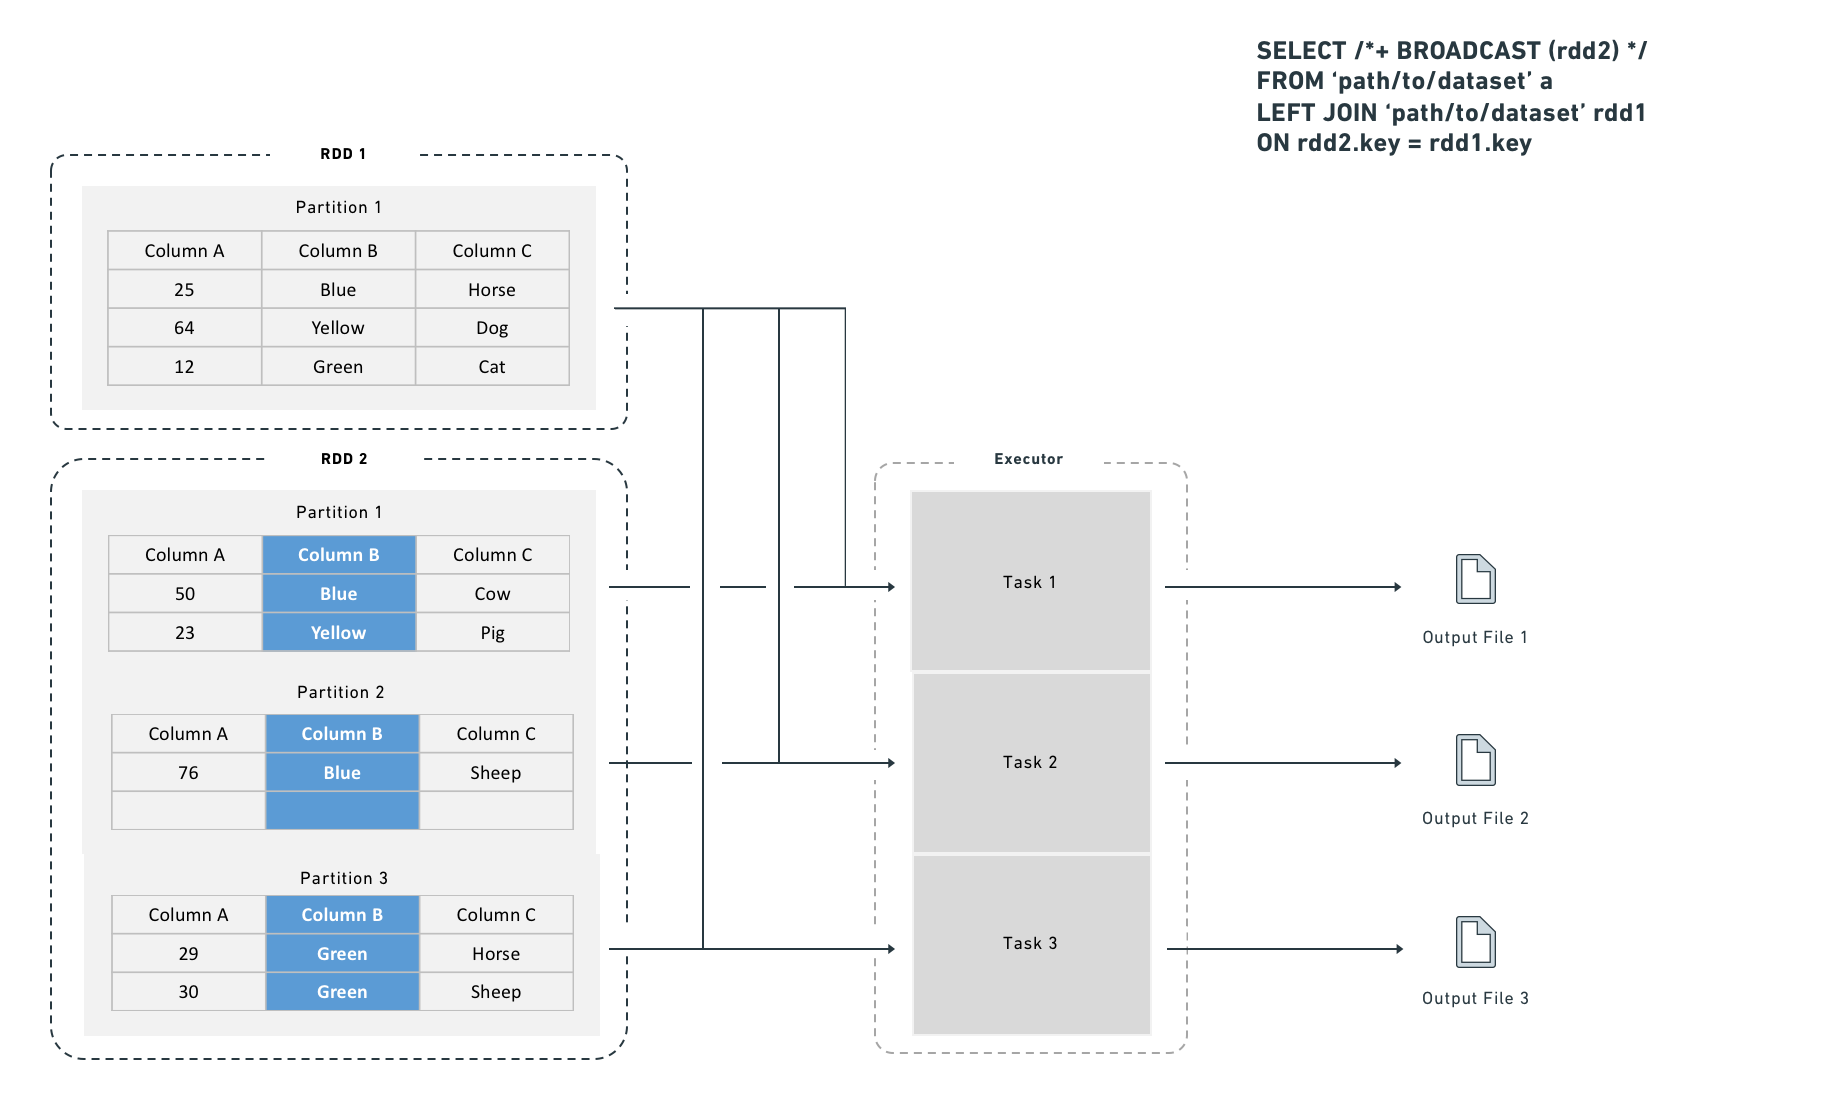
シャッフル結合とブロードキャスト結合のどちらを選ぶか
小さい方のデータセットがエグゼキューターのメモリーに収まる場合(たとえば、100万行未満の場合)は、ブロードキャスト結合を使用します。Spark は autoBroadcastJoinThreshold 設定に基づいてブロードキャスト結合を自動的に適用します。この設定のデフォルトはディスク上で 10 MB で、ユーザーが設定できます。明示的なヒントを指定することもできます。これは、サイズが小さいとわかっている中間結果(たとえば、大幅な絞り込みや行数を減らす結合の後)に役立ちます。
ブロードキャスト結合の構文
Copied!1 2 3from pyspark.sql import functions as F df_a.join(F.broadcast(df_b), df_a["key"] == df_b["key"], "left")
Copied!1 2 3 4SELECT /*+ BROADCAST (b) */ * FROM `path/to/dataset` a LEFT JOIN `path/to/dataset` b ON a.key = b.key
設定によっては、上記のヒントがなくても、小さなデータセットに対して Spark が結合をブロードキャスト結合に自動変換する場合があります。
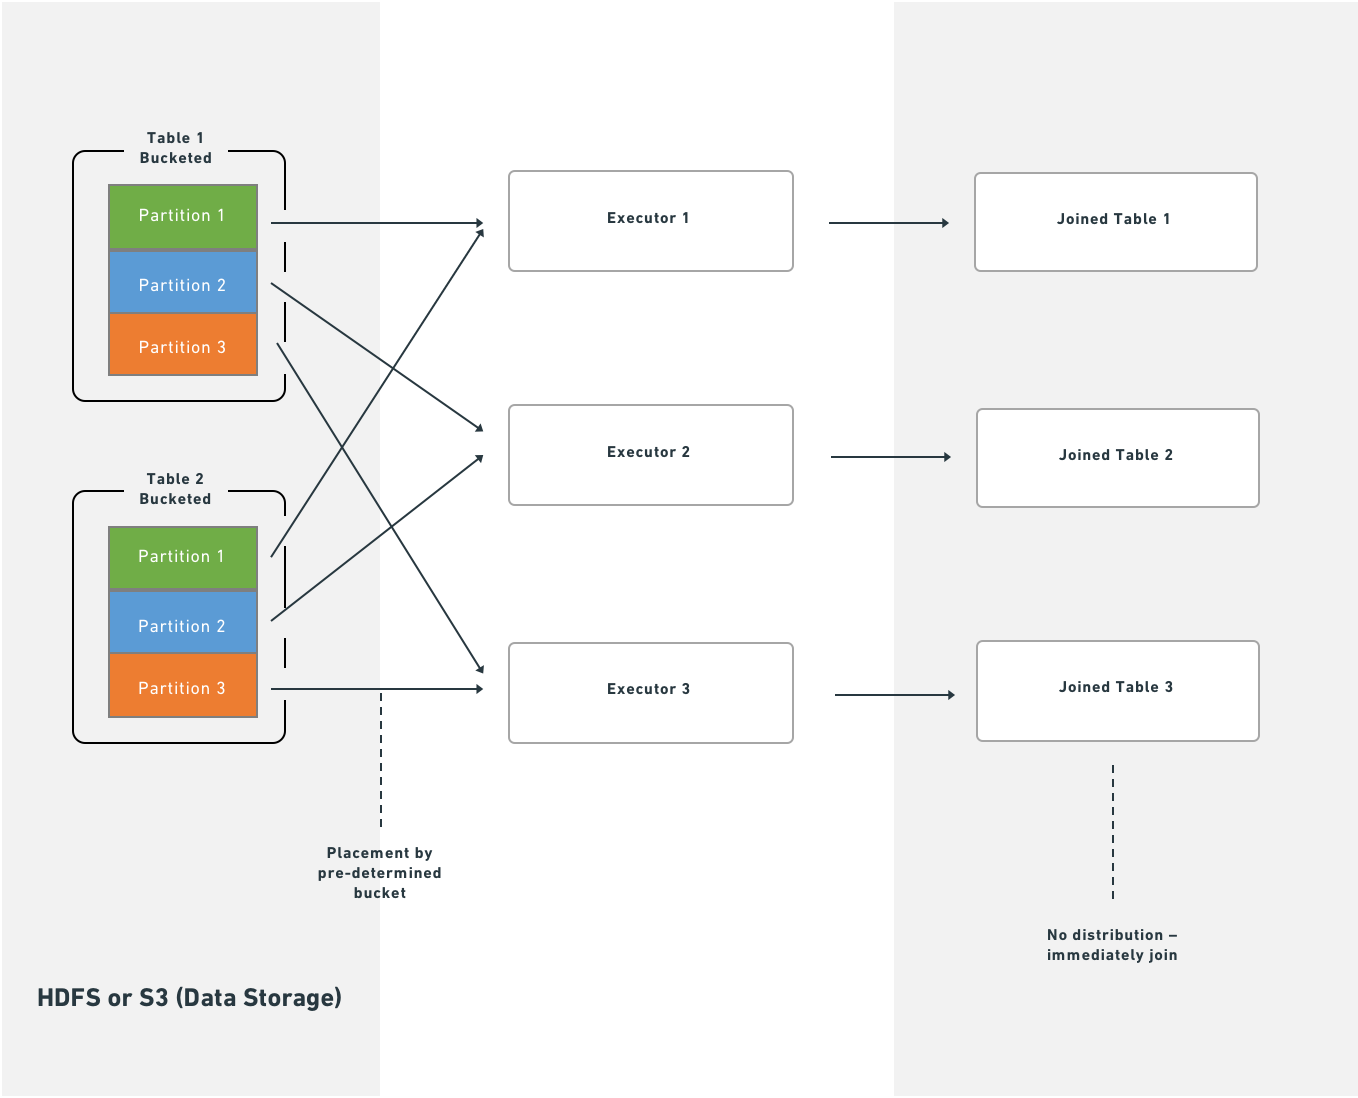
バケット化を使用しない場合、結合には追加の分散ステージが必要です。
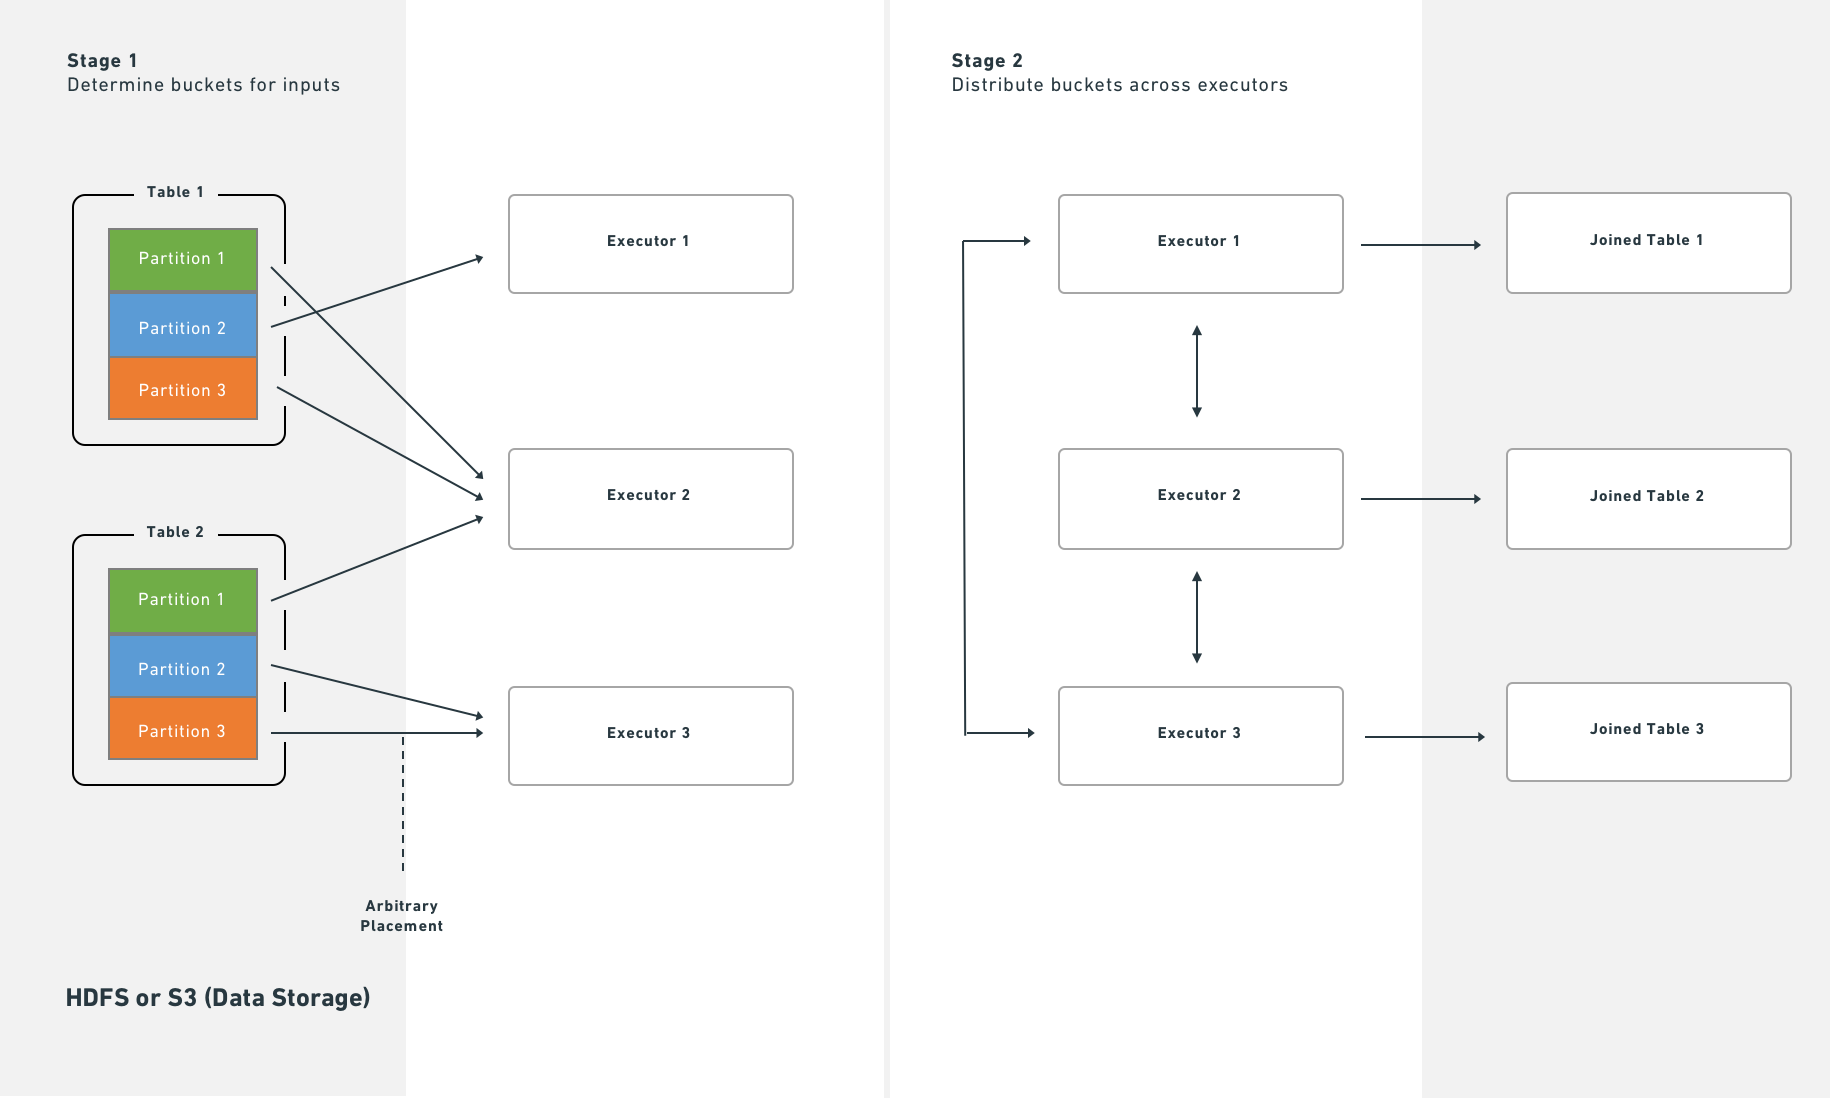
バケット化を使用すると、Spark は HDFS または S3 からパーティションを読み込んだ直後に結合を実行します。
トランスフォームを分割する
バケット化、パーティショニング、結合の実体化でパフォーマンスの問題が解決しない場合は、1個のトランスフォームを複数のトランスフォームに分割することを検討します。この方法により、必要最小限の中間データセットと、各ステップで最も効率的なパーティショニングおよびバケット化を明確にできます。ただし、ジョブを分割するとスケジューリングとオーケストレーションのオーバーヘッドが発生するため、ある程度のパフォーマンス低下を見込んでください。
リソースを増やす
最後の手段として、トランスフォームに追加のリソースを割り当てるよう Foundry に要求できます。変更前後のパイプラインのパフォーマンスを測定および監視するには、トランスフォームのメトリクスを使用します。追加のリソースを要求する前に、上記の手法をすべて試してください。理由は次のとおりです。
- リソースの追加割り当ては、クラスターの負荷を増加させます。
- Spark は「フェアシェア」の仕組みを使用して、ほかのジョブから未使用のリソースを回収します。複数のトランスフォームがリソースを過剰に割り当てると、互いのリソースを継続的に回収することになり、オーバーヘッドが増加してクラスター上のすべてのサービスのパフォーマンスが低下します。
大規模なデータセットに対する一部の変換は、追加のリソースなしでは許容できる時間内に完了できません。追加のリソースが必要と判断した場合は、適切な割り当てを受けるために Palantir サポートにお問い合わせください。