注: 以下の翻訳の正確性は検証されていません。AIPを利用して英語版の原文から機械的に翻訳されたものです。
Pipeline Builder の高速パイプライン
Pipeline Builder でバッチパイプラインを作成すると、デフォルトで高速が選択されます。高速パイプラインは、バッチパイプラインとインクリメンタル(差分処理)パイプラインの実行時間を短縮できます。この種類のパイプラインは、Rust ↗ で記述されたオープンソースのクエリエンジンである DataFusion ↗ を搭載したバックエンドを使用します。高速パイプラインでは、従来の Spark ベースのパイプラインと比較して、計算処理を大幅に高速化できます。
高速パイプラインは、以前は軽量パイプラインと呼ばれていました。「軽量」という用語は、処理するデータのサイズではなく、パイプラインの実行に必要な時間と計算リソースが少ないことを指していました。この名称変更は、大規模なデータセットであっても、高速パイプラインによって実行時間と計算リソースの使用量の両方が削減されることを反映しています。
高速パイプラインは、ビルド時間を最適化し、低遅延の処理を効率的に実行するために設計されています。特に、実行時間が15分未満のパイプラインでは、高速パイプラインの設定による効果が最も大きくなります。
パフォーマンスを向上させるために、さまざまなパイプライン設定を試すことをお勧めします。ブランチでテストするか、既存のパイプラインのコピーを作成して新しい設定と元の設定のパフォーマンスを比較することで、機能を探索できます。
新しい高速パイプラインを作成する
Pipeline Builder でのパイプラインの作成に慣れていない場合は、先に Pipeline Builder でバッチパイプラインを作成する方法のドキュメントを確認してください。
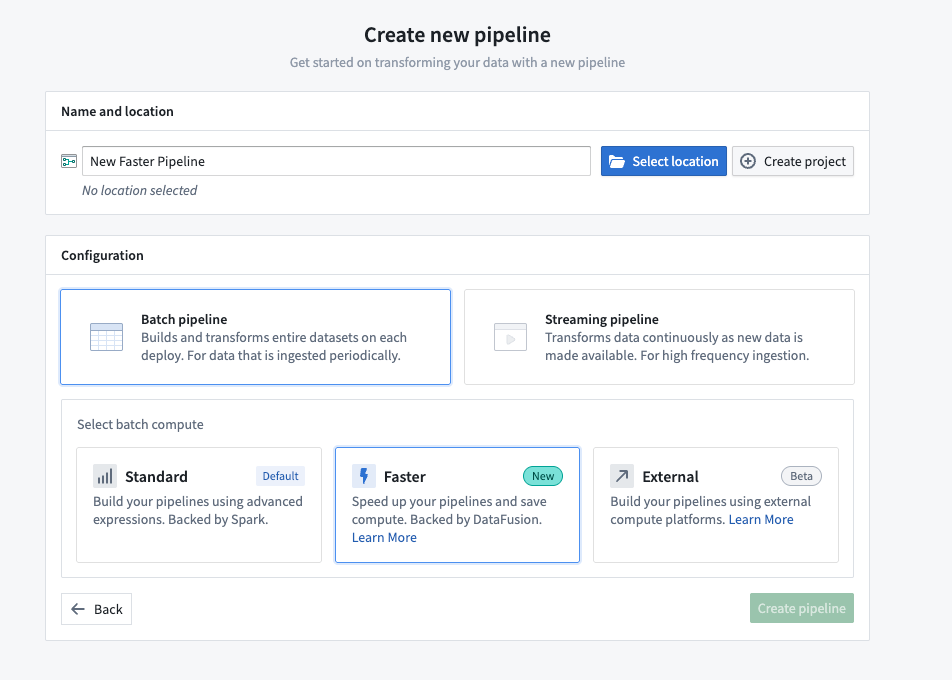
- Pipeline Builder を開き、新規作成を選択してから、バッチパイプラインを選択します。
- パイプラインの名前を入力し、場所を選択します。バッチ計算を選択で、デフォルトの高速を選択したままにします。
- パイプラインの作成を選択します。
高速パイプラインと標準バッチパイプラインを相互に変換する
以下のステップに従って、高速パイプラインと標準バッチパイプラインを相互に変換できます。同じ手順を繰り返して目的の選択肢を選択することで、いつでも元に戻せます。
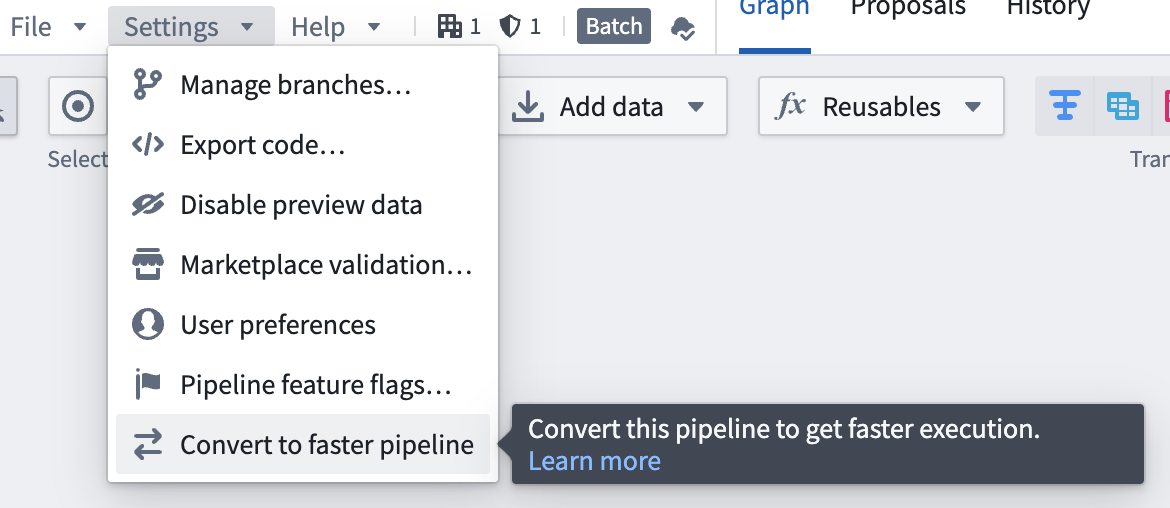
- バッチパイプラインを変換するには、設定に移動し、高速パイプラインに変換を選択します。
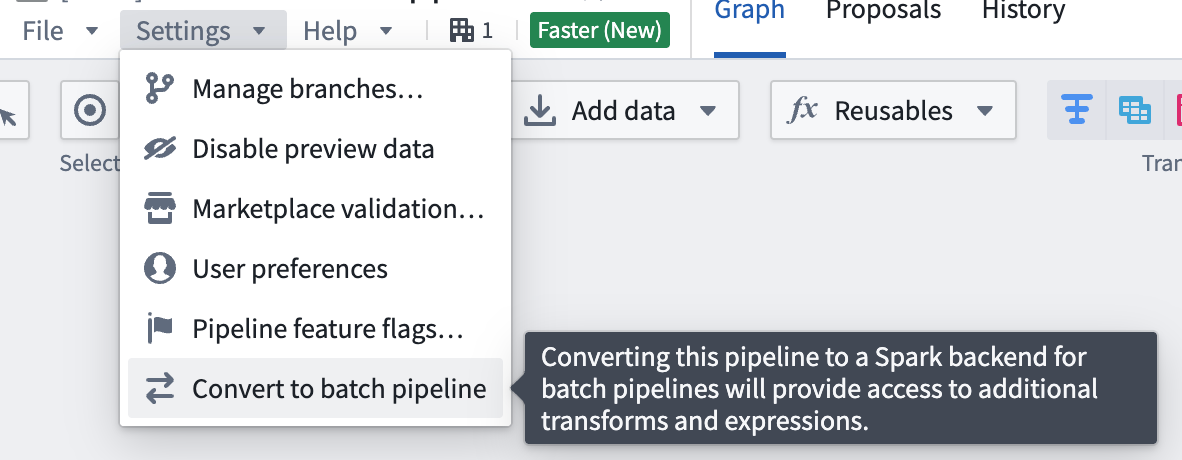
パイプラインをバッチパイプラインに戻すには、設定に移動し、バッチパイプラインに変換を選択します。
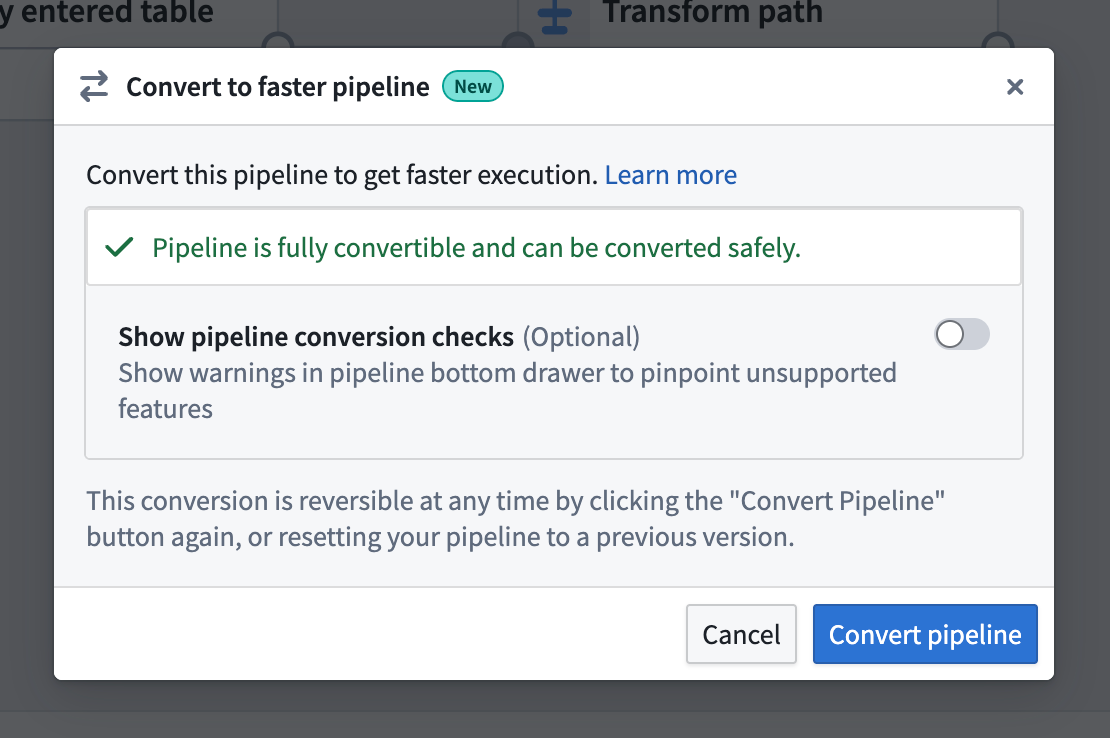
- パイプラインが新しい種類のパイプラインと互換性がある場合は、変換を確認するダイアログボックスが表示されます。
- パイプラインが新しい種類のパイプラインと互換性がない場合は、変換しようとすると警告が表示されます。警告には、高速パイプラインと互換性のない式やトランスフォームが一覧表示されます。
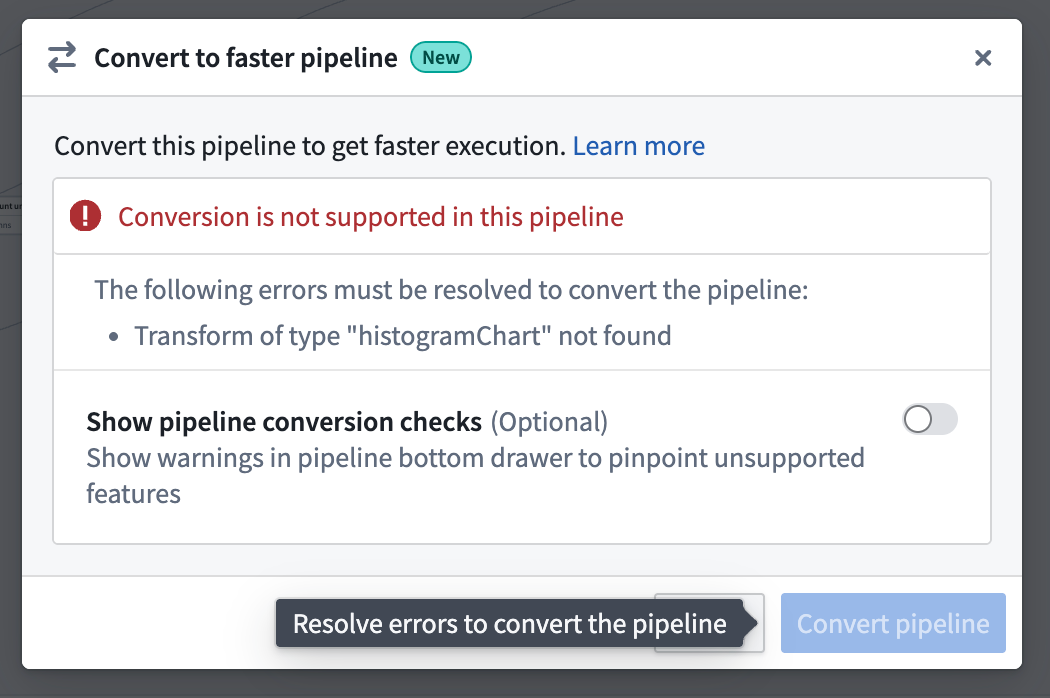
いつでもパイプライン変換チェックを表示をオンにして、高速パイプラインと互換性のない項目を確認できます。
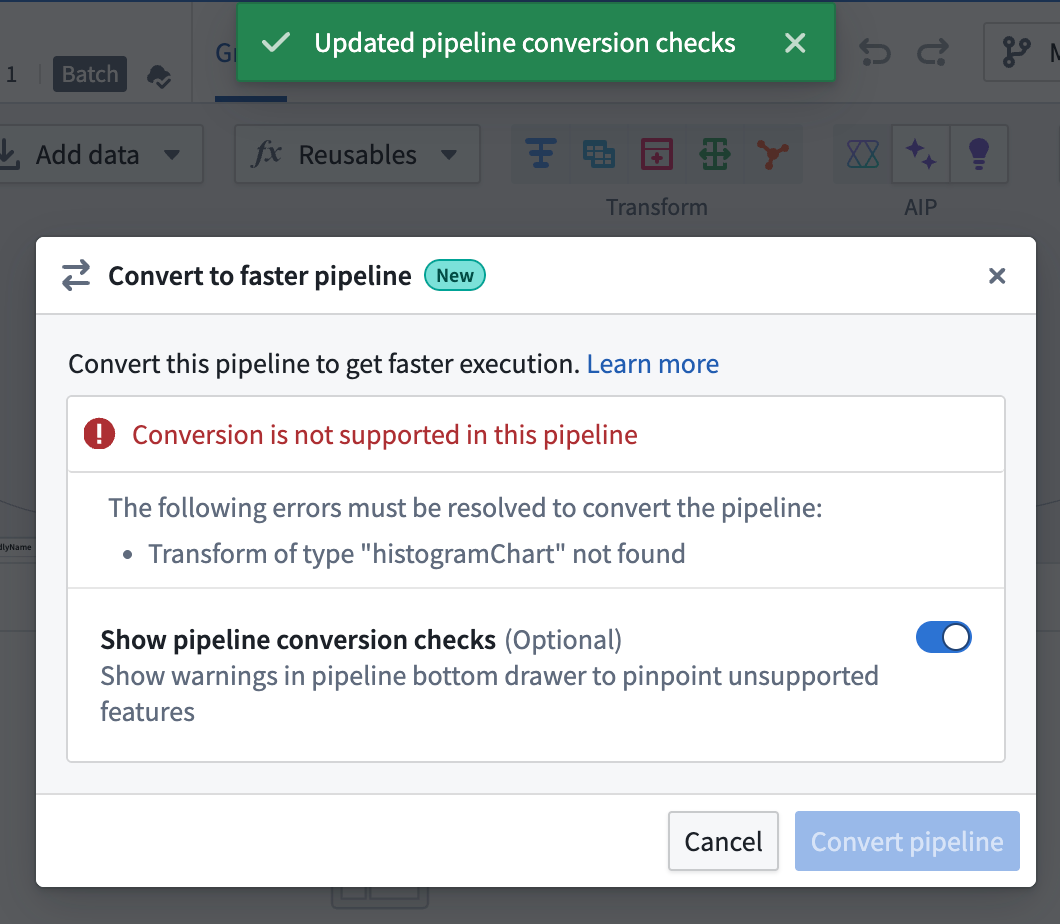
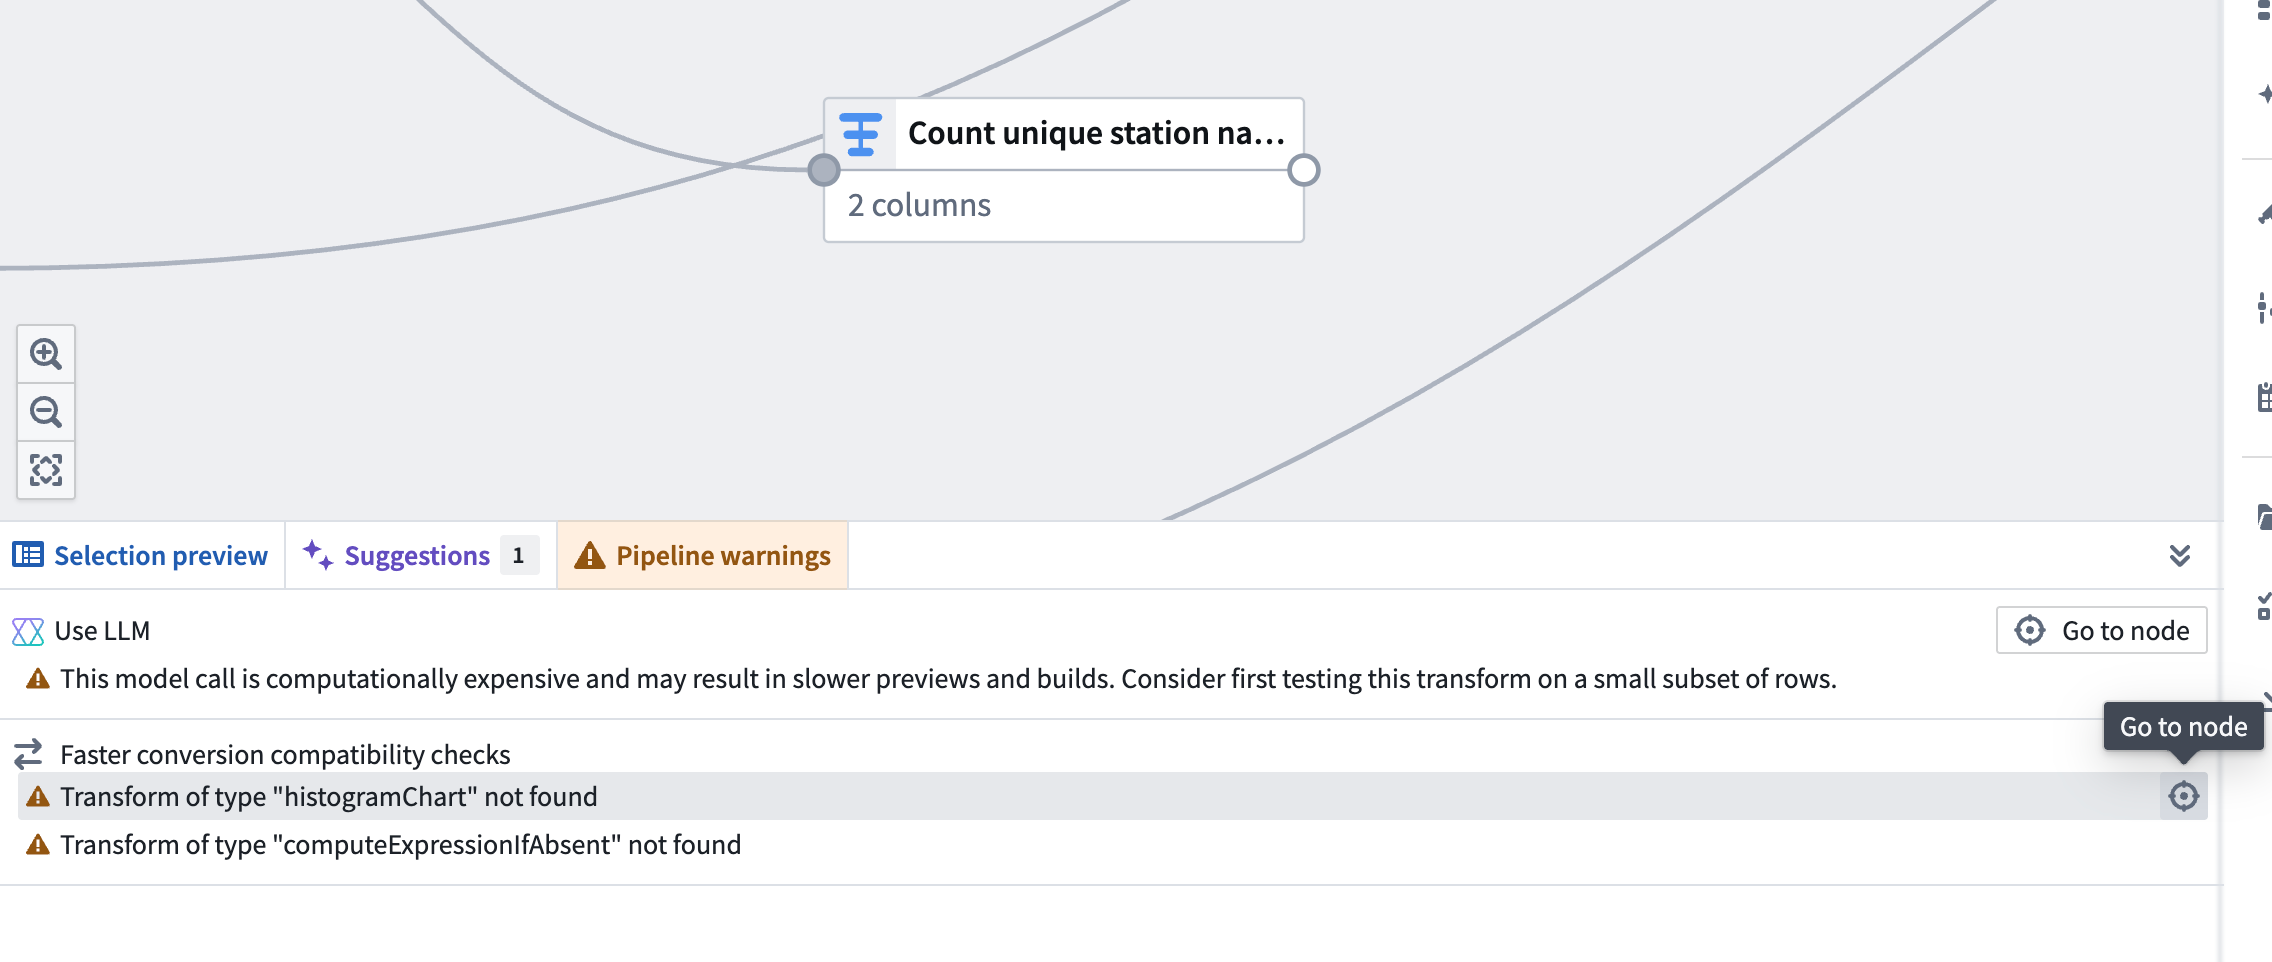
パイプライン変換チェックを表示をオンにすると、画面下部の警告パネルに高速パイプラインへの変換の互換性チェックセクションが表示されます。このセクションには、高速パイプラインで利用できないトランスフォームと式が一覧表示されます。対応していないトランスフォームを含むノードをすばやく見つけるには、該当する行の右側にあるノードに移動アイコンをクリックします。
既知の制限事項
高速パイプラインは現在、標準バッチパイプラインと同じ範囲のトランスフォームや式には対応していません。特に、一部の地理空間式や配列式は利用できません。特定の式が高速パイプラインで利用できるかどうかは、関数一覧で確認してください。
高速パイプラインとバッチパイプラインには違いがあるため、プレビューを使用するか、ビルド出力を調べて、必ず結果を確認してください。
高速パイプラインで利用できる式のほとんどは、バッチパイプラインの同等の式と同じように動作します。既知の制限事項は次のとおりです。
- 浮動小数点数の結果は、末尾の桁が異なる場合があります。
- Decimal のオーバーフローが発生すると、
NULL値を出力する代わりにエラーがスローされます。 - 構造体は、
<、>、==などで比較できません。 powのオーバーフローでは、infの代わりにNULLが返されます。- 構造体、配列、マップなどの複合型のキャストや、それらの文字列への変換では、動作に差異がある場合があります。たとえば、これらのデータ型を文字列に変換すると、null の表示が異なる場合があります。
TimestampToString、DateToString、StringToTimestamp、StringToDateで対応している形式には制限があります。- 構造体、配列、マップなどの複合型では、最小値と最大値は利用できません。
- 出力が空の場合、空のファイルではなく、ファイル数が0になります。
- ビルド時には、行数以外の統計情報は利用できません。
- 時系列参照値の作成には対応していません。
- トレーニング済みモデルのノードには対応していません。
パイプラインの種類別の対応比較
以下のサイズの推奨値は一般的な目安であり、すべてのクエリに当てはまるわけではありません。適切な種類のトランスフォームであれば、高速パイプラインエンジンは、テラバイト規模の入力でも単一ノードで処理できます。
パイプラインが上記のセクションの制限事項に該当しない場合は、まず高速の選択肢を使用することを推奨します。データの規模に応じて必要な場合や、対応していないトランスフォームや式を使用したい場合は、標準の Spark の選択肢に切り替えることができます。異なる種類のパイプラインを相互に変換できます。
| 特性 | 標準 | 高速 |
|---|---|---|
| 最適なデータサイズ(非圧縮) | > 50GB | 1-50GB |
| 最適な行数* | > 200 million | 1-200 million |
| 起動時のオーバーヘッド | 大きい | 控え目 |
| メモリー効率 | 良好 | 優秀 |
| 処理速度(小規模データ) | 低速 | 優秀 |
| 処理速度(中規模データ) | 高速 | 優秀 |
| 処理速度(大規模データ) | 優秀 | 変動あり |
| 並列実行 | 分散 | 単一ノード |
| メモリースピル | 自動 | 自動 |
* 各クエリエンジンが処理できる行数は、スキーマによって異なります。これらの数値は、一般的なケースでの目安として示しています。