注: 以下の翻訳の正確性は検証されていません。AIPを利用して英語版の原文から機械的に翻訳されたものです。
Pipeline Builder の外部パイプライン
Pipeline Builder では、外部のコンピュートエンジンに計算処理をプッシュダウンする外部パイプラインを利用できるようになりました。これは Python トランスフォームのコンピュートプッシュダウンと同様に動作し、外部データウェアハウスのコンピュート上で Foundry のパイプライン管理、データリネージ、セキュリティ機能を利用できます。
Python トランスフォームのコンピュートプッシュダウンと同様に、外部パイプラインの入力と出力はすべて仮想テーブルである必要があります。
Foundry のスケジューリングツールを使用すると、外部コンピュートでビルドしたテーブルを、Foundry ネイティブのコンピュートでビルドしたデータセットやテーブルと組み合わせられます。これにより、各ステップで最適なコンピュートを使用しながら、複数の技術を組み合わせた複雑なパイプラインをオーケストレーションできます。
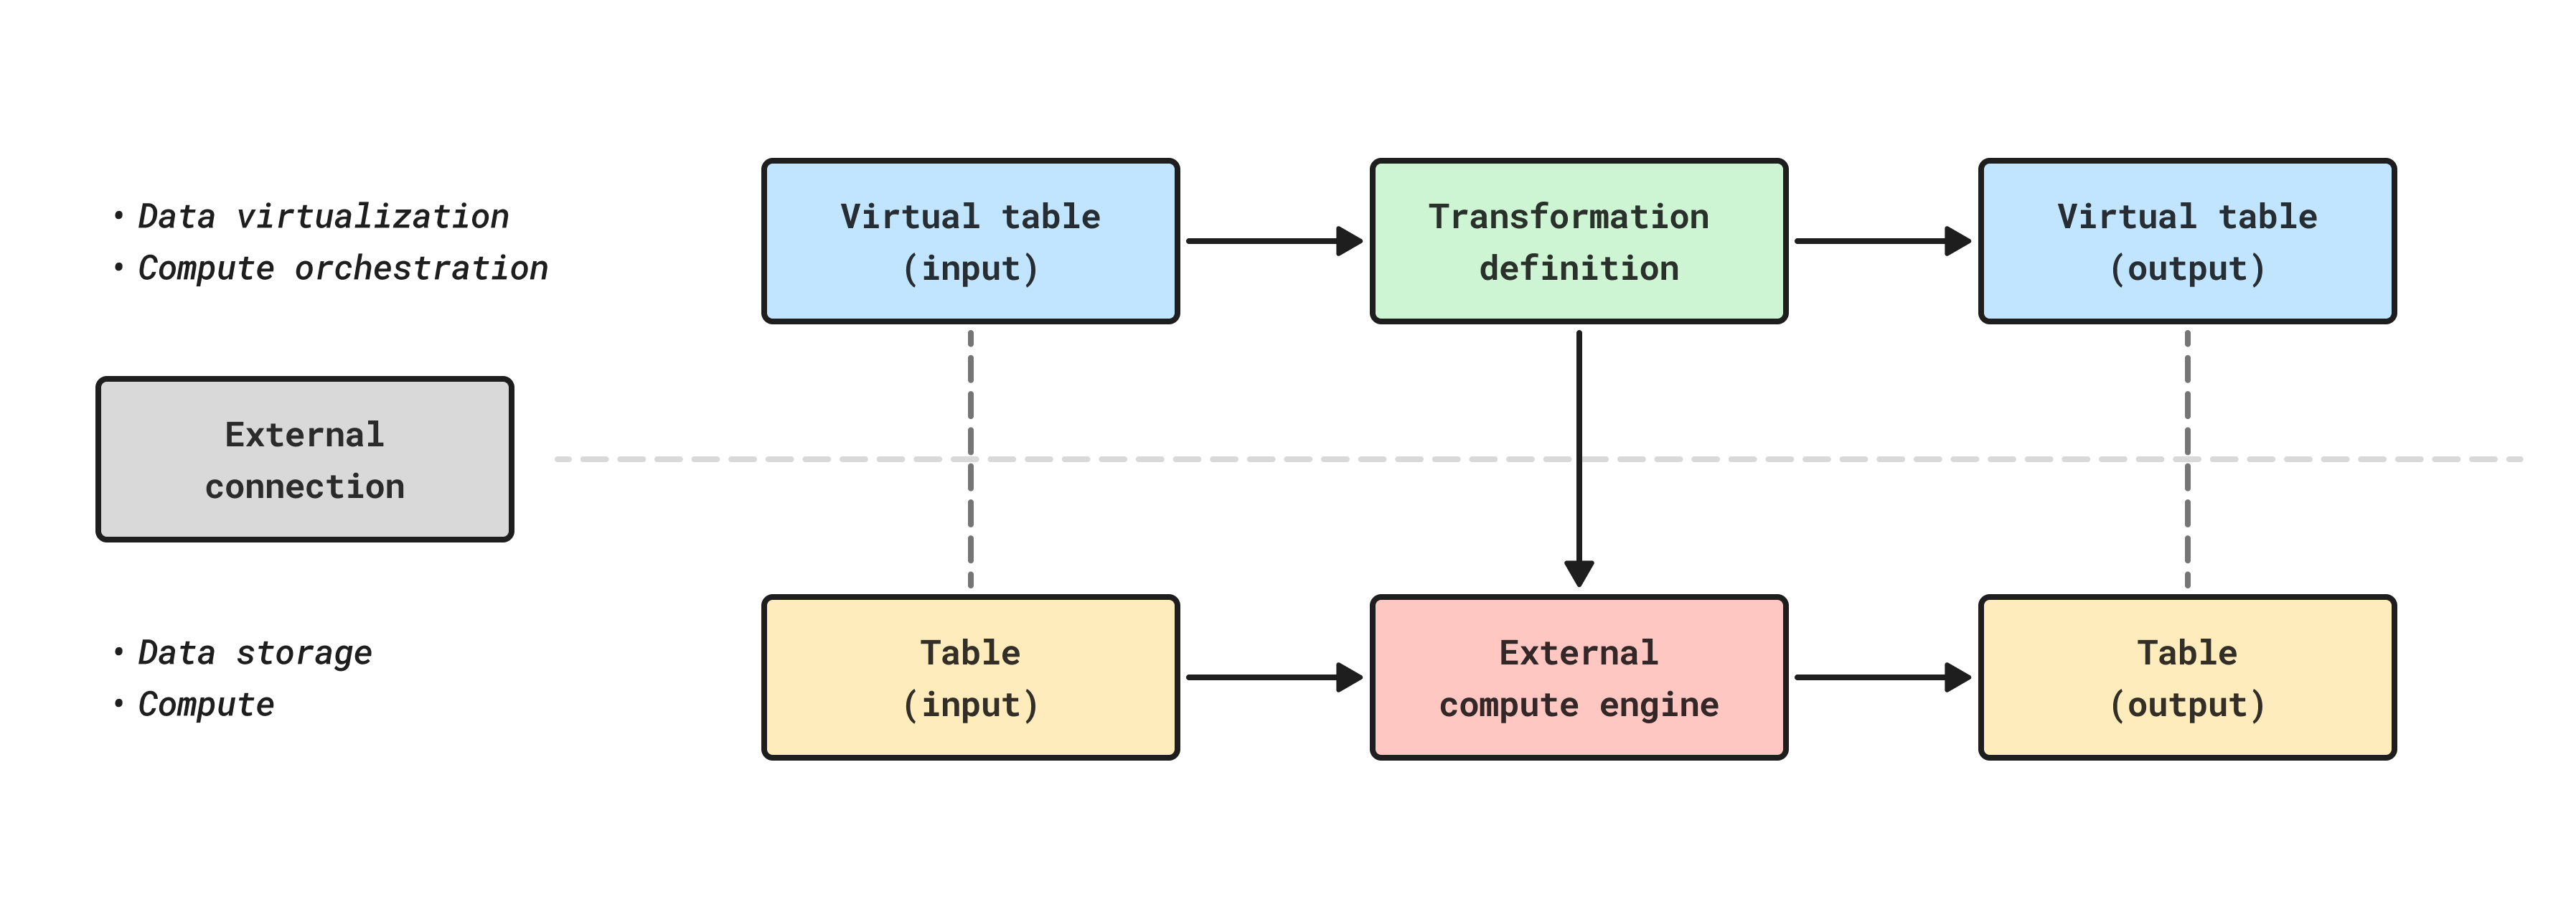
Pipeline Builder でサポートされる外部コンピュートエンジン
現在、Pipeline Builder では外部コンピュートエンジンとして Databricks と Snowflake がサポートされています。BigQuery など、ほかの外部コンピュートエンジンを使用するには、コンピュートプッシュダウンを使用するトランスフォームを使用します。
| ソースタイプ | ステータス |
|---|---|
| BigQuery | 利用不可 |
| Databricks | 一般提供 |
| Snowflake | 一般提供 |
新しい外部パイプラインを作成する
Pipeline Builder を初めて使用する場合は、先に Pipeline Builder でバッチパイプラインを作成する方法を確認してください。
- Pipeline Builder を開き、新規パイプラインの作成を選択します。
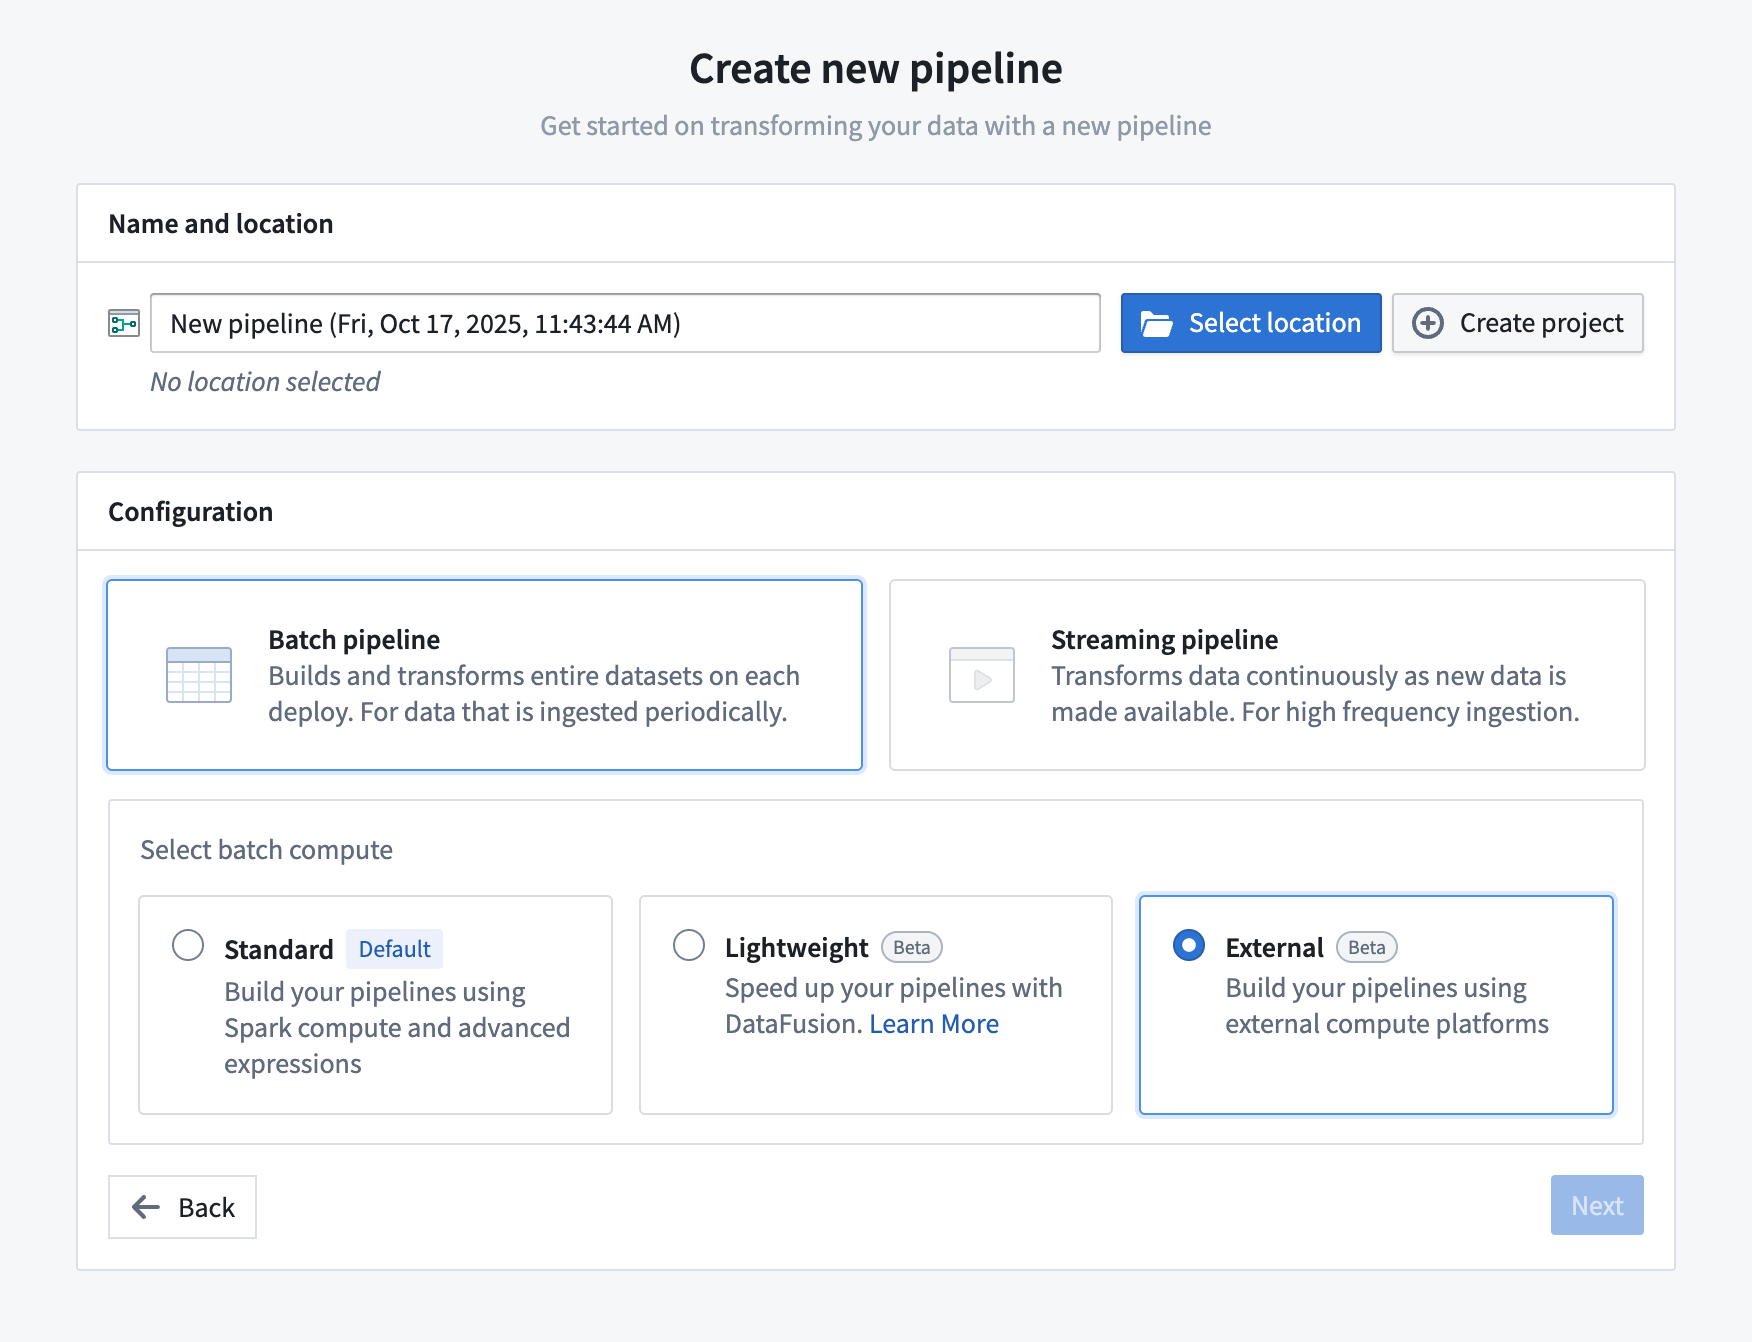
- パイプラインの名前と希望する場所を入力したら、設定でバッチパイプライン > 外部を選択し、次へを選択します。
- サポートされる外部ソースを検索して選択し、パイプラインにインポートします。
- これで、そのソースの仮想テーブルをグラフに追加し、通常どおりパイプラインを作成できます。
- パイプラインの出力はすべて、ソース内の仮想テーブル出力になります。
- ビルドの準備ができたら、パイプラインを保存してデプロイします。パイプラインは外部コンピュートを使用して実行され、ソースシステムに保存される仮想テーブルとして結果を出力します。
入力テーブルと出力テーブルはすべて、パイプラインのセットアップ時に選択した同じソースの仮想テーブルである必要があります。Databricks の外部パイプラインでは、Databricks テーブルのみがサポートされます。Snowflake の外部パイプラインでは、同じ外部ボリュームの Snowflake 仮想テーブルのみがサポートされます。外部パイプラインを使用する場合、Foundry データセットは入力または出力として利用できません。
ビルド設定を構成する
ビルド設定パネルで、パイプラインのソースを編集し、ソース固有のコンピュートオプションを設定できます。
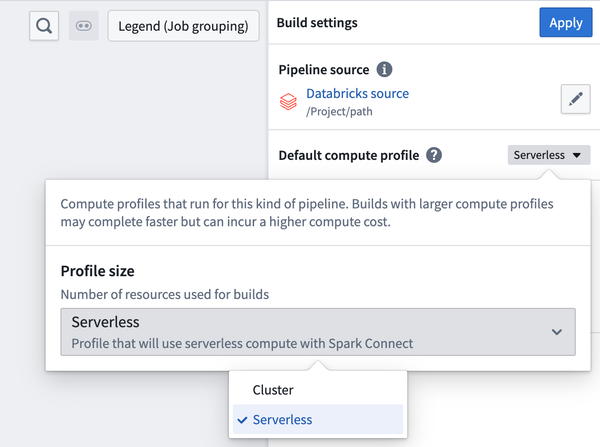
外部コンピュートの設定は、ビルド設定のデフォルトコンピュートプロファイルで利用できます。
| ソースタイプ | コンピュートプロファイル | 説明 |
|---|---|---|
| Databricks | サーバーレス | Databricks Connect でサーバーレスコンピュートを使用します(デフォルト)。Databricks Connect のコンピュートオプションについて詳しくは、Databricks の公式ドキュメント ↗を参照してください。 |
| Databricks | クラシックコンピュート | クラシックコンピュートクラスターのクラスターIDを指定します。指定しない場合、Spark クラスターIDはソース設定から取得されます。ソースが SQL ウェアハウスを使用するように設定されている場合は、指定する必要があります。 |
| Snowflake | コンピュートウェアハウス | コンピュートに使用する Snowflake ウェアハウスを指定します。指定しない場合、ソースに設定されたコンピュートウェアハウスが使用されます。 |
既知の制限事項
Python トランスフォームおよび Pipeline Builderでコンピュートプッシュダウンを使用する場合、ブランチ機能は利用できません。
現在、外部パイプラインでは、標準のバッチパイプラインで利用できるデータ加工と式のすべてがサポートされているわけではありません。
外部パイプラインとバッチパイプラインには違いがあるため、必ずプレビューを使用するか、ビルド出力を調べて結果を確認してください。
現在サポートされていない機能と式には、次のものがあります。
- インクリメンタル(差分処理)計算
- LLM 機能
- メディアセット操作
- 縦結合
- ユーザー定義関数
- 地理空間演算