注: 以下の翻訳の正確性は検証されていません。AIPを利用して英語版の原文から機械的に翻訳されたものです。
SAP SLT
SAP SLT コネクターを使用すると、SAP Landscape Transformation (SLT) Replication Server を介して Foundry を SAP システムに接続できます。データベーストリガーに基づいて、ソースの SAP ERP システムから SLT システム内の対応する Operational Delta Queue (ODQ) にデータが複製されます。SAP SLT コネクターにより、Foundry は次のものと連携できます。
- ソースの ERP システムから複製された SLT Replication Server のテーブル
- SLT Replication Server システム内のローカルテーブル
SAP SLT ソースを使用するには、SAP SLT Replication Server に Palantir Foundry Connector 2.0 for SAP Applications アドオンをインストールする必要があります。SLT を介した接続について詳しくはこちら。
サポートされる機能
| 機能 | ステータス |
|---|---|
| 探索 | 🟢 一般提供 |
| バッチ同期 | 🟢 一般提供 |
| インクリメンタル(差分連携) | 🟢 一般提供 |
| ストリーミング同期 | 🟢 一般提供 |
| コードリポジトリでの使用 | 🟢 一般提供 |
セットアップ
- Data Connection アプリケーションを開き、画面右上の + 新規ソースを選択します。
- 利用可能なコネクターの種類から SAP SLT を選択します。
- 追加の設定プロンプトに従い、以下のセクションの情報を使用してコネクターのセットアップを続けます。ソースは Foundry ワーカー上で実行するように設定されます。既存の Agent ワーカーのソースについては、Agent ワーカーの設定リファレンスを参照してください。
Foundry でのコネクターのセットアップについて詳しくはこちら。
リモートコンテキスト
SAP SLT コネクターには、SLT Replication Server とソースの ERP システム間の RFC 接続を一意に識別するリモートコンテキストの値が必要です。この設定については SLT 設定ガイドを、SLT 接続について詳しくはこちらを参照してください。
認証
SAP SLT コネクターは、次の認証方法をサポートしています。
| 認証方法 | 説明 |
|---|---|
| 基本認証 | コネクターのインストール時に作成した技術ユーザーのユーザー名とパスワードを入力します。 |
| 認証トークン | 認証用のトークンを入力します。 |
| カスタム認証ヘッダー | カスタム認証ヘッダーを指定します。 |
| 認証なし | 証明書を使用して Agent マシン上で認証を設定している場合に使用する選択肢です。 |
ネットワークと接続
SAP SLT システムが Foundry と通信できるように、エグレスポリシー(Foundry ワーカーを使用する場合)または Agent のネットワーク(Agent ワーカーを使用する場合)を適切に設定する必要があります。
Agent ワーカーは、開発ライフサイクルのレガシー段階にあります。新しいソースには Foundry ワーカー接続の使用を推奨します。Foundry ワーカーと Agent ワーカーの比較を参照してください。
多くの SAP システムでは、独自に署名した証明書を使用しているため、初めて接続を設定するときに SSL ハンドシェイク例外が発生することがあります。システムの正しいカスタム証明書を入手し、ソースに追加(Foundry ワーカーを使用する場合)または Agent に直接追加(Agent ワーカーを使用する場合)してください。
SAP Data Accelerator
Foundry と SAP Data Accelerator の統合は、開発ライフサイクルのベータ版段階にあり、お使いのエンロールメントでは利用できない場合があります。開発が進行している間は、機能が変更される可能性があります。
SAP Data Accelerator(SAP Cloud Connector を通じて公開されるシステム向けの、SAP のマネージド接続サービス)を介してこの SAP システムに接続するには、ソースのホストとポートを Cloud Connector の仮想ホストとポートに設定します。次に、Palantir が提供するクライアント証明書を割り当て、SAP Data Accelerator のコントロールプレーンとデータプレーンへのエグレスを許可し、コントロールプレーンの URL を指定して SAP Data Accelerator プロパティを追加します。この接続経路では、Foundry ワーカーを使用する必要があります。
SAP SLT からデータを同期する
探索ビューを使用して、SAP SLT テーブルの同期を作成します。ソースの概要ページで、バッチ同期の横にある + 新規を選択し、ドロップダウンから目的のオブジェクトタイプを選択します。
- SLT Replication Server: ソース ERP システムのデータベーストリガーを使用して、ソースシステムのデータを SLT Replication Server 経由でレプリケーションします。
- ローカルテーブル: SLT Replication Server システム自体にあるテーブルからデータを直接読み込みます。
同期パラメーター
バッチ同期では、次の設定が詳細設定に表示されます。一部はソースレベルでも設定できます。
| 設定 | 説明 |
|---|---|
| 最大ファイルサイズ | 出力される各 Parquet ファイルの最大サイズです。デフォルトはファイルあたり50,000行です。 |
| Avro 用にフィールド名をクリーンアップ | Foundry ストリームで使用される Avro ↗ スキーマのルールに準拠するように、フィールド名をサニタイズします。データセットをストリーミングパイプラインで使用する場合に必要です。 |
| 予期しない値を無視 | 有効にすると、パースに失敗した日付または数値が null として書き込まれ、同期の終了時にパース例外の概要がログに記録されます。 |
| 日付を文字列に変換 | 日付フィールドを文字列として取り込みます。SAP の日付フィールドに、特別な意味を持ち、下流で処理する必要があるパースできない値が含まれている場合に役立ちます。 |
| ページサイズ | SAP からデータを取得するときに、ページごとに返される行数です。デフォルトは50,000行です。最小は5,000行です。 |
| 並列ページングのスレッド数 | ページデータの生成に使用される SAP ワークプロセスの数です。レガシー ODP 同期にのみ適用され、OData 同期には適用されません。 |
| プラグインワーカーのスレッド数 | ページデータの取得に使用される Data Connection Agent のスレッド数です。 |
| リモートコンテキスト | ソースシステムへの RFC 接続識別子です。設定すると、初回の読み込みは SLT Replication Server のキューを経由せず、代わりに RFC 経由でデータを取得します。OData 同期には適用されません。 |
| シリアル化エンジン | データ転送に使用されるシリアル化方式です。 |
| 再試行とタイムアウト | 再試行回数、再試行までの待機時間、およびリクエストのタイムアウトです。 |
| リソースチェック | 抽出中のメモリーと CPU のチェックです。無効にすると、SAP システムに過剰な負荷がかかる可能性があります。 |
| デバッグ設定 | トレースログとデバッグログです。デバッグログは SAP でバックグラウンドプロセスを開始するため、慎重に使用してください。 |
インクリメンタル(差分)バッチ同期では、同期あたりの最大行数設定によって、1回の実行で返されるおおよその行数に上限を設けます。断続的な問題(ネットワーク障害など)によって長時間実行される同期が中断される場合は、この設定を使用して、大きなテーブルの初回同期を、より小規模で障害に強い一連の実行に分割します。
ストリーミング同期
SAP SLT コネクターは、リアルタイムのデータレプリケーションのためのストリーミング同期をサポートしています。ストリーミング同期を作成するには、ソースの概要ページでストリーミング同期の横にある + 新規を選択します。
スナップショットの強制
スナップショットの強制トグルは、ストリームがインクリメンタル更新のポーリングを開始する前に、テーブル全体を読み込むかどうかを制御します。次の場合に、この設定を有効にします。
- ソース ERP システムのデータベーストリガーがリセットされた、または破損した場合。
- SLT Replication Server のポインターが失われた場合。
テーブル全体が Foundry にストリーミングされた後、この設定を無効にして保存し、以降のストリーミングでは更新のみをポーリングするようにします。
API バージョン
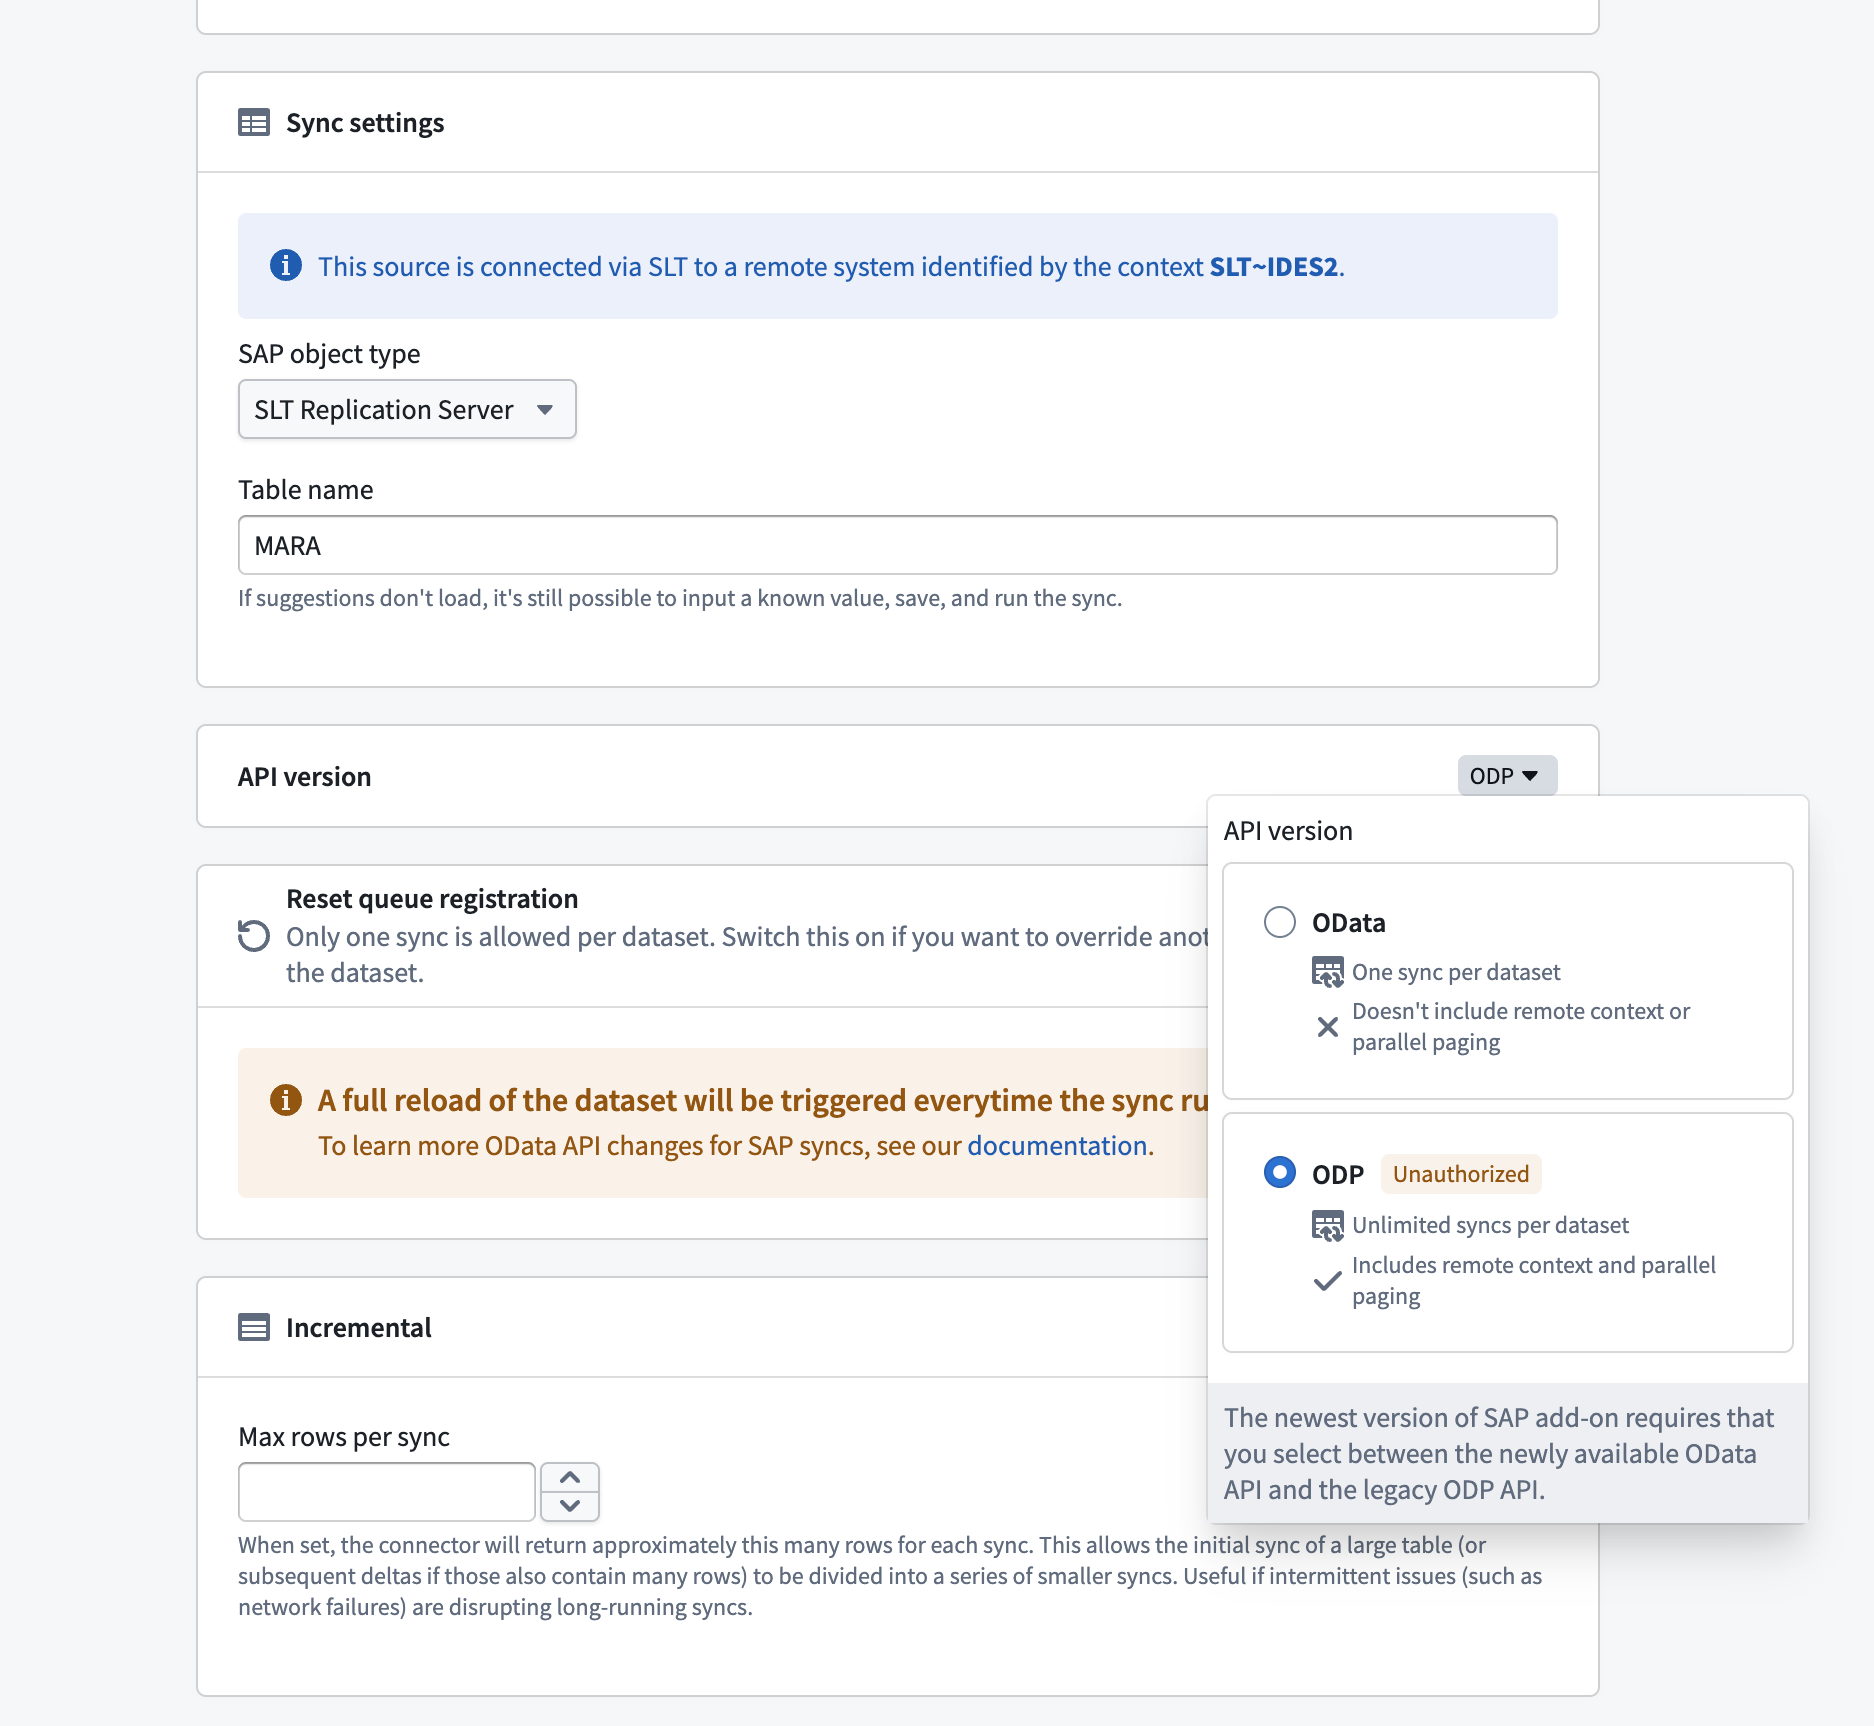
SAP Note 3255746 ↗(バージョン11、2026年4月)に従い、オンプレミス環境とプライベートクラウド環境の両方で、SAP 以外のアプリケーションが RFC 経由で ODP Data Replication API(ODP-RFC)を使用することは禁止されています。2026年6月にリリースされた SAP セキュリティパッチは、許可されていない ODP-RFC 呼び出しを技術的にブロックします。パッチを適用する前に、レガシー ODP API をまだ使用している同期をすべて OData API に移行してください。
アドオンのバージョン2.34(SP34)以降では、SAP SLT 同期で OData API を使用できます。これは、SAP が推奨する OData 経由の ODP ベースのデータ抽出 ↗に基づいています。レガシー ODP API は、SAP によって許可されなくなりました。
OData API を使用するには、次の要件を満たす必要があります。
PALODATAアドオンコンポーネントが SLT システムにインストールされていること。- SAP_BASIS バージョンが 7.50 SP09 以降であること。前提条件と設定についての詳しくはこちら。
| API | 説明 |
|---|---|
| OData | テーブルごとに許可されるアクティブな購読は1件のみです。テーブルに同期がすでに存在する場合、既存の購読を先に解除しない限り、同じテーブルを対象とする新しい同期は失敗します。リモートコンテキストと並列ページングは含まれません。 |
| ODP(レガシー) | テーブルごとに複数の購読が許可されるため、異なる同期で同じテーブルを独立して取り込めます。リモートコンテキストと並列ページングが含まれます。SAP によって許可されなくなりました。 |
キュー登録のリセット
OData API を使用する場合、テーブルに対して最初に設定された同期が、アクティブな購読を取得します。その同期を別の設定に置き換える必要がある場合は、キュー登録のリセットを有効にして、既存の購読を解除し、現在の同期に割り当てます。
キュー登録のリセットを有効にすると、同期が実行されるたびにデータセットのフルロードが行われます。フルロードが繰り返されないように、購読が再割り当てされた後はこの設定を無効にしてください。