注: 以下の翻訳の正確性は検証されていません。AIPを利用して英語版の原文から機械的に翻訳されたものです。
AVEVA PI System(旧 OSIsoft PI)
Foundry を Aveva PI System(旧称 OSIsoft PI Server)に接続して、データを読み取ります。
サポートされる機能
| 機能 | ステータス |
|---|---|
| 探索 | 🟡 ベータ版 |
| 一括インポート | 🟡 ベータ版 |
| インクリメンタル(差分連携) | 🟡 ベータ版 |
| ストリーミング | 🟡 ベータ版 |
| エクスポートタスク | 🟡 ベータ版 |
インターフェース
このコネクターは PI Web API ↗ を利用します。
セットアップ
- Data Connection アプリケーションを開き、画面の右上隅にある + 新規ソースを選択します。
- 利用可能なコネクターの種類から AVEVA PI を選択します。
- 追加の設定プロンプトに従い、以下のセクションの情報を使ってコネクターのセットアップを続行します。
Foundry でのコネクターのセットアップについて、詳しくはこちらをご覧ください。
認証
次の方法で PI System に認証できます。
- ユーザー名とパスワード: ユーザー名とパスワードを入力します。個々のユーザーの資格情報ではなく、サービス資格情報の使用を推奨します。
- Kerberos: Kerberos の設定を指定します。(中継 Agent を介して接続する場合にのみ利用可能です)
ネットワーク
コネクター(たとえば、Agent を介して接続する場合はその Agent)は、PI サーバーの Web API にアクセスできる必要があります。通常は、指定された URL への HTTPS(デフォルトポート443)経由の接続です。
データモデル
PI System コネクターは Web API ↗ を介して動作し、ストリームと値 ↗の概念に従って、データ参照を持つ属性 ↗と PI ポイント ↗からのデータ取得を統合します。対象データセットの各行は、関連するストリームのメタデータ(名前、パス、webID など)を持つ値になります。
また、PI System コネクターは Web API を使用するため、固定値に基づく属性の値(タグデータに基づく値とは異なります)は、ストリーミングや、時系列値を対象とする一括取得では取得できません。ただし、最新値の一括同期では取得できます。
同期するストリームを指定するために、4種類の対象の場所から選択できます。
- 属性フィルター: 指定されたパスから Asset Framework ↗ の階層をたどり、追加のパターンで絞り込む動的フィルターです。
- タグ名フィルター: 特定の Data Server ↗ 上の PI ポイント ↗名に対する動的フィルターです。
- タグ名リスト: 特定の Data Server ↗ 上の名前で識別される PI ポイント ↗の静的リストです。
- WebID リスト:属性 ↗または PI ポイント ↗を参照できる WebID ↗ の静的リストです。
バッチ機能
インクリメンタルの動作
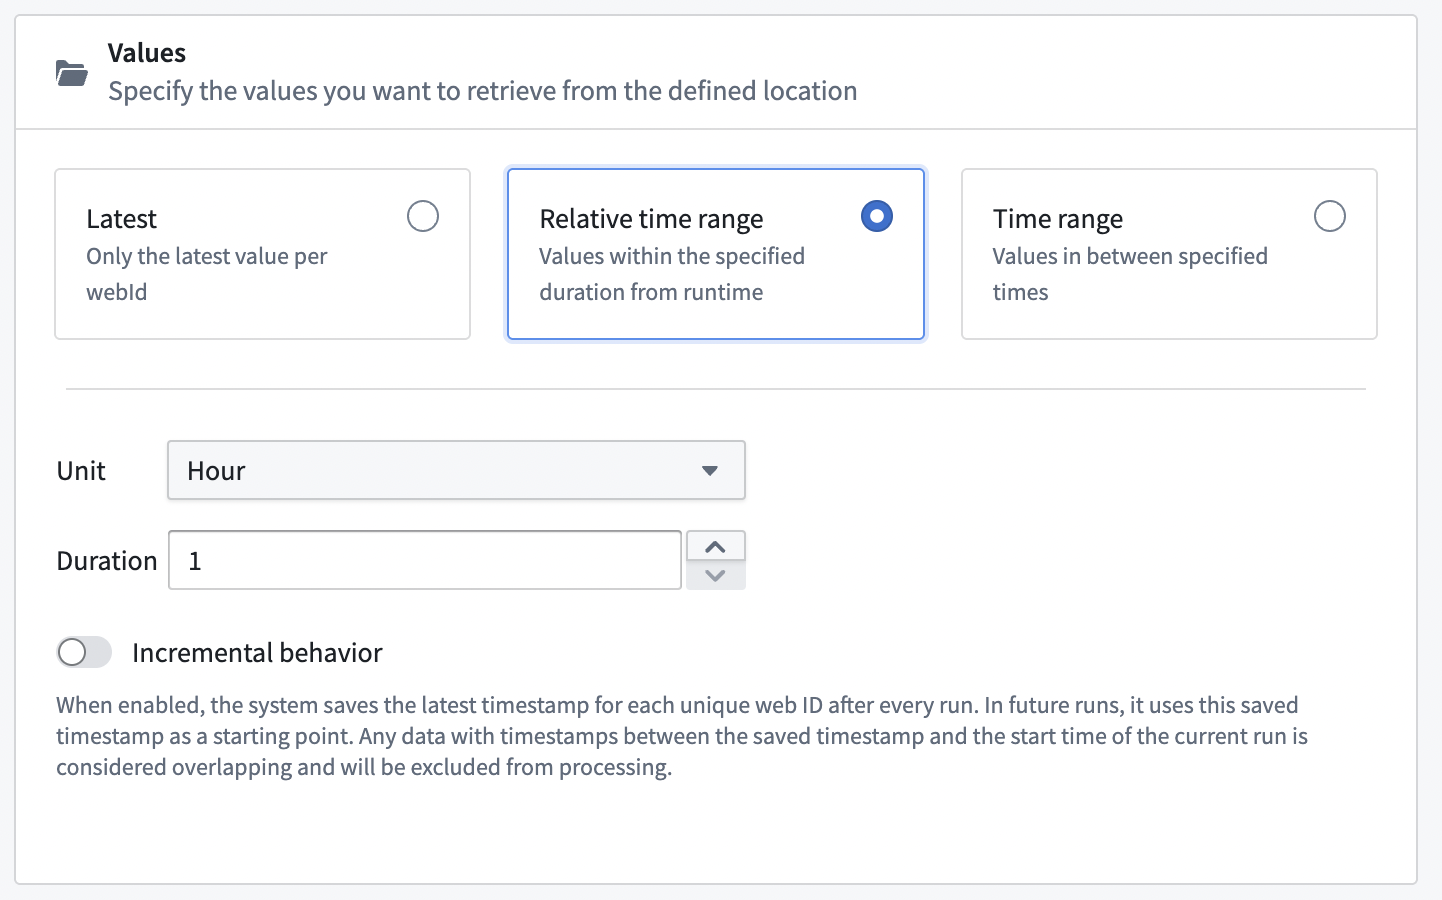
絶対または相対時間ウィンドウ内の値を取得する場合、インクリメンタル設定を利用できます。有効にすると、実行のたびに、一意の WebID ごとに最新のタイムスタンプが保存されます。以降の実行では、保存されたこのタイムスタンプが開始点として使用されます。保存されたタイムスタンプから現在の実行の開始時刻までのタイムスタンプを持つデータは、重複していると見なされ、処理から除外されます。
ファイルのパーティション分割
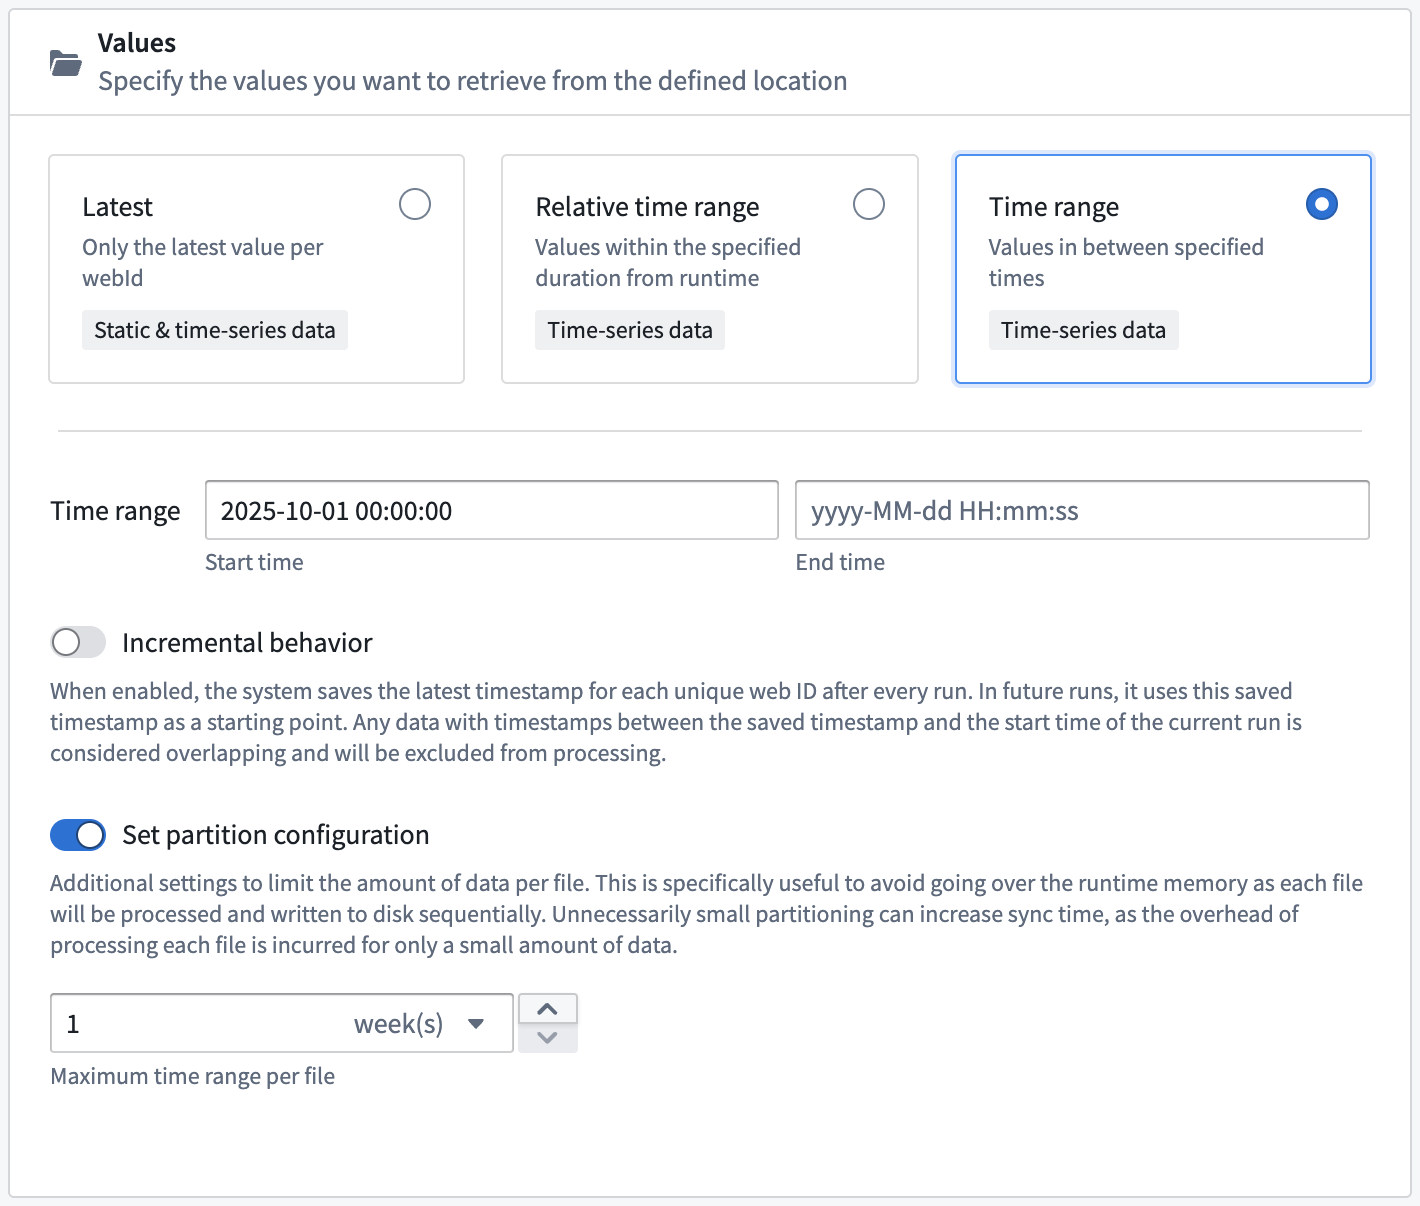
絶対または相対時間ウィンドウから値を取得する場合、パーティションの設定を指定できます。パーティションの構成を設定を有効にすると、PI System は設定されたウィンドウ内のデータを取得し、実行時のメモリー容量を超えないように、データを順次ディスクに書き込みます。
Web ID のキャッシュ
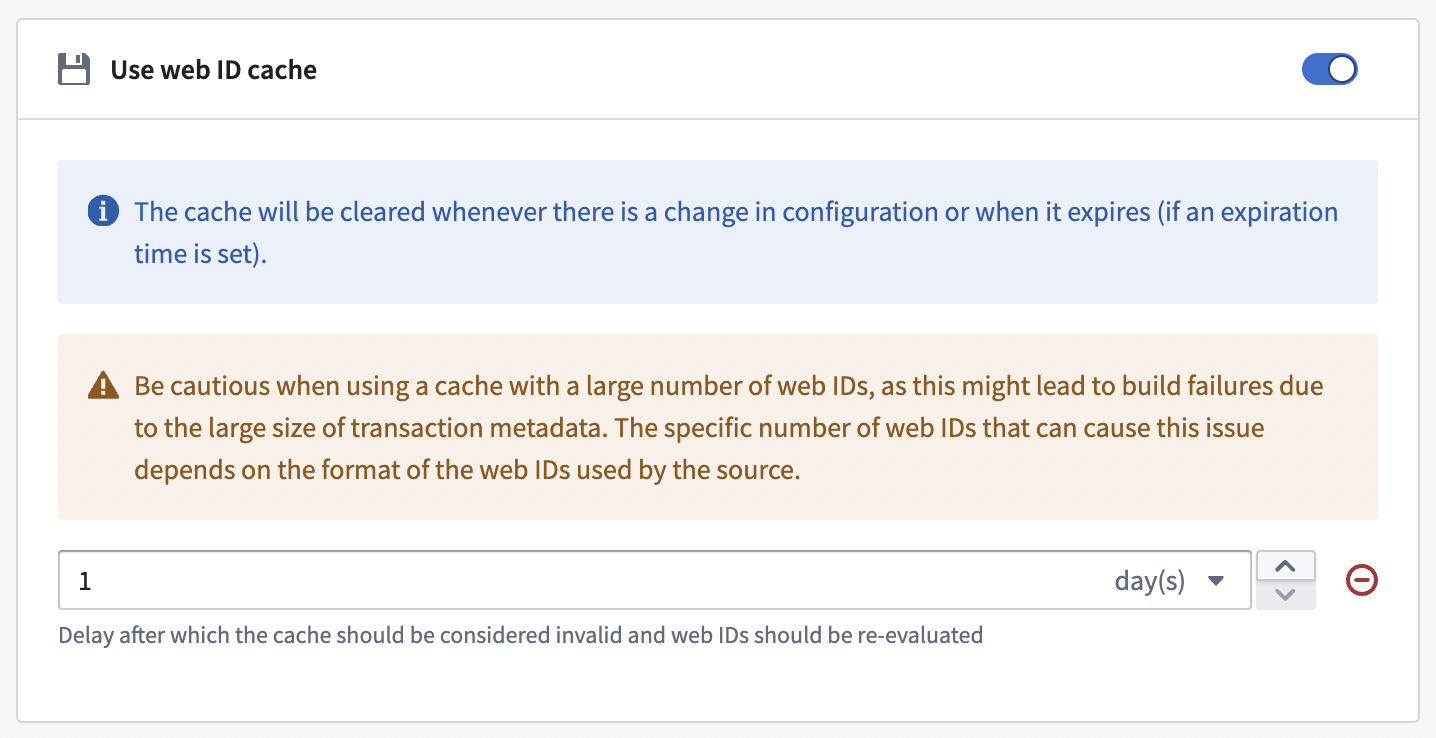
上記のデータモデルで説明したとおり、最初のステップは WebID ↗ を解決することです。この操作は時間がかかる場合があり、PI サーバー側に変更がなければ同じ処理の繰り返しになります。繰り返し行う同期を高速化するために、WebID のキャッシュを有効にして、解決済みの WebID を保存し、次回の実行時にこのキャッシュを再利用できるようにします。
キャッシュを最新の状態に保つために、2つの仕組みがあります。
- 同期設定が変更されるたびにキャッシュを無効化します。
- 任意の有効期限を設定し、それを過ぎたキャッシュは古いものと見なします。
ストリーミング機能
ストリーミング同期では、チャネル ↗を使用して、サーバーからタイムリーに更新を取得します。
生存確認
サーバーとの接続が引き続きアクティブであることを確認するため、コネクターは定期的に生存確認を行い、サーバーから送信された実際のメッセージまたは空のメッセージ(「ハートビート」)を最近受信したことを確認します。これにより、ストリームを再開できます。そうでなければ、以前の接続が通知なく閉じられていた場合、新しい接続を確立する必要があります。
Web ID キャッシュと対象の再評価
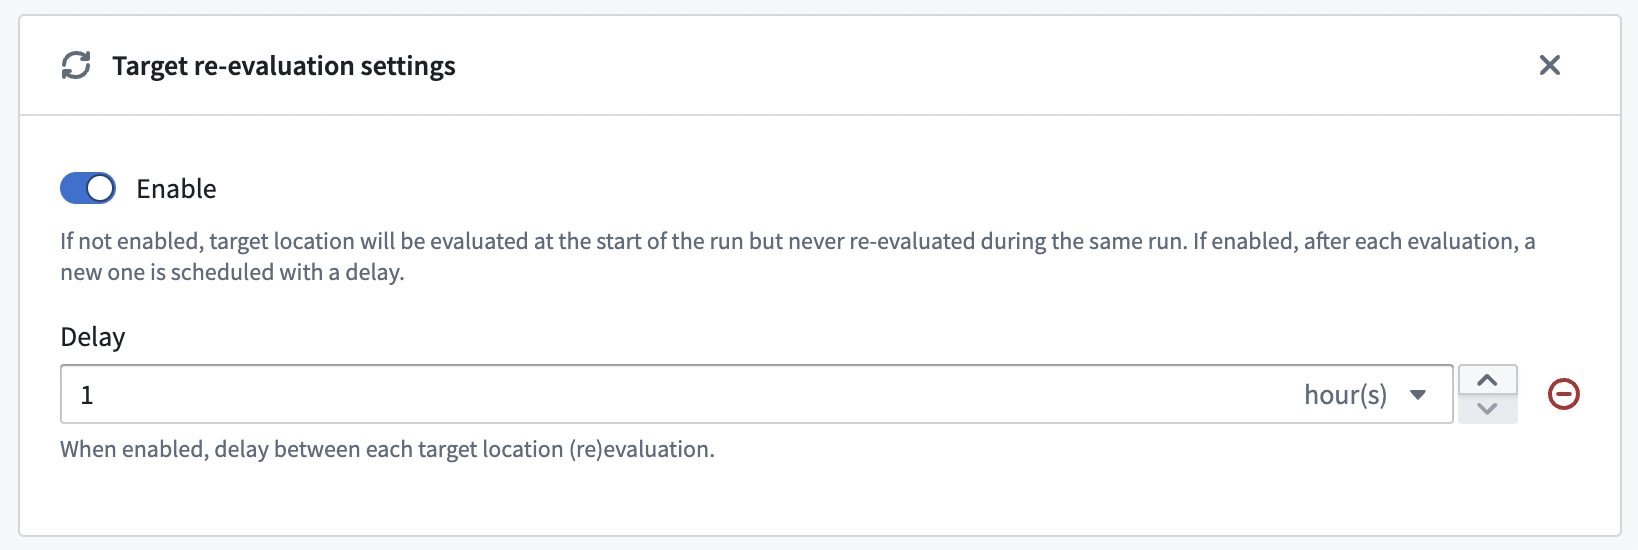
初回起動時に、コネクターは WebID を解決してキャッシュに保存します。このキャッシュは、再起動時にサーバーへの接続を迅速に復元するために使用されます。また、最新の WebID リストを取得するために、キャッシュは定期的に再評価されます。この定期的な再評価を無効にしたり、その頻度を変更したりできます。
バックログの設定
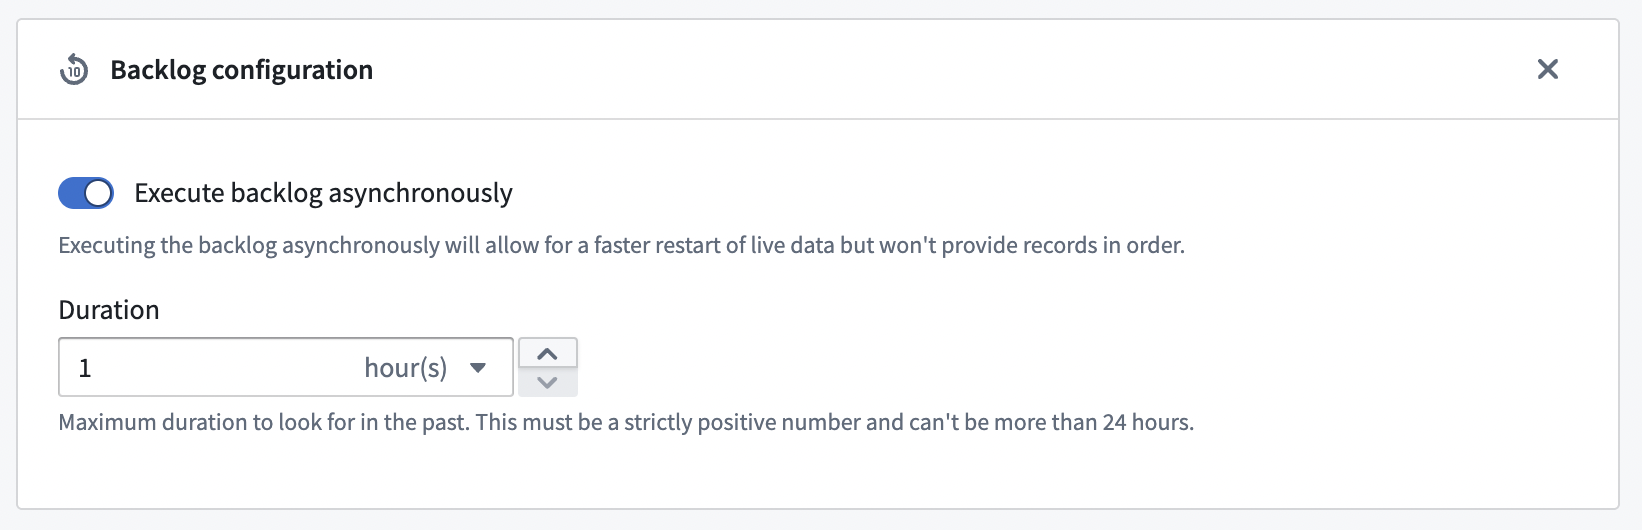
ストリームは、Agent の再起動、接続の切断、手動キャンセルなど、さまざまな理由で停止および再開する場合があります。このような場合、接続が再確立されるまでに短い時間がかかることがあります。データの欠落を防ぐために、バックログを有効にして、この間に取り逃したデータを取得できます。
PI コネクターと REST API コネクターの比較
REST API コネクターのほうが柔軟に対応できる場合もありますが、PI コネクターを使用する利点には以下のようなものがあります。
-
使いやすいインターフェース: PI コネクターには、PI の概念に関する知識だけで使える、クリック操作のインターフェースがあります。一方、REST API コネクターで外部トランスフォームや通常の同期に使用するデータを取得するには、Web API、各種エンドポイント、クエリ形式に関する知識が必要です。
-
すぐに使用できるデータ: PI コネクターの同期では、すでにパースされ、そのまま使用できる表形式のデータが出力されます。REST API は JSON オブジェクトを出力するため、下流のトランスフォームで使用する前にパースする必要があります。そのため、レスポンス形式に関する追加の知識が必要です。
-
ストリーミング同期: PI コネクターではストリーミング同期を設定できますが、REST API では設定できません。
-
標準搭載の「スマート」な機能: バッチ機能のセクションで説明したとおり、PI コネクターに搭載されている機能を使用すると、これらの機能がなければ複雑なオーケストレーションが必要になる操作を実行できます。 PI コネクターには、よくある落とし穴を回避するのに役立つ機能が暗黙的に備わっており、数段階のページネーションとバケット化によって、データを効率的かつ動的に取得できます。これは、API のレート制限に達することなく大量のデータを取得するうえで有用です。特に、REST API のバッチエンドポイントはレート制限に達しやすく、通知なく失敗する可能性が高いことを考えると、役立ちます。